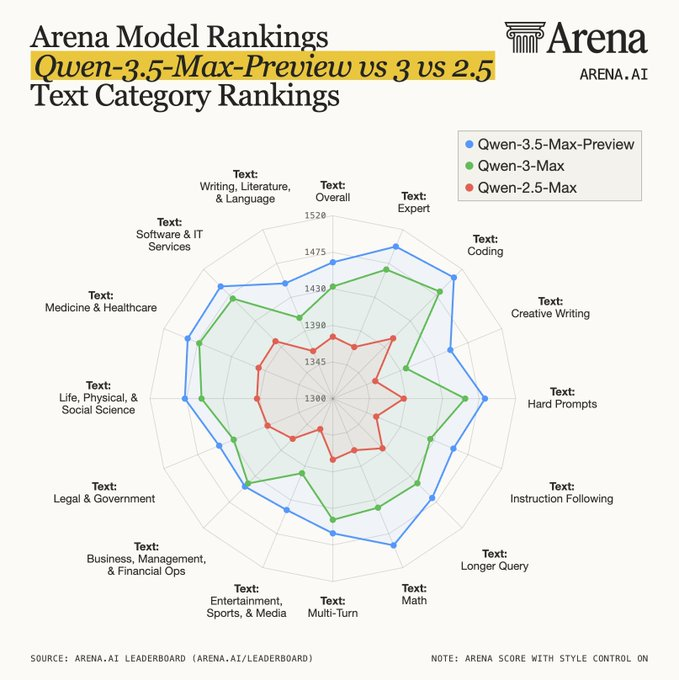
3月20日消息,阿里巴巴Qwen团队的旗舰闭源模型Qwen3.5-Max-Preview已于3月19日正式登陆Arena(原LMArena)文本排行榜,这是Qwen3.5系列最高规格模型首次接受全球社区盲测评估。Arena官方同步发布了代际对比雷达图,3.5-Max-Preview在全部15个文本类目上均大幅超越Qwen-3-Max和Qwen-2.5-Max。完整正式版Qwen3.5-Max预计将在近期发布。
Arena雷达图实证:三代同框,跃升一目了然
根据Arena.ai官方发布的文本类目排名雷达图(Style Control开启),Qwen-3.5-Max-Preview(蓝线)相比Qwen-3-Max(绿线)和Qwen-2.5-Max(红线)实现了全维度大幅跃升。
在Expert(专家榜)维度上,Qwen-3.5-Max-Preview的Elo分数达到约1520,是所有类目中的最高点之一,大幅领先Qwen-3-Max(约1430)和Qwen-2.5-Max(约1345)。数学(Math)同样是突出强项,蓝线接近雷达图最外圈,显示出极强的数理推理能力。
编码(Coding)、Hard Prompts(高难度提示)、指令遵循(Instruction Following)三个维度上,3.5-Max-Preview均显著超越前两代。在创意写作(Creative Writing)、多轮对话(Multi-Turn)、长查询(Longer Query)等偏体验类维度上也保持稳定领先。
值得注意的是,即便在Qwen系列传统短板(如娱乐/体育/媒体、法律与政府等)上,3.5-Max-Preview也已将Elo拉升至1400+区间,整个蓝色多边形接近正圆形,模型能力趋于均衡且全面。而Qwen-2.5-Max(红线)的多边形面积最小,大部分维度在1300-1370之间,代际进步一目了然。
从开源基座到闭源旗舰
Qwen3.5系列于2026年2月16日首发,首批推出的是397B总参数、17B激活参数的旗舰MoE开源模型Qwen3.5-397B-A17B,随后陆续发布了122B-A10B、35B-A3B、27B以及0.8B至9B的小尺寸系列。此次上线的Qwen3.5-Max-Preview是在开源基座之上进一步优化的闭源托管版本,代表了该系列的最高能力水平。
架构革新:混合注意力+稀疏MoE
Qwen3.5采用Gated Delta Networks线性注意力与稀疏混合专家(MoE)结合的混合架构,带来了显著的效率优势。397B总参数中每次前向传递仅激活17B——相比同等能力的稠密模型,激活内存降低约95%。Gated DeltaNet层与全注意力层以3:1比例交替排列,使得序列长度扩展接近线性,支持高达1M上下文窗口而无需承受传统Transformer的二次方内存开销。
这一架构使推理吞吐量相比前代实现大幅提升,API调用成本也随之大幅下降。
原生多模态与201种语言覆盖
Qwen3.5是原生多模态Agent模型,在数万亿多模态Token上进行早期融合训练,同时实现了跨代平齐Qwen3的文本能力并超越Qwen3-VL系列的视觉理解水平。语言支持方面,Qwen3.5将覆盖语种从上一代的119种扩展至201种语言和方言,重点增强了低资源语种的能力。
基准测试:数学与指令遵循尤为亮眼
从已公开的Qwen3.5系列基准数据来看,旗舰开源版在AIME 2026上得分91.3,HMMT Feb 2025上达到94.8;在指令遵循方面同样突出,IFBench得分76.5,超越GPT-5.2的75.4和Claude的58.0;MultiChallenge得分67.6,大幅领先GPT-5.2的57.9和Claude的54.2。作为闭源托管版的Max-Preview,预计性能将进一步高于开源基座,这与Arena雷达图中数学和指令遵循维度的强势表现相互印证。 如何体验
目前有三种方式可以使用Qwen3.5相关能力:前往Arena.ai对Qwen3.5-Max-Preview进行盲测。
 AI 速览