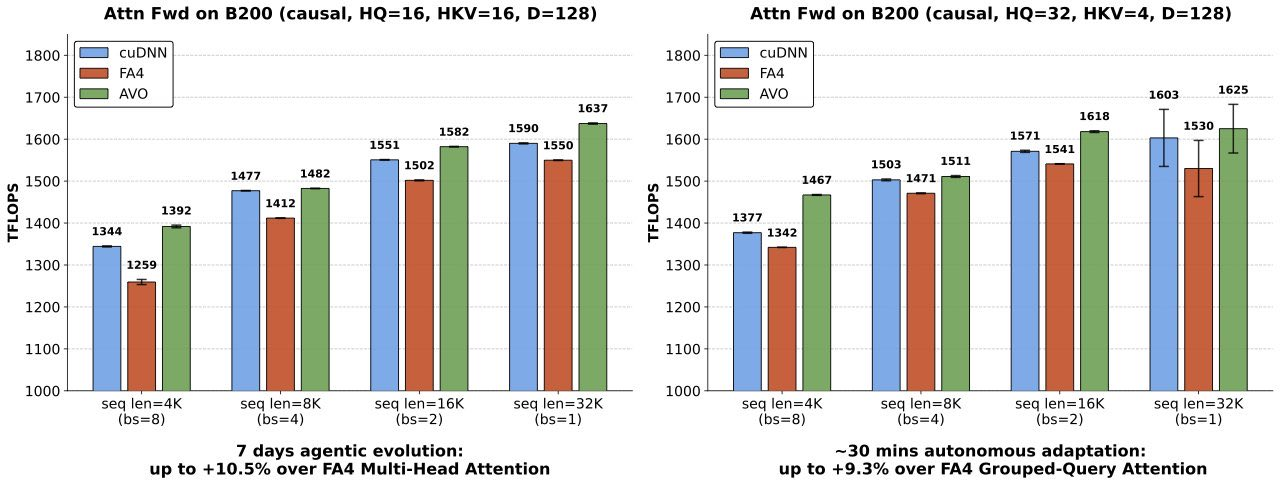
3月25日,英伟达(NVIDIA)在arXiv发布了一篇重磅论文,提出了名为"Agentic Variation Operators"(AVO,智能体变异算子)的全新进化搜索框架。该系统用自主编码Agent替代了传统进化搜索中的固定变异和交叉操作,在NVIDIA最新的Blackwell B200 GPU上,7天无人干预的连续进化中,生成的Attention内核性能超越了cuDNN最高3.5%,超越FlashAttention-4最高10.5%。
从"候选生成器"到"变异算子":AVO的核心突破
此前,Google DeepMind的AlphaEvolve、FunSearch等系统虽然将大语言模型引入进化搜索,但LLM的角色被限制在"候选生成"这一步——在固定流程中生成单次输出,无法主动查阅文档、运行测试或根据反馈迭代修改。AVO打破了这一限制,将AI Agent从流水线中的一个节点提升为完整的变异算子:Agent可以自主决定何时查阅CUDA/PTX文档、何时分析性能瓶颈、何时编写和测试代码修改,以及何时提交最终优化方案。
AVO的技术架构由主Agent和监督Agent两部分组成。主Agent执行"规划→实现→评估→修复"的自主循环,持有完整的解决方案历史记录、领域知识库(包含CUDA编程指南、PTX指令集文档、Blackwell架构规格和FlashAttention-4源码)以及评分函数。监督Agent负责监控主Agent的进展,当检测到停滞时介入并引导搜索方向。
实验结果:在最难优化的领域击败人类专家
Attention机制是Transformer架构的核心操作,也是GPU上被优化得最彻底的计算内核之一。FlashAttention系列和NVIDIA的cuDNN库经过数月的手工优化,已将Attention吞吐量推进到接近硬件极限。AVO选择在这一最具挑战性的领域进行验证。
在BF16精度、head维度128的多头注意力(MHA)前向传播测试中,AVO在B200 GPU上取得了以下成绩:因果注意力(causal)场景下,所有测试配置均超越两个基线,相比cuDNN提升0.4%至3.5%,相比FA4提升5.0%至10.5%,最高达到1668 TFLOPS;非因果注意力场景下,在较长序列长度上实现1.8%至2.4%的提升。
更值得关注的是迁移能力:将已进化的MHA内核适配为分组查询注意力(GQA)仅需30分钟的额外自主运行,即可在GQA上实现对cuDNN最高7.0%、对FA4最高9.3%的性能提升,证明Agent发现的优化策略具有跨场景泛化能力。
Agent发现了什么:三个代表性优化
论文详细分析了Agent在40个版本迭代中发现的优化,其中三个最具代表性。
第一个是"无分支累加器重缩放"(版本20),贡献了单次最大的性能提升。Agent识别出在线softmax算法中的条件分支引入了不必要的warp同步开销,将其替换为始终计算缩放因子、在不需要时乘以1.0的无分支路径。这不仅消除了分支开销,还使得Agent能用更轻量的非阻塞内存栅栏替代重量级阻塞栅栏,在非因果注意力上一次性提升了8.1%的吞吐量。
第二个是"纠正/MMA流水线重叠"(版本30),将原本串行的双Q阶段纠正操作重构为流水线执行。第三个是"跨warp组的寄存器重平衡"(版本33),Agent通过分析profiler数据发现纠正warp组因寄存器预算不足而溢出到慢速本地内存,将寄存器分配从192/80/48调整为184/88/56,在非因果注意力上提升了2.1%。
这些优化的共同特点是需要跨多个硬件子系统进行联合推理——同步与内存排序、流水线调度、寄存器分配——而非孤立地调整单个参数。
7天进化轨迹:500+探索方向,40个提交版本
在7天连续运行中,Agent内部探索了超过500个候选优化方向,最终提交了40个通过正确性验证且性能有所提升的内核版本。论文观察到几个关键模式:性能提升呈阶梯式跳跃而非渐进改善,五个最大跳跃对应关键的架构转折点;早期版本(v1至v20)贡献了最大的绝对收益,后期版本(v21至v40)通过周期级调度产生更小但累积显著的改进,呈现典型的收益递减规律。
行业意义:AI Agent正在改写底层系统软件的开发方式
值得注意的是,AVO使用的是一个通用编码Agent——论文明确指出"没有为内核优化做任何任务特定的修改",同一个Agent既能处理日常软件工程任务,也能优化GPU内核。论文的两位第一作者Xu Bing和Terry Chen在社交媒体上透露,他们一年半前在NVIDIA开始这项研究时甚至不懂GPU编程,因此从一开始就致力于开发完全自动化的系统。
AVO的出现标志着AI Agent在底层系统优化领域的能力已达到一个新水平。与Google AlphaEvolve将LLM限制在固定流水线中的方法相比,AVO赋予Agent完全自主权,使其能够像人类性能工程师一样进行持续的迭代优化。Meta此前发布的KernelEvolve也在探索类似方向,但主要聚焦于跨硬件平台的Triton内核生成,而AVO直接在最难的CUDA/PTX层面与cuDNN等闭源库正面竞争。
该论文作为预印本发布,尚未经过同行评审。AVO框架目前在单一谱系(single-lineage)设置下运行,论文作者表示种群级分支和存档管理将留待未来扩展。由于AVO作为变异算子而非绑定在特定领域的系统,其方法可推广到注意力内核之外的其他性能关键型软件系统。
论文信息: arXiv:2603.24517v1,2026年3月25日提交,作者团队来自NVIDIA。
 AI 速览