搭一个个人知识管理系统,需求其实挺朴素的:把Notion里的笔记同步到本地,用大模型帮你挖掘内容关联,顺手把文章排版好发公众号。
就这么几件事,把国产主流模型挨个测了一遍。测完之后的感受是:网上吹得再凶,落到具体任务上,差距大得有点出乎意料。
第一梯队:GLM-5,真香,但真烧钱
智谱2026年2月发布的GLM-5是目前国产模型里最能干的,这个结论在实测里得到了比较充分的验证。
它能理解系统性规划,写出来的代码更干净,上下文记忆比前代强不少。同样是写Python脚本处理Notion数据,GLM-5能一次跑通,之前用GLM-4.7经常写到一半开始胡编变量名,或者干脆绕路走。能处理复杂系统工程和长程Agent任务,是官方主打的卖点,实测下来确实有这个底气——跑了两个多小时的任务也没乱掉。在编程测试CC-Bench-V2上,GLM-5构建成功率达到98%,整体对标Claude Opus 4.5。 问题在于:它用额度用得太快了。
买了GLM Coding Plan,一周不到,额度干掉了83%,也就是写写脚本、提提问,没上什么高并发任务。后来查了才发现,官方说明里有一行小字:高峰期调用GLM-5会以更高倍率消耗额度,低峰期也要翻倍。更头疼的是,2026年2月12日GLM直接宣布Coding Plan整体涨价,新用户涨幅30%起。
所以现在养成了一个习惯:让模型把阶段性进度写入文件,立刻重开对话。既省钱,又能避免上下文"变脏"——对话越长,模型就越容易忘记之前的约定,或者开始编造不存在的函数。
第二梯队:Kimi K2.5,聪明,但需要盯着
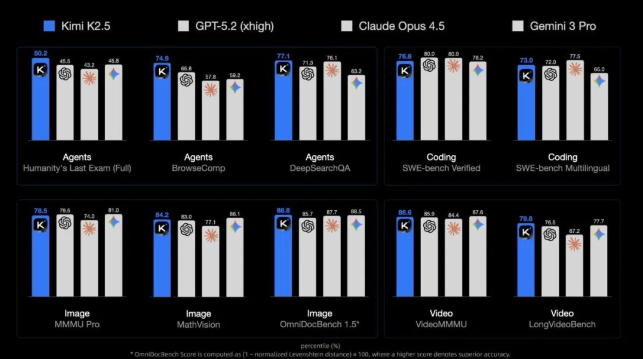
月之暗面2026年1月发布的Kimi K2.5比原来预期的要好不少,总参数1万亿,激活参数320亿(MoE架构),上下文窗口256K tokens。它能发现一些GLM忽略的bug,做的计划也比较详细,多模态是个加分项,把UI设计图发给它,可以直接生成前端代码。
核心问题是稳定性。复杂的Agent指令有时候需要跑30分钟才能看到结果,偶尔会在中途停转,遇到有明显矛盾的指令也会直接响应,不问清楚就先干。你让它按计划执行任务,前几步正常,到了某一步可能就开始自由发挥,提醒了道个歉,然后继续。这种体验挺消耗精力的,你得时刻盯着有没有跑偏。
它更适合短链条任务或者多模态场景,比如截图生代码、视频内容分析。长链条的复杂系统开发,出错了你不一定第一时间发现。
第三梯队:免费工具,能凑合但别指望太多
VSCode上白嫖的免费Copilot能干点活——前提是你只拿它当代码补全工具。按Tab补全一行,它挺在行。但如果你想让它理解整个项目结构、按计划推进、和你来回沟通,它会让你怀疑人生。它的定位是打字机,不是程序员。 豆包没测,暂时对字节的文字生成模型不太放心。Minimax配OpenCode网上评价不错,在待测清单里,如果你试过,欢迎分享真实体验。 一个反直觉的感受:大模型其实不太适合写代码
测了这些模型之后,最大的感受有点反直觉:大模型能写代码,但本质上不擅长写代码。
原因在于代码对"上下文一致性"的要求极高——一个变量名写错,整个程序就崩了。但大模型的记忆机制天生就不擅长维持长链条的严格一致性。一般来说,对话超过20轮,模型就开始"变脏":忘了之前的约定,编造不存在的函数,或者把变量名搞混。这不是某个模型的特有问题,是架构层面的固有缺陷。
所以现在的工作流是:把大模型当成"需要大量脚手架的初级程序员"来用。
必须让它把记忆写入文件,不能只靠对话上下文;执行完一个阶段,立刻保存进度,重开对话;复杂任务拆成小任务,每次只让它干一件事。
这不是什么"正确用法",这是绕过缺陷的妥协。
到底选哪个?
轻量任务(翻译、摘要、打标签):GLM-4-Flash这类免费或便宜的模型,速度快,够用。
中等复杂度(写脚本、处理数据):Kimi K2.5性价比还行,但要做好"盯防"的心理准备,别让它跑偏了。
高复杂度(系统开发、多文件协作):GLM-5目前是国产里最能打的,但务必避开高峰期,用量也要控制,否则账单会让你后悔。
说句实话:GLM-5和Kimi K2.5的发布,国产模型确实缩小了和Claude的差距,这个速度比两年前快多了。但"能用"和"好用"之间还有一段距离,至少在长程复杂任务的稳定性上,Claude目前依然占优势。这个判断不一定还能再撑多久了。
 AI 速览