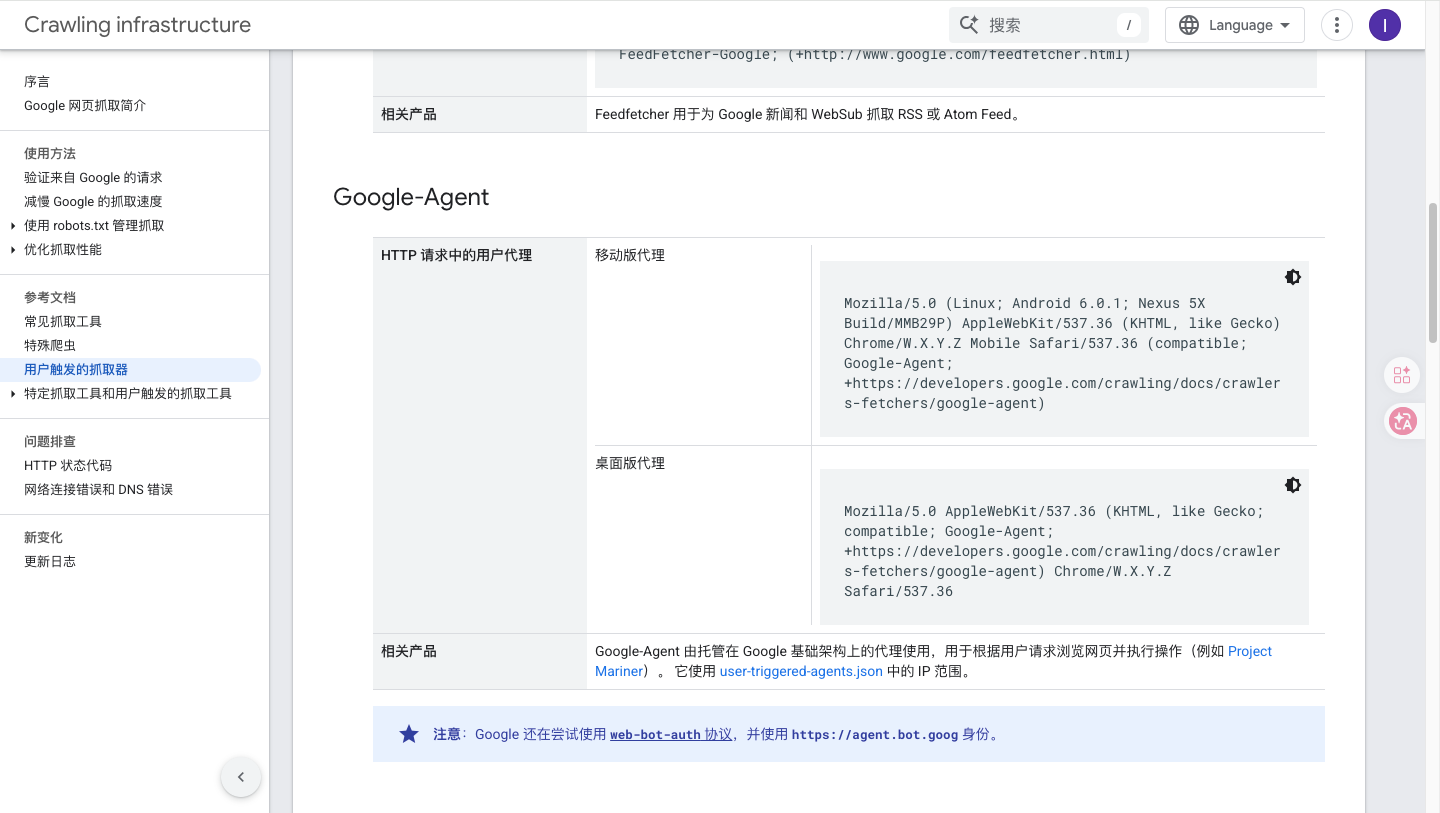
3月27日消息,Google 近日将 Google-Agent 正式加入其官方用户触发型抓取器(user-triggered fetchers)文档,标志着 AI 智能体流量在互联网中首次获得正式身份标识。
什么是 Google-Agent?
Google-Agent 用户代理正在未来几周内逐步上线,将由托管在 Google 基础设施上的 AI 智能体使用,代表用户浏览网页并执行操作。与传统的 Googlebot 持续在后台自动抓取网页不同,Google-Agent 出现在 HTTP 请求中时,意味着有真实用户主动指派了一个 AI 智能体去完成任务,例如浏览页面、评估内容或提交表单。
Google 在文档中明确将 Project Mariner 列为使用示例。Project Mariner 是 Google DeepMind 开发的研究原型,基于 Gemini 2.0 模型,以 Chrome 扩展形式运行,能够理解屏幕内容(包括图像、代码、表单等),自主规划步骤并在网站间导航完成任务。 与此同时,Google 在 Chrome 中推出了由 Gemini 3 驱动的 auto browse 功能,具备代理式浏览能力,可以为用户自动填写表单、比较酒店航班、筛选搜索结果。Google-Agent 用户代理正是为这类 AI 浏览行为提供统一的身份标识层。
技术亮点:Web Bot Auth 协议
Google 正在试验 Web Bot Auth 协议,使用 https://agent.bot.goog 作为身份标识。这是一项 IETF 标准草案,通过加密方式验证机器人和智能体的身份——智能体会用私钥对 HTTP 请求进行签名,而非仅依赖容易伪造的 user-agent 字符串。
目前 Akamai、Cloudflare、Amazon(AgentCore Browser)等提供商已支持 Web Bot Auth,而 Google 作为全球最大的爬虫运营商加入,将带来关键的规模效应。这意味着网站运营者未来可以通过密码学手段实时验证访问请求是否真正来自 Google 智能体,而不再需要依赖繁琐的反向 DNS 查询。
对行业的影响
Google 是首个让智能体流量可识别、可区分的科技巨头,这与 OpenAI 的 Operator 和 Anthropic 的 Claude-in-Chrome 尚未独立标识自身的做法形成鲜明对比。 对网站运营者和 SEO 从业者而言,这一变化意义深远:服务器日志中将首次出现可明确区分的 AI 智能体流量,网站管理员需要确保 CDN 和 WAF 配置不会错误拦截 Google-Agent 的 IP 范围,并验证关键的表单和业务流程对自动化智能体正常运作。
更大的格局
尽管近期有报道指出 Google 正因编程智能体(如 OpenClaw)的快速崛起而重新调整 Project Mariner 的资源优先级,但 Google-Agent 用户代理的正式发布表明,浏览器级 AI 智能体的基础设施建设并未停滞——Google 选择了将其标准化、制度化,让整个互联网为智能体时代做好准备。
Chrome 还将支持 Google 与 Shopify、Etsy、Wayfair、Target 等行业伙伴共同开发的通用商务协议(UCP),确保 AI 智能体能在 Chrome 中代表用户无缝完成交易操作。
AI 智能体是否会成为日常网络流量的一部分,已经不再是问题。Google-Agent 的推出宣告:这个时代已经到来。
 AI 速览