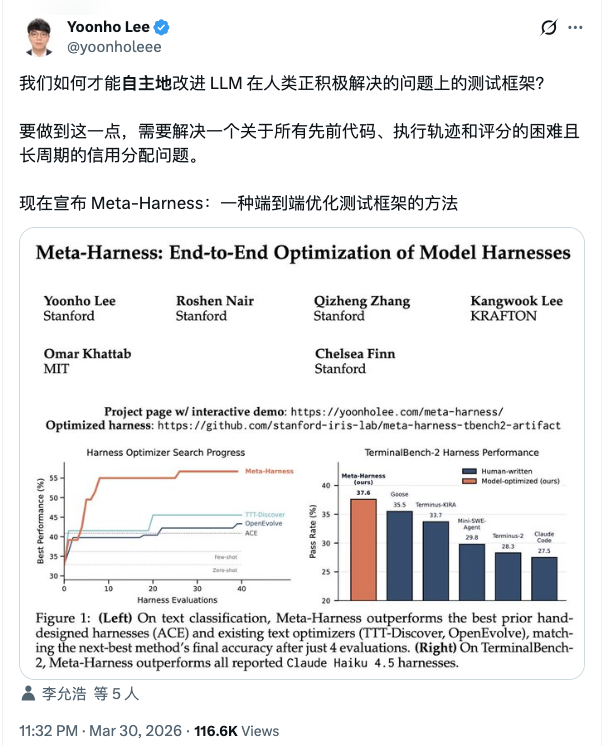
3月30日斯坦福大学AI实验室博士生Yoonho Lee联合Chelsea Finn、Omar Khattab等人发布了一项名为Meta-Harness的研究,提出了一种端到端自主优化LLM Harness(评估/测试框架)的全新方法。该研究在文本分类、数学推理和代理编码三大任务上均取得显著提升,其中在TerminalBench-2基准的Haiku 4.5模型上排名第一,Opus 4.6模型上排名第二。
什么是Harness?为什么它比模型本身更重要?
Harness是包裹在大语言模型外层的完整软件基础设施,包括系统提示词、工具定义、上下文管理、检索策略、编辑格式等所有"模型之外"的工程组件。2026年2月Can Bölük的实验已经证明,仅改变Harness中的编辑格式,就能让15个LLM的编码性能提升5到14个百分点,且输出token减少约20%。OpenAI工程团队也公开表示,当前最困难的挑战已经从模型训练转向"设计环境、反馈循环和控制系统"。换句话说,同一个模型在不同Harness下的表现差异,可能远大于不同模型之间的差异。Harness Engineering正在成为AI工程领域最重要的新范式之一。
Meta-Harness的核心创新:完整历史 + 文件系统访问
现有的提示优化方法(如Self-Refine、OPRO、TextGrad、AlphaEvolve等)在每轮迭代中只能看到有限的信息——要么是上一轮的输出和评分,要么是最近几轮的滑动窗口摘要。这些压缩策略在简单任务上够用,但面对Harness工程中那些跨度极长的依赖关系时,会丢失大量关键诊断信息。
Meta-Harness的做法截然不同:它将一个编码Agent(基于Claude Code)作为"提议者",赋予其对完整文件系统的无限制访问权限。这个文件系统包含所有历史候选方案的源代码、执行轨迹和评分。提议者可以使用grep、cat等标准命令自主决定查看哪些内容。实际运行中,提议者每步可访问高达1000万tokens的诊断上下文,而此前所有方法中最多只有2.6万tokens。 这种设计解决了一个经典的长期信用分配问题:当Harness的某次修改导致某个任务失败时,只看评分或摘要几乎无法定位原因,但通过阅读完整的执行日志和错误信息,Agent可以像经验丰富的工程师一样追溯到具体的代码决策。
三大实验场景的具体表现
在文本分类任务中,Meta-Harness发现的最优方案(Label-Primed Query)在三个数据集上达到48.6%的平均准确率,比此前最强的ACE方法高出7.7个百分点,且仅使用四分之一的上下文token。在215类的LawBench上提升了16个百分点,22类的Symptom2Disease上提升了9个百分点。与OpenEvolve和TTT-Discover两种代表性程序搜索方法相比,Meta-Harness用十分之一的评估次数就达到了它们的最终准确率,最终得分高出10个百分点以上。
在数学推理任务中,Meta-Harness优化了一个检索增强的推理Harness,在200道IMO级别的数学题上,五个未参与搜索的模型平均提升了4.7个百分点(从34.1%到38.8%)。关键是这个Harness在搜索阶段从未见过这些测试模型,证明了优化结果的迁移能力。
在代理编码任务中(TerminalBench-2基准,89个Docker化任务),Meta-Harness在Claude Opus 4.6上达到76.4%的通过率,排名所有Opus 4.6 Agent中第二位;在Claude Haiku 4.5上达到37.6%,排名第一,超越了Goose(35.5%)和所有其他竞品。TerminalBench-2是当前评估AI编码Agent最权威的基准之一,涵盖代码翻译、分布式ML配置、系统编程、生物信息学和密码分析等真实工作流任务。 工作机制详解:迭代搜索循环
Meta-Harness的运行流程分三步循环执行。第一步,提议者Agent读取文件系统中所有历史候选方案的源代码、执行轨迹和评分,然后提出一个新的Harness方案。第二步,新方案在留出的评估任务上运行测试。第三步,所有日志(提议代码、推理轨迹、评估分数)被存入文件系统的新目录,循环继续。
在实际运行中,提议者的行为高度类似人类工程师:它会中位数阅读82个文件,对执行轨迹进行反事实诊断,识别具体的失败模式,然后提出有针对性的假设和修复方案。例如在TerminalBench-2的一次搜索中,从Terminus-KIRA的28.5%基线起步,经过7轮迭代达到46.5%。每轮迭代中,提议者会明确说明为什么新方案比旧方案更安全、更有效,而不是盲目试错。
与相关工作的关系
Meta-Harness与此前的AutoHarness(Google,2026年2月发布)形成了有趣的互补。AutoHarness关注的是在游戏环境中自动生成防止非法动作的Harness,属于"约束层"优化;Meta-Harness则面向更广泛的Harness工程场景,对系统提示、工具定义、上下文管理等全部组件进行端到端优化,属于"全栈"优化。两者共同指向一个趋势:AI系统的性能瓶颈正从模型本身转向模型与外部世界的接口层。
对开发者和行业的意义
Meta-Harness的核心启示在于:不改模型权重,仅优化Harness就能获得显著的性能提升。这意味着对于使用API调用模型的开发团队来说,投入Harness工程的回报可能远高于等待下一代模型发布。论文代码已在GitHub开源(stanford-iris-lab/meta-harness-tbench2-artifact),项目页面提供了交互式Demo,可逐步查看每轮迭代的代码变更和提议者的推理过程。
研究团队包括斯坦福AI实验室的Yoonho Lee、Roshen Nair、Qizheng Zhang,威斯康星大学的Kangwook Lee,以及Chelsea Finn和Omar Khattab。论文目前为预印本状态,已在AI社区引发广泛关注和讨论。
 AI 速览