4月1日,智谱AI正式发布GLM-5V-Turbo,定位为首个原生多模态Coding基座模型。与传统只接受文本输入的代码模型不同,GLM-5V-Turbo可以直接理解设计稿、截图、网页界面、视频录屏等视觉内容并生成可运行代码,同时深度适配Claude Code和OpenClaw Agent工作流。本文将从核心能力、技术架构、实际场景、接入方式和竞品对比5个方面展开解析。 GLM-5V-Turbo解决什么问题
在实际开发中,"看着设计稿写前端代码"和"截图定位Bug"是高频场景,但此前的AI代码模型只能处理文本输入,开发者需要手动把视觉信息翻译成文字描述再喂给模型,信息损失大、效率低。GLM-5V-Turbo的做法是跳过描述环节——直接把设计稿、截图或录屏丢给模型,由它自行识别布局、配色、组件层级与交互逻辑,然后输出完整的HTML/CSS/JS代码。
智谱官方用一句话概括了这个定位:Agent时代,模型能力由智能水平和能处理的context容量两个维度定义,一个能原生处理多模态context且擅长编程与执行的基座模型,是所有AI原生应用的基石。
3类核心使用场景
GLM-5V-Turbo的官方文档和发布公告给出了3类典型场景。
第一类是设计稿→代码的前端复刻。发送草图、高保真设计稿或参考网站截图,模型直接理解布局和配色并生成完整可运行的前端工程。原型图侧重还原结构与功能,高保真设计稿追求像素级视觉一致性。还支持交互式编辑——按需增删模块、修改文案样式、补充按钮反馈和表单联动等交互逻辑。
第二类是GUI自主探索复刻,这是比"看图写码"更进一步的能力。结合Claude Code框架,GLM-5V-Turbo可以自主浏览目标网站,梳理页面跳转关系、采集视觉素材与交互细节,最后基于探索记录直接生成代码复现整个站点。从"给一张图还原一页"升级到"自己逛完整个站然后全部复刻"。 第三类是为Agent装上"眼睛"。接入AutoClaw等Agent后,模型能直接看懂屏幕信息,将Agent的任务边界从纯文本扩展到视觉交互。官方已上线"股票分析师"Skill作为示例——Agent可以直接看懂K线走势、估值区间图和券商研报图表,实现四路数据源60秒并行采集,输出图文交错的分析报告。
技术架构:4层系统性升级
GLM-5V-Turbo在模型架构、训练方法、数据构造、工具链四个层面做了升级。
原生多模态融合方面,从预训练阶段就将视觉与文本作为一体化数据训练,而非传统的"视觉编码器输出描述→语言模型处理"的管线拼接。新一代CogViT视觉编码器在通用物体识别、细粒度理解、几何与空间感知上均达到最优,MTP多Token预测结构提升了多模态场景下的推理效率。
训练方法上采用30+任务联合强化学习,覆盖STEM推理、视觉定位、视频理解、GUI Agent操控等方向,目的是避免单领域训练导致其他能力退化的"跷跷板效应"。
数据层面,针对Agent训练数据稀缺和难以验证的行业难题,构建了从元素感知到序列级动作预测的多层级体系,基于合成环境大规模生成可控可验证的训练数据,并在预训练阶段注入Agentic元能力。
工具链扩展方面,在文本工具基础上新增多模态搜索、画框、截图、读网页等多模态工具,将Agent的感知-行动链路从纯文本延伸到视觉交互。
模型支持200K上下文窗口、128K最大输出tokens。
评测表现:视觉编码强势但通用编码存在差距
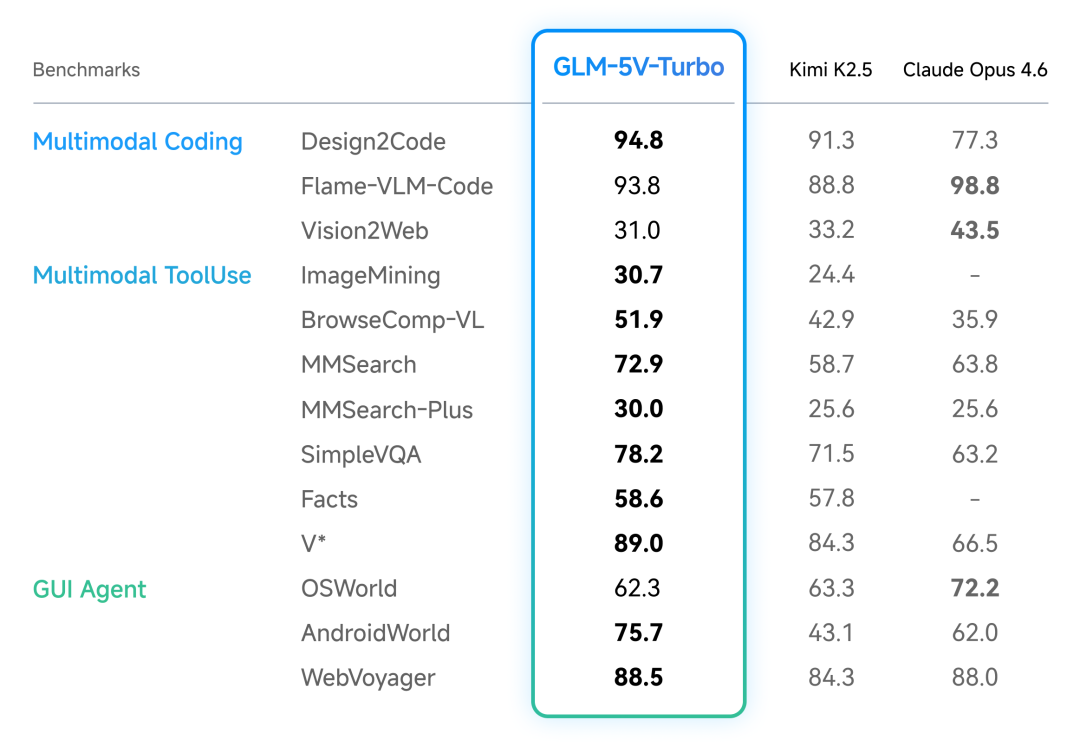
智谱自测数据显示,Design2Code基准得分94.8,Claude Opus 4.6为77.3;GUI Agent基准AndroidWorld和WebVoyager上同样领先;在Agent任务执行基准PinchBench、ClawEval和ZClawBench上取得优异成绩。纯文本编码方面,CC-Bench-V2的Backend、Frontend和Repo Exploration三项测试表现稳定,官方称视觉能力引入未导致文本编程能力退化。
内测阶段,字节TRAE团队评价其"实现了设计稿到代码的完整还原";美团团队认为"原生多模态能力引入未削弱编程逻辑,编程能力仍属国内第一梯队";快手万擎团队称其"为Agent安上了眼睛,视觉编程场景更具竞争力"。
但独立评测给出了重要补充:在纯文本编码任务中Claude在所有项目上仍然领先,GLM-5V-Turbo的核心优势集中在"视觉→代码"这个特定方向(来源:abit.ee评测)。Benchable.ai数据显示模型可靠性达98%成功率,但推理速度处于中等水平,定价偏高端。
Skills生态:ClawHub一键安装
除模型本身外,智谱同步在ClawHub上线了一组官方Skills,分为两类。原生能力类包括图像Captioning、视觉Grounding、基于文档的写作、简历筛选、提示词生成等。工具能力类基于GLM-OCR和GLM-Image构建,覆盖文字识别、表格识别、手写体识别、公式识别和文生图。所有Skills均可在ClawHub一键安装(地址:clawhub.ai/zai-org/glm-master-skill),GitHub源码同步开放(github.com/zai-org/GLM-skills)。
如何接入GLM-5V-Turbo:4种方式
产品体验方面提供两个入口:AutoClaw(澳龙)地址为autoglm.zhipuai.cn/autoclaw,Z.ai对话体验地址为chat.z.ai,均可免费测试模型效果。 API接入方面同样有两个入口:智谱开放平台BigModel(docs.bigmodel.cn)和Z.ai国际站(docs.z.ai),API定价为输入$1.2/百万tokens、输出$4/百万tokens。此外,官方Coding Plan用户可申请接入,后续GLM Coding Plan也将纳入GLM-5V-Turbo。
竞品对比:定位差异大于性能竞争
GLM-5V-Turbo不是Claude或GPT的直接替代品,更准确的定位是Agent工具链中的专用视觉编码组件。在设计稿还原和GUI操控这个窄场景上优势明显,但通用编码、后端开发和复杂工程任务仍需搭配Claude Code等工具使用。官方文档本身也是以"与Claude Code协同"而非"替代Claude Code"的口径来定位的。
同类产品中,Google Gemini 2.5系列支持多模态代码生成,但缺乏针对中文前端设计稿还原的专项评测。此前智谱发布的GLM-5-Turbo(纯文本版)定位为OpenClaw场景的执行引擎,两者构成"文本执行+视觉感知"的互补关系。 对于前端开发团队和UI还原场景,建议先在chat.z.ai或AutoClaw中用实际设计稿做验证,确认效果后再通过API正式接入。对于通用编码需求,Claude和GPT系列仍是更成熟的选择。
 AI 速览