AI视频生成工具越来越多,但大部分工具只解决了"从零生成"这一个环节——你输入提示词,它吐出一段视频。如果画面里多了一个路人需要删掉、如果角色的台词说错了需要改、如果运镜差了点意思需要调整,答案几乎统一:重新生成。
阿里通义实验室最新发布的Wan2.7-Video试图改变这个现状。这不只是一次画质升级,而是把产品定位从"视频生成模型"扩展为"视频创作套件",覆盖生成、编辑、复刻、续写、角色控制、故事板等6大创作环节,支持文本、图像、视频、音频全模态输入。用官方的话说:"让视频像文档一样可编辑。"
目前,Wan2.7-Video已上线阿里云百炼平台和万相官网(tongyi.aliyun.com/wan),开发者可通过API调用,普通用户可在官网直接体验。
能力一:指令P视频——像修图一样修视频
过去想在AI视频里增删一个元素,只能靠改提示词重新跑一遍整个片段。Wan2.7-Video支持通过自然语言指令对视频画面进行局部编辑,编辑后的区域能在光影和材质上与原视频自然融合。
具体支持的操作包括三类。第一类是元素与参考编辑:可以用指令删除视频中的特定物体(如"删掉视频中的火车")、替换物体(如"把胶片替换成盘子")、修改属性(如改变建筑颜色),也可以用参考图像精准添加新元素。第二类是环境与风格变换:在保持人物动作不变的前提下,背景季节可以从夏日变为深秋,也可以一键转换为羊毛毡风格。第三类是辅助功能:包括给黑白画面上色、主体分割、修改对焦方式等。
这个能力的实际价值在于:创作者不需要因为一个小细节的不满意就推倒重来,修改成本从"重新生成整段"降低到"指令微调局部"。
能力二:剧情修改——不用重拍,指令调整台词、动作和机位
对已经拍摄或生成的视频内容,Wan2.7-Video支持在不改变角色身份和场景的前提下,通过指令描述修改剧情内容和拍摄方式。
台词修改方面,可以直接替换角色所讲的台词内容,模型会自动匹配新台词的口型和情绪,并保持音色统一。动作修改方面,可以只改变行为逻辑而保持其他一切不变,比如"坐沙发上的女生变为站着打游戏"。更激进的改动也被支持——比如将游戏玩家替换为中世纪骑士,手中控制器替换为冷兵器,但保持原有握持姿势。机位调整方面,可以修改拍摄相机的设定(机位、视角、景别、焦距等),同一素材呈现截然不同的观影效果。
这意味着AI视频的创作流程从"一次性生成定稿"变成了"先生成再迭代",更接近传统影视后期的工作方式。
能力三:创意快速复刻——动作、运镜、风格一键复用
看到一段绝妙的运镜或动作想要复用?Wan2.7-Video支持对视频中的动态创意进行快速复刻,覆盖动作参考、运镜参考、风格参考和通用参考四个维度。
动作与运镜参考允许保留原视频的动作序列或镜头运动,替换到新场景中——比如"保留原视频运镜方式,场景更改为学校操场",或"保持人物动作序列,改为西西弗正在山上推巨石"。风格与特效参考可以提取视频的风格化表现或粒子特效材质,应用到全新内容中。通用参考则更灵活,可以保留原视频的色彩风格和环境氛围,在此基础上增加新的剧情元素。
对创作者来说,这个功能最直接的价值是:灵感不必从头开始,好的运镜和动作可以变成可复用的"创作模板"。
能力四:剧情续写——首尾帧+续写+尾帧,告别"刹车感"
通过首尾帧控制、视频续写和续写+尾帧三种方式,Wan2.7-Video可以在保证画面连贯的前提下,延展剧情、变换机位或调整节奏。
本次升级重点优化了"视频续写+尾帧控制"这一组合能力——既保留视频动态的自然延续,又能精准把控画面结构。官方表示这有效解决了传统首尾帧方案中常见的"刹车感"(即到达尾帧时动态突然僵硬)以及纯续写模式可控性差的问题。
能力五:角色控制——最多5个主体,专属音色和外貌
Wan2.7-Video支持图像、视频、音频等多模态参考来锁定角色的外观和音色,最多支持5个视频主体同时上传,让每个角色都有专属音色,多镜头间保持特征一致。
官方演示了一个典型场景:通过提示词+图片+参考音频,指定"图2抱着图4,在图5的椅子上弹奏一支舒缓的乡村民谣",同时另一角色"图1手中拿着图3,路过图2",两个角色各自说出指定台词,音色分别与各自的参考音频匹配。这种多角色协同控制的能力,直接面向短剧和广告创作中多角色互动的实际需求。
能力六:故事板控制——一张多宫格图掌控全局分镜
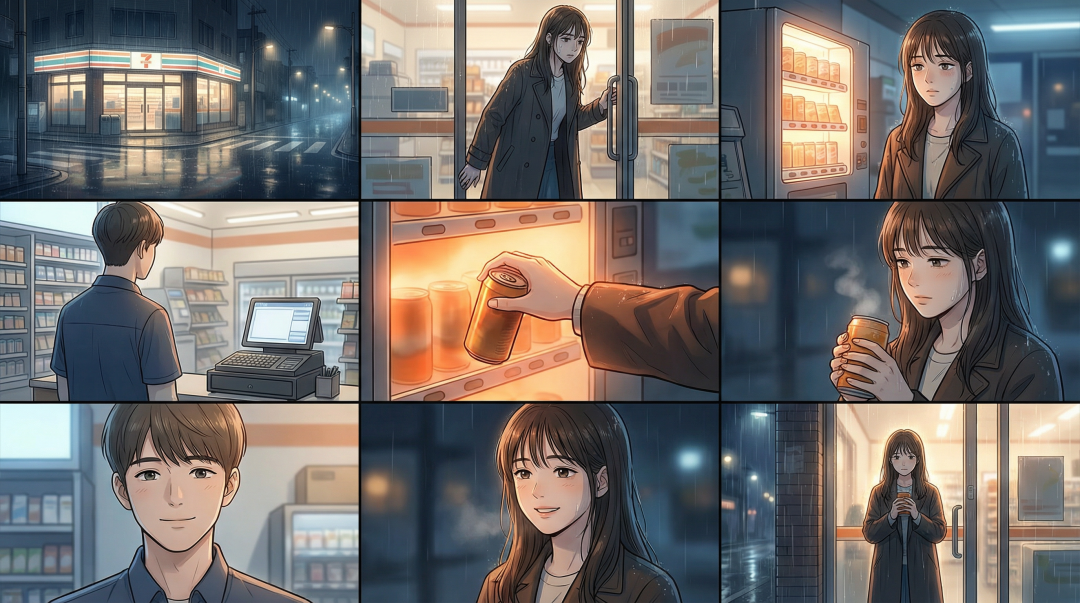
Wan2.7-Video针对多宫格参考图进行了专项优化,一张图就可以实现对故事走向、机位构图和角色设定的精准控制。官方演示了一个9格分镜的韩漫风格便利店短片案例:从全景的雨夜街角,到女主推门进店、店员抬头注视、热饮柜前的停留,再到结尾捧着热饮看雨夜——9个镜头的构图、景别、情绪递进均通过一张故事板+文字描述完成。
这对习惯先画分镜再拍摄的创作者来说,提供了一种全新的工作流:先用分镜草图定义叙事结构,再由AI一次性生成完整的多镜头视频。
底层升级:戏核驱动的创作逻辑
除了6大创作能力,Wan2.7-Video在底层逻辑上也做了一个重要转变——从"单点堆砌画质"转向"戏核驱动的整体创作"。
具体体现在四个维度。智能剧情设计方面,模型学习了大量专业剧本,能根据一句话创意自动构建符合戏剧逻辑的起承转合,生成节奏精准的专业分镜脚本。风格表现方面,Wan2.7建立了以戏核为高级指令的映射关系——指定"西部片"即可获得落日暖调与高对比度光影,指定"科幻片"则获得霓虹与阴影交织的赛博朋克美学,支持上千种风格的自由组合。表演能力方面,不仅支持高兴、悲伤、愤怒等基础情绪,还能演绎超过40种细分表情,台词生成更准确、声音表现更生动。通义实验室语音团队和虎鲸文娱摩酷实验室分别在音频技术和影视表演知识方面提供了支持。运镜方面,支持推拉摇移跟升降等数十种基础运镜,以及希区柯克式变焦、上升揭示、手持跟拍等复合运镜技巧。
万相模型家族的演进脉络
通义万相(Wan)是阿里通义实验室的视频生成模型系列。自2025年2月Wan2.1首次开源以来,该系列经历了快速迭代:Wan2.1实现基础文生视频和图生视频;Wan2.2引入MoE架构,支持消费级显卡运行;Wan2.5首次实现原生音画同步;Wan2.6成为国内首个支持角色扮演的视频模型,支持15秒长视频和多镜头叙事。
截至目前,万相模型家族已支持文生图、文生视频、图生视频、人声生视频、动作生成等10多种视觉创作能力,累计生成3.9亿张图片和7000万个视频,开源模型下载量超过3000万。
Wan2.7-Video的定位,是在前几代积累的生成能力基础上,将重心从"单次生成"转向"全链路创作"——让AI视频从"生成一次看运气"变成"随时可以改、逐步可以精修"的创作工具。
体验入口
阿里云百炼平台:bailian.console.aliyun.com
万相官网:tongyi.aliyun.com/wan
 AI 速览