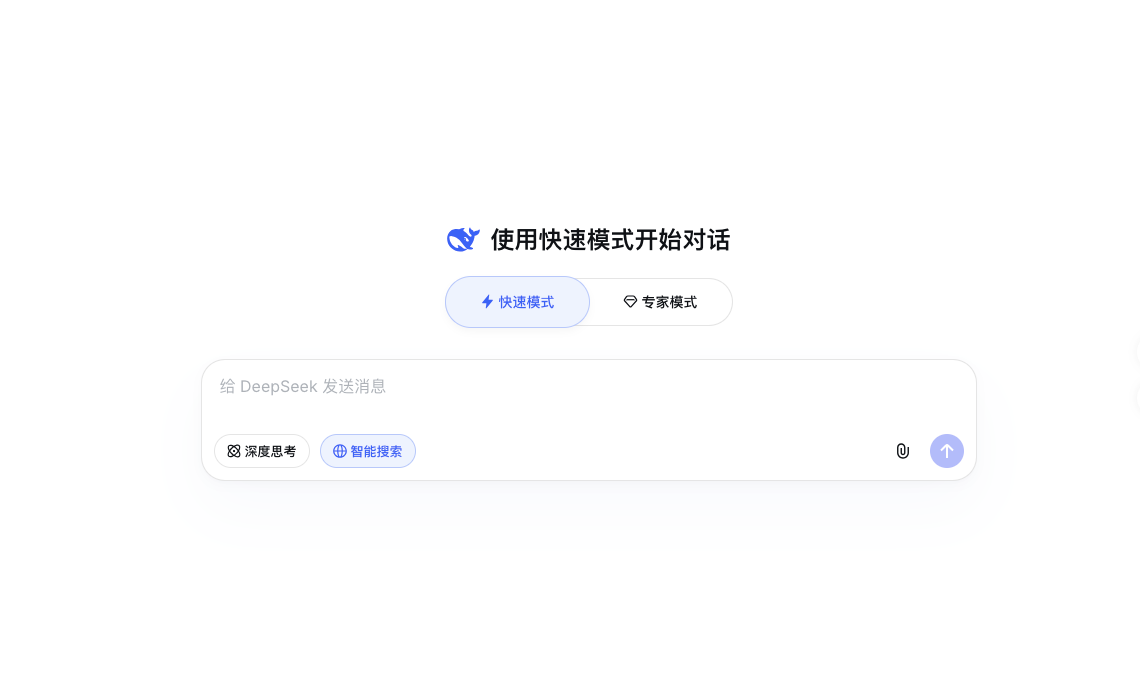
4月8日消息,DeepSeek正在向部分用户灰度推送V4限量版,聊天界面首次出现模式切换器,提供Fast(快速)、Expert(专家)和Vision(视觉)三种模式。这是自2月11日首次开启1M上下文灰度测试以来,DeepSeek在产品端最明确的V4信号。但V4正式发布已三度跳票——从最初的2月中旬春节窗口、到3月第一周、再到4月,至今仍无官方确认的发布日期。 三种模式分别做什么
根据多方的反馈,三种模式的定位明确分层。
Fast模式为默认选项,支持文件上传但仅提取纯文本,定位轻量低延迟、日常无限使用。从社区实测反馈看,该模式响应速度明显快于当前V3系列的671B模型,有开发者推测其参数量可能在200B左右。
Expert模式指向更强的推理模型,但不支持文件上传。这一限制被普遍解读为算力成本控制——大参数模型处理文件token的开销较高。不过社区测试显示,Expert模式的实际性能提升幅度有限,有用户在让模型自述差异来源时得到暗示:主要区别可能来自系统提示词(System Prompt)调整,而非底层推理架构的根本改变。这一发现让部分开发者对Expert模式的技术含金量存疑。
Vision模式支持多模态输入,此前DeepSeek已进行过OCR相关测试,此次是多模态能力首次面向C端用户推出。该模式分层设计与月之暗面Kimi的分级体系类似,有观点推测高性能模式后续可能设置调用频率限制。 灰度测试时间线:从2月到4月
V4的灰度测试并非突然出现,而是经历了一个持续数月的渐进过程。
2月11日是最早的公开信号。多位用户发现DeepSeek网页端和App端的上下文窗口从128K直接提升至1M token,知识库截止日期更新至2025年5月。凤凰网科技、DeepTech等媒体实测确认了这一变化。但API文档并未同步更新,仍保持128K限制,Hugging Face和GitHub上也没有任何新版本发布。业内普遍将这次更新解读为V4基础设施的生产环境测试。
同期,开发者在DeepSeek的FlashMLA开源推理库中发现了代号"MODEL1"的代码标识,其KV缓存布局、稀疏性处理和FP8解码方式与V3.2存在明显差异,指向架构级重构。Meta科学家Zhuokai Zhao分析后认为,MLA+sigmoid+稀疏MoE+共享专家+无辅助损失+DSA+MTP正在成为前沿稀疏专家模型的标准配方。
2月16日,疑似V4的基准测试数据泄露,显示SWE-bench Verified得分83.7%,超越当时的GPT-5.2和Claude Opus 4.5。但这些数据来自内部测试,至今没有第三方独立验证。 3月9日,DeepSeek网站出现模型更新迹象,中文科技媒体报道了改进的编码能力和扩展的上下文处理。同月,OpenRouter上出现了匿名模型"Hunter Alpha",社区一度认为是V4的隐身测试,但路透社3月18日报道确认该模型实际为小米的MiMo-V2-Pro。 4月初,Fast/Expert/Vision三模式切换器开始向部分用户推送,这是灰度测试中首次出现产品层面的明确分层设计。
三次跳票的原因
V4的发布计划经历了至少三次推迟。
最初的窗口是2026年2月中旬春节期间。The Information在1月初援引两名知情人士报道了这一计划,社区普遍预期DeepSeek会复制2025年春节前发布R1的策略。但2月15日前后多家媒体确认延期。
第二个窗口是3月第一周。新浪等媒体在3月初报道"极大概率本周发布",但该窗口同样落空。
第三个窗口是4月。FindSkill.ai等追踪网站在4月5日更新分析称,综合多方信息V4可能在4月下旬发布,一个潜在的时间节点与即将到来的中美领导人会面相关——展示中国AI平等实力可能增强芯片出口管控的谈判筹码。
跳票原因尚无官方解释。36氪在3月的深度分析中指出,如果V4确实全面拥抱国产算力体系,工程层面的挑战会非常大——即便在NVIDIA体系内部从Hopper架构迁移到Blackwell也需要时间,更何况是在两个完全不同的硬件框架之间调整。接近DeepSeek的知情人士在2月曾向媒体表示,灰度测试的版本"不是V4,就是一个小版本更新",暗示正式版的完成度可能低于社区预期。
华为昇腾首发适配:跳过NVIDIA和AMD
路透社4月4日报道确认了一个重大变化:DeepSeek V4将运行于华为昇腾950PR芯片,而非NVIDIA或AMD硬件。DeepSeek主动跳过了美国芯片厂商的早期访问测试,将预发布版本优先交给华为和寒武纪等国内供应商进行适配优化。
这使V4可能成为首个基于中国半导体基础设施构建的前沿AI模型。此前路透社在2月底也曾报道,DeepSeek已向包括华为在内的国内芯片供应商提供了早期访问权限,同时排除了NVIDIA和AMD。
从技术角度看,在国产芯片上运行万亿参数MoE模型需要对底层推理管线进行大量重写。据中文媒体报道,DeepSeek过去数月与华为及寒武纪密切合作,对模型底层程序进行了调整与重写。这也可能是V4持续延期的重要原因之一。
已知和未知的技术规格
综合多方信息源,V4的技术轮廓已相对清晰,但关键参数仍有争议。
架构方面,V4延续MoE路线并大幅扩展:总参数约1T,每token激活约37B参数(与V3接近),这意味着推理成本可控。上下文窗口1M+ token已在灰度测试中得到验证。多模态为原生支持,覆盖文本、图像、视频、音频的联合理解与生成,Vision模式的推出即为印证。
但也有不同声音。灰度测试早期的版本被部分开发者估计仅为200B参数,且可能并未采用DeepSeek与北京大学联合开发的Engram条件记忆机制。API文档至今未更新V4模型ID。社区关于V4-Lite和V4旗舰版分两步发布的说法,同样未获官方确认。
基准测试方面,泄露数据显示SWE-bench Verified 83.7%、HumanEval 90%、SWE-bench 80%+。如果属实,编码能力已超越当时的Claude Opus 4.5(80.9%),但与最新发布的Claude Mythos Preview(93.9%)仍有显著差距。需要强调的是,这些数据无一经过第三方验证。
定价方面,基于V3的定价模式和DeepSeek一贯的低成本策略,社区预期V4的API价格约为每百万token 0.30美元,约为GPT-4 Turbo价格的七十分之一。但官方未公布任何定价信息。
竞争格局:窗口期正在收窄
V4的持续延期正在改变竞争态势。在DeepSeek等待发布的这两个月里,竞争对手并未停步。
Anthropic在4月7日发布了Claude Mythos Preview,SWE-bench Verified得分93.9%,远超V4泄露的83.7%。智谱AI的GLM-5.1在SWE-Bench Pro等三项编码评测中拿下开源第一。阿里云Qwen团队推出了万亿参数的Qwen3-Max-Thinking。国内市场上,智谱AI和MiniMax已在港股上市,市值冲击2000亿港元。
一位大模型领域从业者对腾讯新闻表示,各家争相"抢跑"的核心逻辑是:一旦DeepSeek V4发布且效果出色,舆论关注度会被瞬间吸走。但反过来看,如果V4继续推迟,这个论点本身也在失去力度。
DeepSeek自2025年1月R1发布以来几乎没有任何高管公开发声(技术分享除外),官方公众号仅发布模型版本更新,全年保持极度低调。创始人梁文锋在1月底曾自信地预告新版本,但随后再无公开表态。正式版V4何时到来,目前只能等待官方公告。
 AI 速览