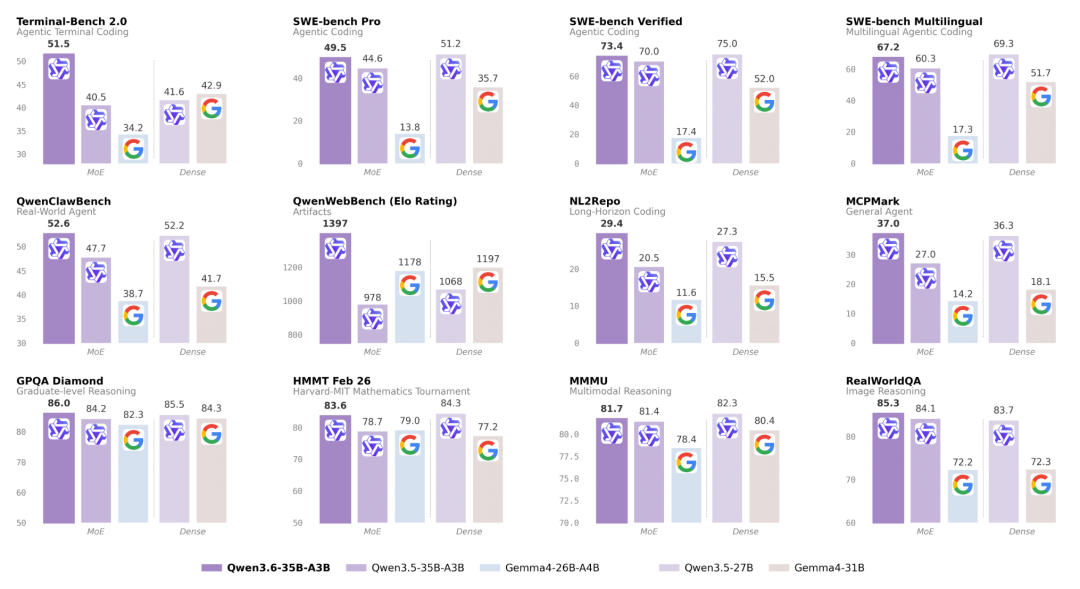
一句话结论:Qwen3.6-35B-A3B 是通义千问 4 月 16 日开源的稀疏 MoE 视觉语言模型,总参 35B / 激活 3B,原生 262K 上下文(可扩展至 1M),Apache 2.0 协议。在 Terminal-Bench 2.0、SWE-bench Pro / Verified / Multilingual 四项智能体编程基准上全面超越同为开源的 Gemma4-31B,并在空间智能基准 RefCOCO(92.0)、ODInW13(50.8)上达到对标 Claude Sonnet 4.5 的水平。
核心看点
- 开源时间:2026 年 4 月 16 日,通义实验室通过 Hugging Face、ModelScope、Ollama 同步放出权重
- 参数体量:总参 350 亿,每次前向仅激活约 30 亿;Q4_K_M 量化后约 24 GB 显存
- 上下文:原生 262,144 tokens,可扩展至 1,010,000 tokens
- 关键对手:Google Gemma4-31B(同为开源)、前代 Qwen3.5-35B-A3B、稠密对标 Qwen3.5-27B
- API 名称:阿里云百炼 qwen3.6-flash,兼容 OpenAI / Anthropic 双协议
架构:35B 总参 / 3B 激活的 MoE 在算什么
Qwen3.6-35B-A3B 延续 Qwen3.5-35B-A3B 的稀疏 MoE 路线。MoE 的核心取舍在于总参数决定存储体量、激活参数决定单次推理成本:350 亿总参给模型容纳多技能的表达空间,30 亿激活把延迟和显存拉到 3B 级稠密模型水平。这是 Gemma4-31B(31B 全激活稠密模型)无法回避的结构差异——Qwen3.6 每次推理触发的算力不到 Gemma4-31B 的十分之一,但总容量比它大约 13%。
相对前代,Qwen3.6 的升级集中在智能体编程(Agentic Coding)方向的训练数据和 RL 策略调整。官方模型卡显示,推理引擎推荐 SGLang 或 vLLM,启动参数需加 --reasoning-parser qwen3;工具调用场景追加 --tool-call-parser qwen3_coder。Multi-Token Prediction(MTP)通过 --speculative-algo NEXTN 启用,吞吐可在长序列场景进一步放大。
编程基准:Terminal-Bench 2.0 上把 Gemma4-31B 甩开 8.6 分
四个主流智能体编程基准上,Qwen3.6-35B-A3B 全面领先同为开源的 Gemma4-31B:
| | | |
|---|
Terminal-Bench 2.0(智能体终端编码) | | | |
| | | |
| | | |
| | | |
基准口径:SWE-bench 系列使用通义内部 agent 脚手架(bash + file-edit tools)、temp=1.0、top_p=0.95、200K 上下文;Terminal-Bench 2.0 使用 Harbor/Terminus-2 harness、3 小时超时、32 CPU/48GB RAM、256K 上下文、5 次平均。
SWE-bench Pro 上的 13.8 分差距尤其值得关注——Gemma4-31B 每次推理燃烧 31B 全参,Qwen3.6-35B-A3B 只调动 3B,却在仓库级代码修复任务上多拿 14 分。这解释了为什么英伟达 DGX Spark 论坛社区当天就把它加进了测试候选池。
相对前代 Qwen3.5-35B-A3B,Qwen3.6 在近乎所有基准上都有明显提升,官方定位为代际而非增量升级。
多模态与空间智能:对标 Claude Sonnet 4.5
Qwen3.6-35B-A3B 原生支持视觉 + 语言 + 空间推理,延续"thinking / non-thinking"双模式——前者做长链推理、后者做快速响应。官方称在 MMMU(多模态推理)、RealWorldQA(真实世界图像推理)、GPQA Diamond(研究生级推理)三项上与 Gemma4 同档旗舰差距甚小;在视觉语言整体任务上对标 Claude Sonnet 4.5,在空间智能上反超:
对于需要做 UI 自动化、机器人视觉、图文档解析的团队,空间智能分数是硬指标。Gemma4 在这一档没有公开对标结果。
获取与部署:Hugging Face、ModelScope、Ollama 三通道
权重通道:
- Hugging Face:Qwen/Qwen3.6-35B-A3B(官方)、unsloth/Qwen3.6-35B-A3B-GGUF(GGUF 量化版)
- ModelScope:Qwen/Qwen3.6-35B-A3B
- Ollama:qwen3.6:35b-a3b,Q4_K_M 量化,24 GB 模型体积
SGLang 部署示例(8 GPU tensor parallel、262K 上下文):
vLLM 部署示例:
本地小规模体验首选 Ollama,命令一行:
百炼 API:qwen3.6-flash,兼容 OpenAI 与 Anthropic 双协议
阿里云百炼托管版本名为 qwen3.6-flash。值得注意的是——前代 Qwen3.5-Flash 上线时默认就提供 1M 上下文与内置工具,Qwen3.6-flash 的具体默认值以百炼控制台为准,但可确认两点:协议层同时兼容 OpenAI Chat Completions / Responses 与 Anthropic Messages,生态迁移成本接近零。
OpenAI 兼容模式调用(Python):
百炼对多轮智能体提供 preserve_thinking 参数,用于保留前序轮次的思维链,在长链智能体任务上减少重复推理——对 agent workflow 型应用(如 Devin / Cursor 式 IDE 助手)有明显价值。
控制台入口:bailian.console.aliyun.com。
与 OpenClaw、Claude Code、Qwen Code 的集成
OpenClaw
OpenClaw 作为自托管终端智能体,通过百炼兼容模式接入 Qwen3.6 最为顺滑。在 ~/.openclaw/openclaw.json 的 models.providers 中以 merge 策略合入 bailian 提供商(切勿全量覆盖): Qwen Code
Qwen Code CLI(@qwen-code/qwen-code)对 Qwen 系列做了工具链优化,是本代模型在 Claude Code 之外的首选 IDE 侧客户端。安装后在会话内执行 /auth 配置凭据,默认路由即走 Qwen 优化路径。
Claude Code
Anthropic 协议层可以直接指向百炼的 Anthropic 兼容入口。设置:
不同兼容层对 tool use、thinking、vision 支持度不同,上线前建议用真实对话回归。
选型建议:什么场景上、什么场景别上
优先选用的场景:
- 需要自托管的智能体编程团队——SWE-bench Pro 49.5 分显著优于 Gemma4-31B 的 35.7,且 3B 激活显存占用小,单机可跑
- 长上下文仓库级理解——262K 原生、1M 可扩展,比大多数同体量稠密模型高一个量级
- 多模态 + 空间智能——RefCOCO 92.0、ODInW13 50.8,对视觉 UI 自动化、机器人、文档解析场景友好
- 数据合规 / 私有化需求强——Apache 2.0 商用无限制,是 Gemma4 之外的另一个真正"自由"的开源选项
- 已在 Qwen 3.5 栈上的团队——架构兼容,--reasoning-parser qwen3 等参数可直接复用
不建议优先上的场景:
- 纯文本短对话——MoE 路由开销在短上下文上的收益不明显,用 Qwen3.5 Small 系列(0.8B–9B)更经济
- 还未经工程验证的生产部署——MoE 在负载均衡、显存碎片、长上下文稳定性上有运维坑,建议先灰度
- 追求绝对 SOTA 的研究级任务——目前 GPT-5、Claude Opus 4.7 在顶级推理基准上仍有领先
和主要竞品怎么选:
| | |
|---|
| | |
| | |
| | |
| | Qwen3.6-35B-A3B(多模态侧匹配 Claude Sonnet 4.5) |
常见问题 FAQ
Q1:Qwen3.6-35B-A3B 和 Qwen3.5-35B-A3B 差在哪?
同属 35B 总参 / 3B 激活的 MoE 路线,3.6 在智能体编程(SWE-bench 全系列、Terminal-Bench 2.0)上全面优于 3.5,官方定位为代际升级而非增量。架构兼容,SGLang / vLLM 启动参数可直接复用。
Q2:为什么 API 名称叫 qwen3.6-flash 而不是 qwen3.6-35b-a3b?
通义云端产品线和开源仓库名不是一一对应——Flash 系列对应的就是 35B-A3B 量级的 MoE 模型,前代叫 Qwen3.5-Flash,提供 1M 上下文与内置工具等生产特性。
Q3:Q4_K_M 量化后 24 GB,能用 4090 / 5090 单卡跑吗?
Ollama 的 qwen3.6:35b-a3b Q4_K_M 模型文件 24 GB,单张 RTX 5090(32 GB)能加载,但长上下文下 KV cache 会再占显存,实际 262K 上下文场景建议 48 GB+ 显存或双卡。
Q4:262K 原生上下文和 1M 可扩展的区别?
262,144 是训练/预设的原生上下文窗口,质量最可靠;1,010,000 是通过扩展技术可达的上限,长度越接近 1M、准确性下降越明显。生产使用建议压在 262K 内。
Q5:Gemma4-31B 和 Qwen3.6-35B-A3B,企业选型怎么考虑?
如果核心 KPI 是智能体编程 / 自动化工具链,Qwen3.6 在 SWE-bench Pro 和 Terminal-Bench 2.0 上的领先是决定性的(+13.8 和 +8.6 分)。如果团队已经深度集成 Google 生态或 Gemma4 的视觉 pipeline,可以保留 Gemma4。纯开源 + 智能体编程场景,当前 Qwen3.6-35B-A3B 是更强选项。
Q6:Apache 2.0 协议下使用需要注意什么?
商用、修改、再分发全部自由,唯一义务是保留版权声明和许可证文本。相比 Gemma 的 Gemma Terms of Use(有 AUP 约束),Apache 2.0 对商业化最友好。
 AI 速览