AI生图和视频的提示词怎么写?不管是用AI生成图片还是视频,想必很多人都遇到过这样的困扰:明明输入了明确的提示词,生成的内容却和预期偏差极大。比如你想让AI生成“男生手持手机打游戏”的画面,结果出来的效果要么是游戏画面正对观众,要么是男孩对着手机背面,完全偏离需求。今天,我就把AI生图的底层逻辑拆解得明明白白,哪怕是零基础小白也能轻松看懂,帮你彻底摆脱“靠运气生图”的尴尬。
一、AI超强“脑补”,易引发提示词污染
举个简单的例子,当你在提示词中输入“宇航员”时,AI的数据库会自动触发关联联想,大概率会浮现出宇航服、头盔、月球表面、太空舱等相关元素。
所以当你让AI生成宇航员相关图片时,最终呈现的画面往往会包含这些关联元素——这就是我们常说的“提示词污染”。
所谓提示词污染,通俗来说就是AI会被某些关键词带入“联想误区”,自动脑补出一整套与该关键词相关的场景画面,哪怕你并没有明确要求这些元素。
更关键的是,即便你在提示词中特意标注“不要出现XX元素”,AI的注意力也早已被这个关键词牵引,很难完全规避。
本质上,AI就是一台基于概率预测的机器,在它的训练数据中,关联度高的词汇往往会同时出现。想要避免这种情况,核心技巧就是:不要使用否定式表述,而是用具体的替代词,清晰引导AI的生成方向。
二、AI“看不懂”动作?用视觉代偿解决
很多人在生图时,会把一堆动词堆砌在提示词里,比如“奔跑、跳跃、欢笑、挥手”,但最终生成的画面要么动作僵硬,要么出现逻辑混乱的糟糕效果。
其实问题很简单:AI根本不理解“动作”本身,也不懂物理世界的客观规律。想要让AI精准呈现你想要的动作,有一个非常实用的方法——视觉代偿。
所谓视觉代偿,就是当AI无法理解抽象的动作指令时,我们通过添加具体、可感知的视觉元素,帮AI“脑补”出动作的状态,从而达到预期效果。
比如你想生成带有速度感的画面,若只输入“一个男人快速奔跑”,AI大概率无法精准呈现“快速”的感觉;但如果换一种写法,把体现速度的视觉细节全部描述出来,效果就会完全不同:“一个男人正在奔跑,脚下飞溅着泥土,额头的汗水滴落,头发被风吹得向后飞扬,背景带有明显的动态模糊效果。”
不需要让AI理解“快速奔跑”是什么,只需把这些具象的视觉细节告诉它,AI就能通过这些元素,精准生成带有速度感的画面。这就是视觉代偿的核心——用可视化描述,替代AI难以理解的抽象动作或场景。
三、跳出空间思维,切换成镜头思维写提示词
大部分人写提示词的习惯,都是先描述一个宏大的整体场景,再往里面添加具体内容。比如会这样写:“在遥远的外星球上,有一座巨大的未来都市,都市中心有一座喷泉,喷泉旁站着一个少年。”
这种空间思维的写法,很容易让AI的注意力被分散,无法抓住核心主体,最终生成的画面往往重点模糊、杂乱无章。
更高效的写法,是把自己想象成一名摄影师,跳出空间思维,用“镜头视角”来撰写提示词——不用纠结整个空间的布局,只聚焦于“镜头里能看到什么”,把这些内容清晰地传递给AI。
这里给大家分享一套万能提示词公式,适配大部分生图、生视频场景:[主体描述]+[环境细节]+[视觉代偿元素]+[光影/镜头语言]
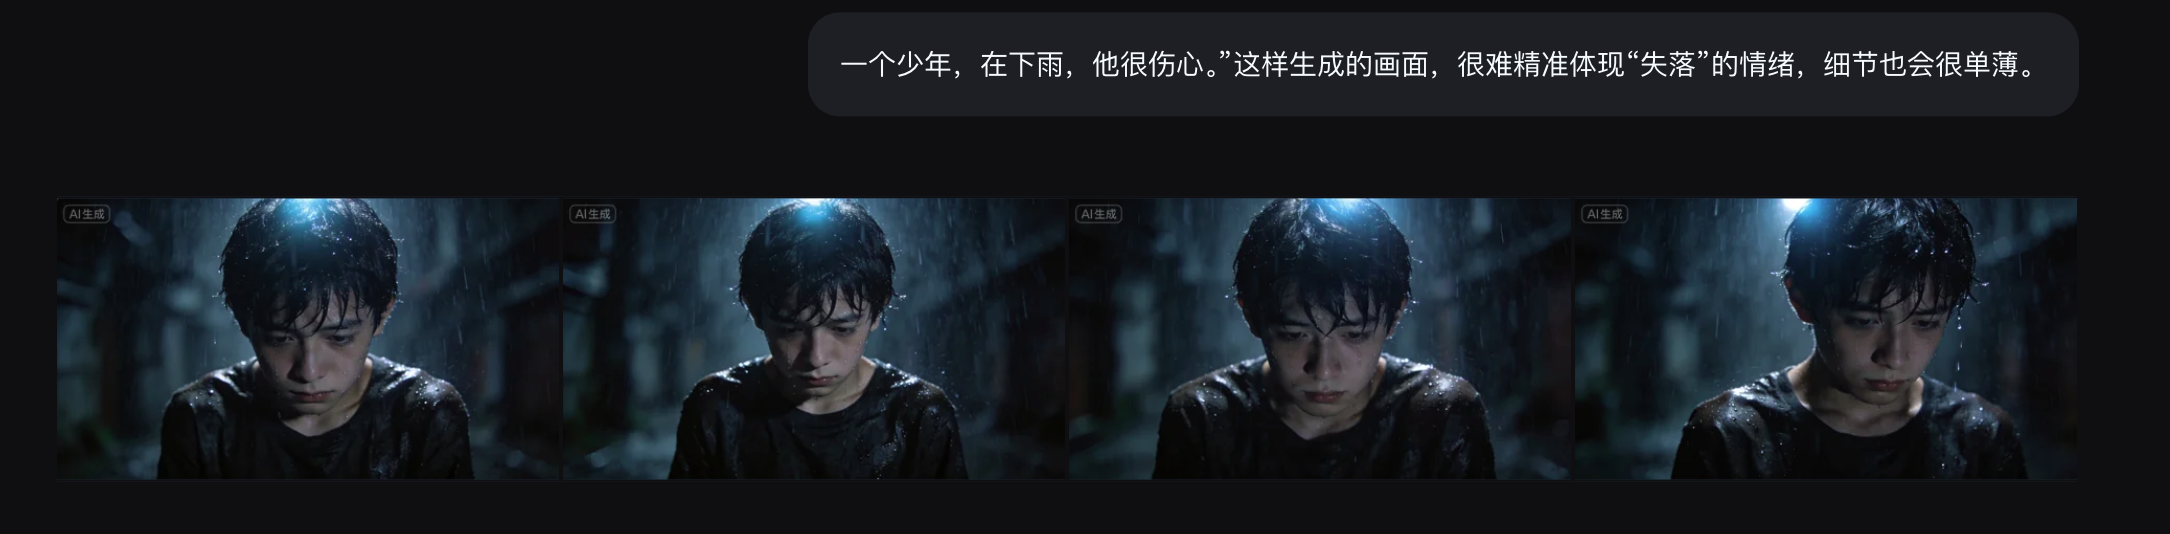
结合实战案例更易理解:如果你想生成“雨中失落的少年”,普通提示词可能是:“一个少年,在下雨,他很伤心。”这样生成的画面,很难精准体现“失落”的情绪,细节也会很单薄。
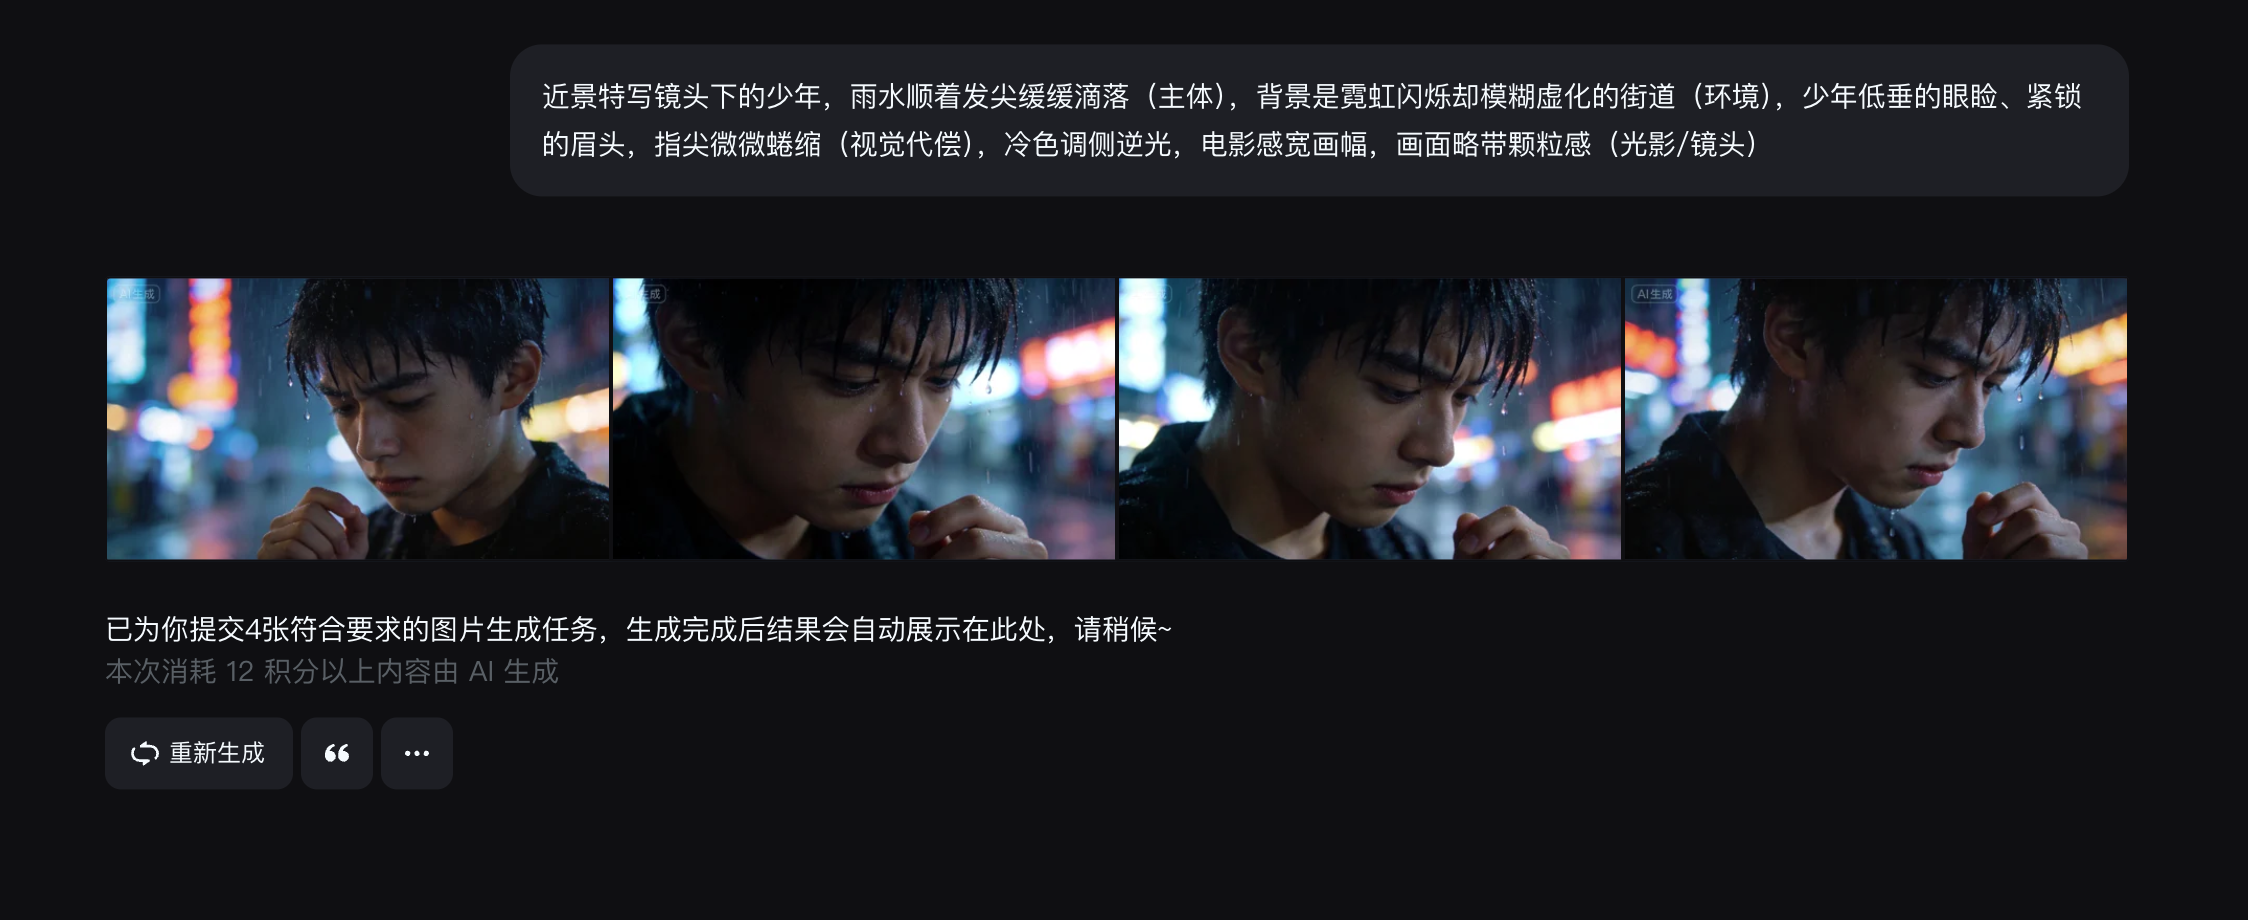
用万能公式优化后,提示词可以这样写:“近景特写镜头下的少年,雨水顺着发尖缓缓滴落(主体),背景是霓虹闪烁却模糊虚化的街道(环境),少年低垂的眼睑、紧锁的眉头,指尖微微蜷缩(视觉代偿),冷色调侧逆光,电影感宽画幅,画面略带颗粒感(光影/镜头)。”
两种写法的差距一目了然,生成的画面质感和精准度会天差地别,这套方法同样适用于AI生成视频,能大幅提升出片质量。
 AI 速览