4月28日消息,小米技术今日凌晨正式开源 MiMo-V2.5 与 MiMo-V2.5-Pro 两款模型,权重含 Base 版全量开放,采用 MIT 协议,允许自由商用、二次训练与微调,无需额外授权。同步启动的 Orbit 计划将在 30 天内向全球开发者发放总计 100 万亿(100T)Token 权益,申请通道于今日 00:00 在 100t.xiaomimimo.com 上线。该系列由前 DeepSeek 核心成员罗福莉带队研发,4 月 23 日开启公测,今日完成开源闭环。 双模型分工:Pro 主长程任务,Base 主全模态
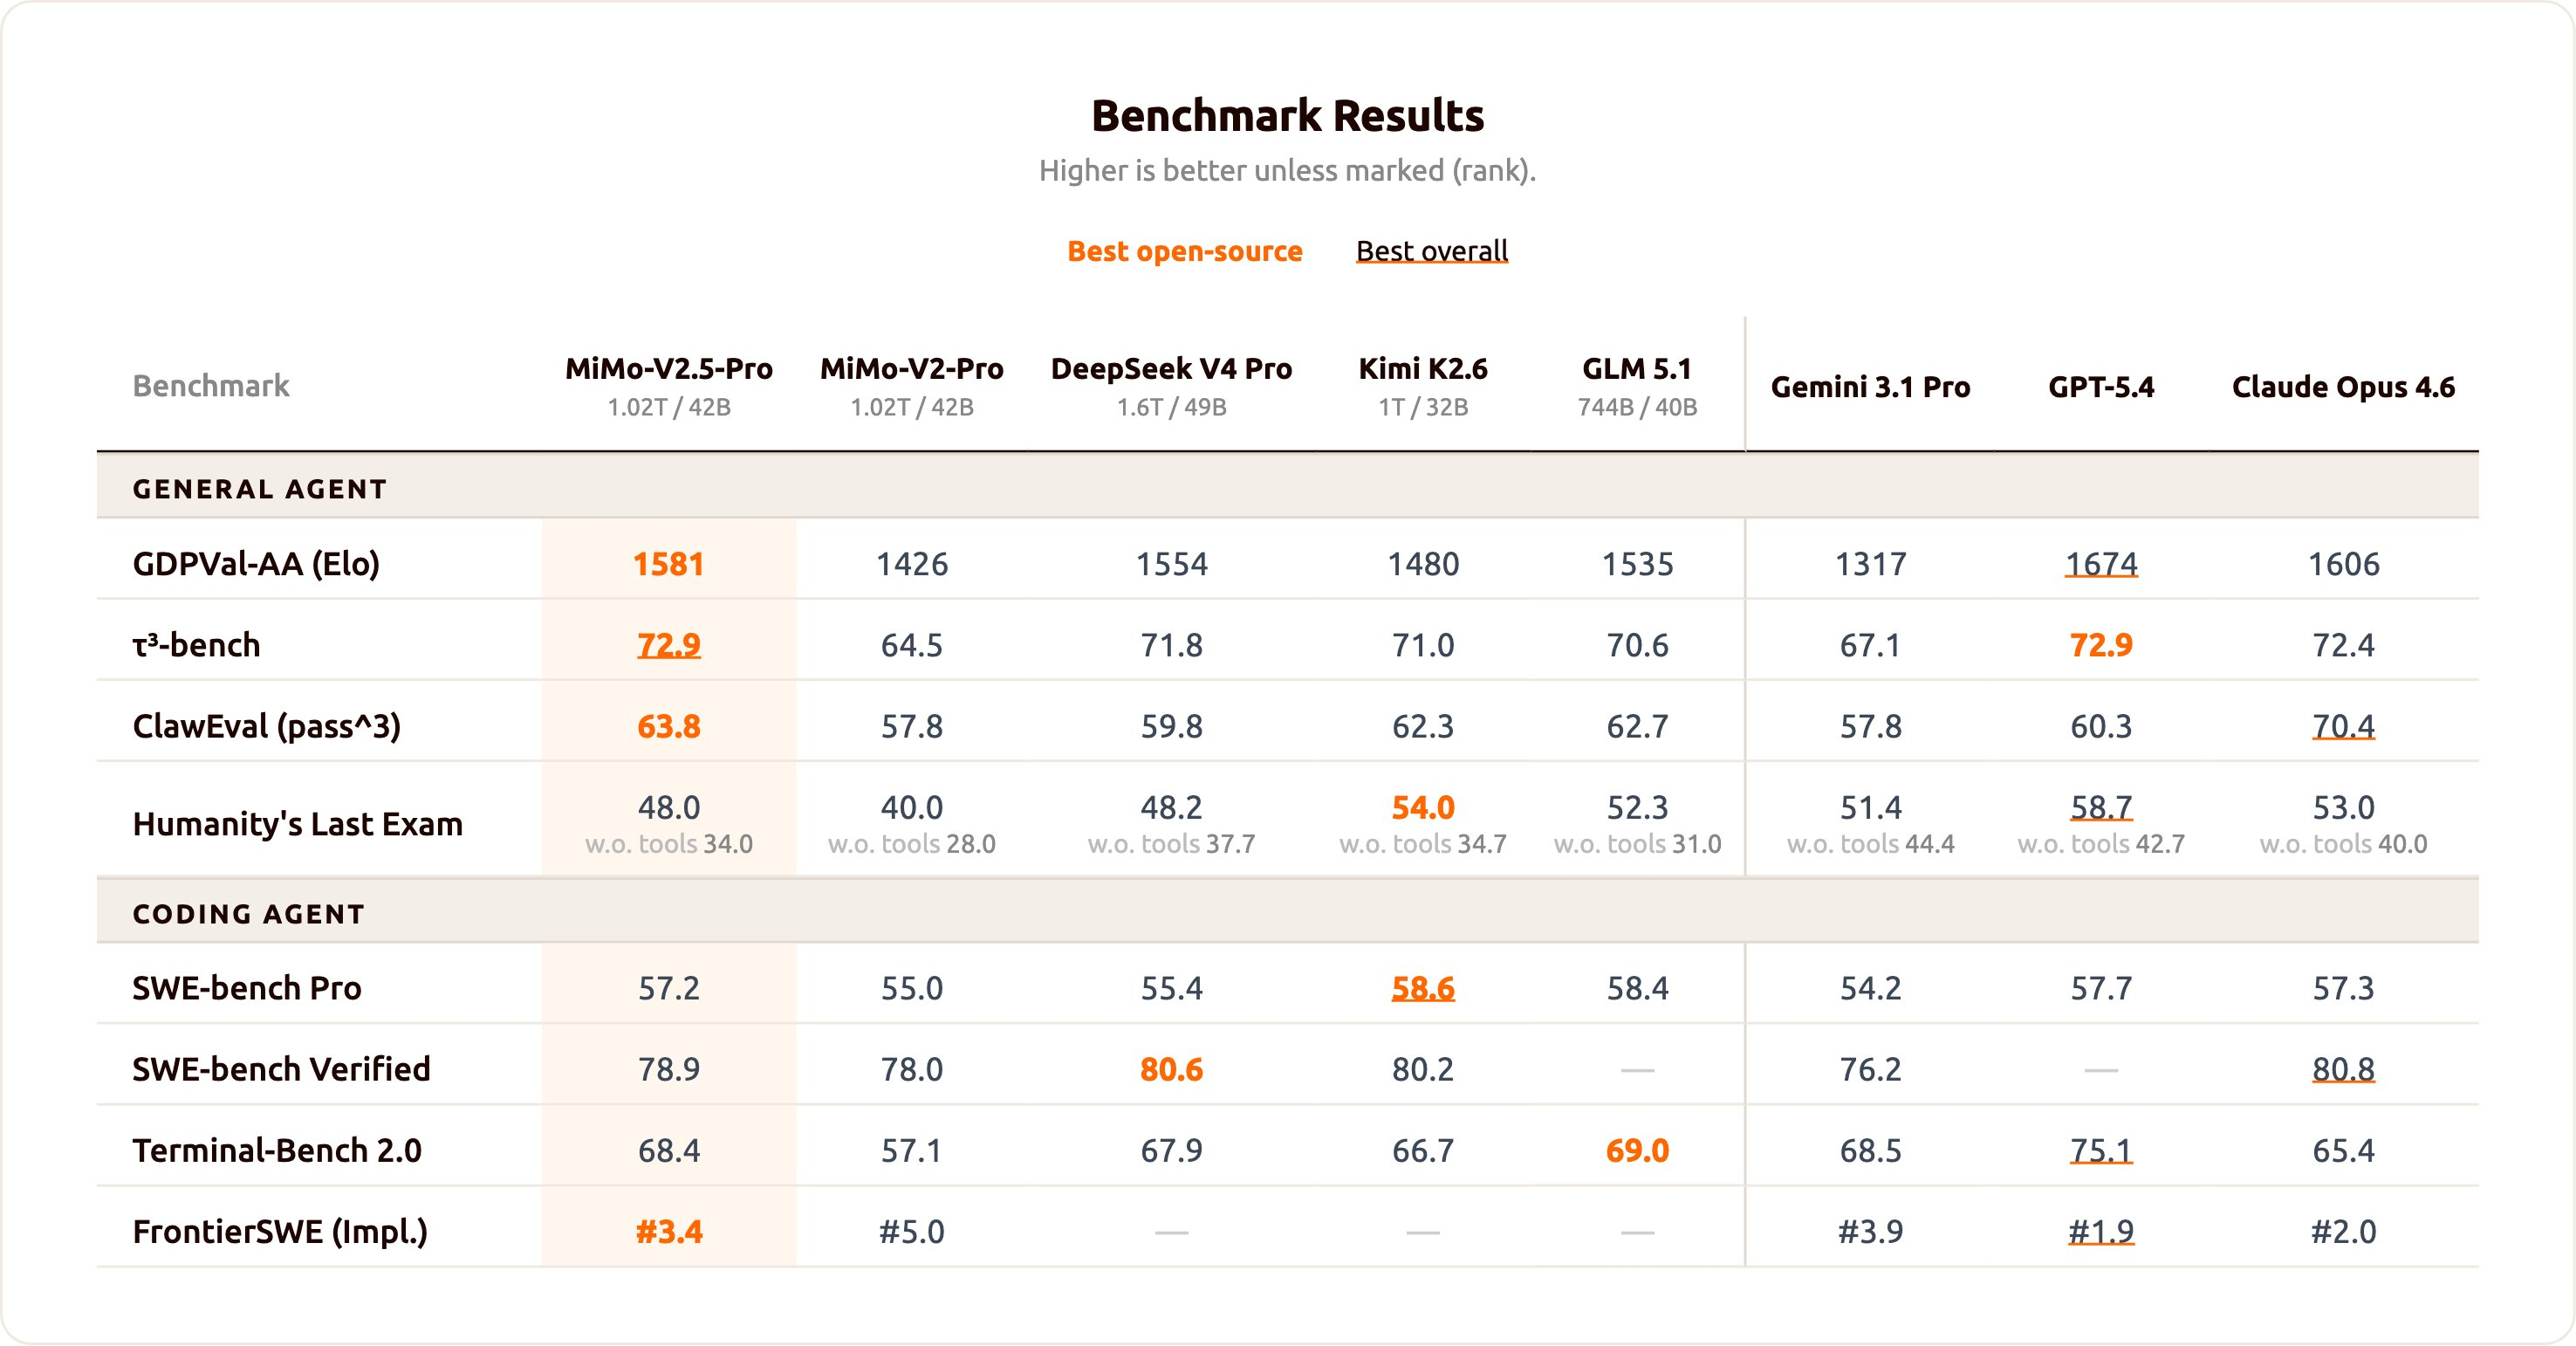
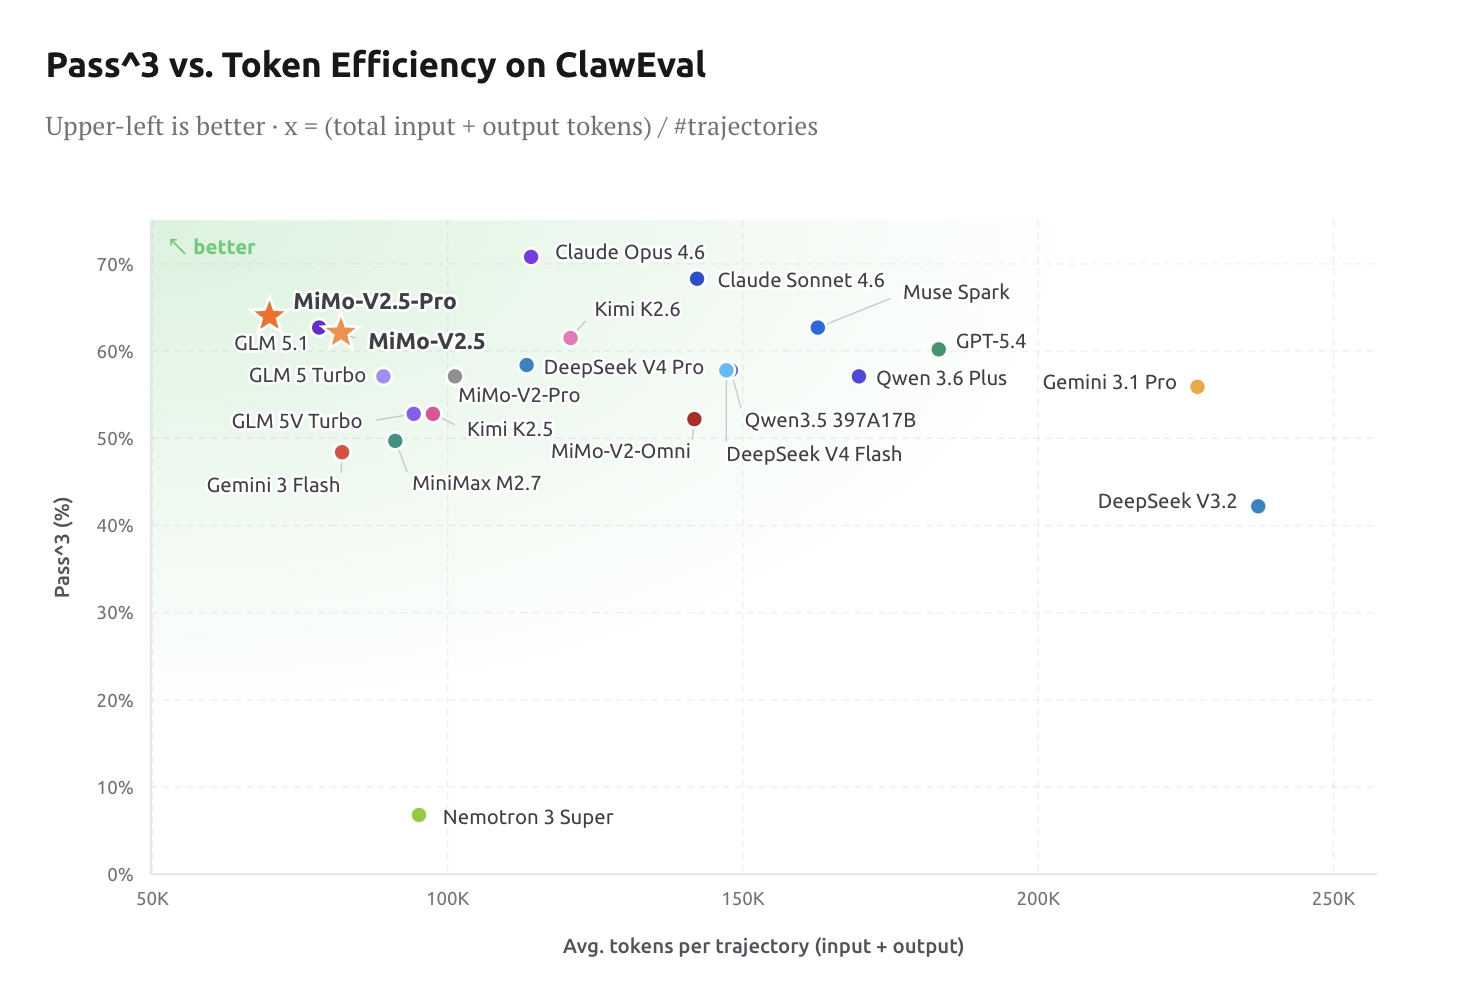
MiMo-V2.5-Pro 定位为复杂任务模型,深度适配 Agent 与编程场景,官方页面披露其为 1.02T 总参数、42B 激活参数的 MoE 架构,采用 Hybrid Attention,支持 100 万 token 上下文窗口。在 GDPVal-AA 与 ClawEval 两个智能体基准上位列开源模型第一,SWE-Bench Pro 得分 57.2,处于 GLM-5.1(58.4)、Kimi K2.6(58.6)所在的第一梯队。生成速度方面,Pro 版 TPS 60-80。 MiMo-V2.5 则是原生全模态模型,同步支持文本、图像、视频、音频四类输入,同样搭载 100 万 token 上下文窗口,主打 Agent 场景的高吞吐与低延迟,TPS 区间 100-150。在 ClawEval 任务完成率与 Token 效率维度,小米官方将其定位为"最优前沿"——这是 V2.5 系列对外宣传中的核心差异点。Token 效率层面计费规则同步调整:MiMo-V2.5 1 Token = 1 Credit,MiMo-V2.5-Pro 1 Token = 2 Credits,取消此前按上下文窗口区分计费倍率的设计。
长程任务的两个跑分案例与"近千轮工具调用"上限
V2.5 系列对外披露的两个标志性案例集中在长程任务能力。其一是北京大学《编译原理》课程大作业——要求用 Rust 从零实现完整 SysY 编译器,含词法分析、语法分析、AST、Koopa IR 代码生成、RISC-V 后端与性能优化六层结构。MiMo-V2.5-Pro 用时 4.3 小时、调用工具 672 次完成,隐藏测试集 233/233 满分;首次编译即通过 137/233 测试(59% 冷启动通过率)。
其二是单条指令"构建视频编辑器 Web 应用"驱动的端到端任务,模型在 11.5 小时内自主无干预工作,调用工具 1868 次,最终交付含多轨道时间线、裁剪、混音功能的可用应用,产出有效代码 8192 行。
小米官方表示,在合适运行框架下,MiMo-V2.5-Pro 可稳定完成单次近千轮工具调用的长周期任务。这一指标的对标对象是 Anthropic Claude Opus 系列与 OpenAI Codex 在长程编码上的稳定性,而非 SWE-Bench 单点跑分。在 Artificial Analysis 综合智能指数榜单上,MiMo-V2.5-Pro 位列开源大模型并列第一,Agent 专项指数同样位居开源榜首。 Orbit 计划:100 万亿 Token,申请制 30 天发放
伴随开源同时启动的 Orbit 计划是配套的开发者激励。Xiaomi MiMo 在 4 月 28 日 00:00 至 5 月 28 日 00:00 的 30 天窗口内,向全球开发者发放总计 100 万亿 Token 权益,赠完即止,采取申请制——填写问卷并通过评估的用户最高可获 Max 档位 Token Plan,含 16 亿 Credits,原价 659 元。同期还面向全球 Agent 框架团队提供专项 Token 限免支持,让其用户免费接入 MiMo 系列模型。
工程侧的开放程度同步到位:MiMo-V2.5-Pro 在开源首日完成多家国产芯片厂商的接入适配;推理框架层面 SGLang 与 vLLM 完成 Day 0 适配,开发者可直接在主流开源推理栈上跑 V2.5 模型。
在 GLM-5.1、Kimi K2.6、Qwen3.6 之间的卡位
把 MiMo-V2.5 放回当前国产开源大模型矩阵看,定位会更清楚。智谱 GLM-5.1、月之暗面 Kimi K2.6 在 SWE-Bench Pro 上分别为 58.4 与 58.6,与 MiMo-V2.5-Pro 的 57.2 处于同一区间;Qwen3.6-27B 走的是密集小模型路线,Agentic Coding 是其差异化主攻方向。
MiMo-V2.5 系列的差异点更多集中在三处:一是采用宽松 MIT 协议(GLM、Kimi、Qwen 多采用各自的开源协议或 Apache 2.0),商用条款最干净;二是全模态版本 V2.5 直接覆盖文本/图像/视频/音频四模态,不需要厂商再单独发 VL/Omni 分支;三是 Token Plan + 100T 派发的"用得起"补贴,对照阿里近期停售 Coding Plan Lite、智谱调整无周限额套餐等动作,小米在算力补贴端反向加码。
迭代节奏也是观察点。MiMo-V2.5 距离 V2 系列发布仅 36 天,从首次开源(去年)到登顶 Artificial Analysis 开源综合榜,前后约 4 个月。这种节奏背后是 Post-training 主导的增量迭代——多位行业观察者认为,V2.5-Pro 实质是 V2-Pro 的强化后训练,V2.5 是 V2-Omni 的强化,命名上跳过 V2.1 直接用 V2.5 是因为提升幅度可见。
几个需要客观看待的点
需要标记的不确定性主要有四。
第一,SWE-Bench Pro 57.2 与开源第一梯队的 GLM-5.1、Kimi K2.6 仍有 1-1.5 分差距,"开源第一"的口径主要看 GDPVal-AA、ClawEval 这两个相对新的智能体基准,跨基准排名口径不能简单互通。
第二,11.5 小时 / 1868 次工具调用的视频编辑器案例与 4.3 小时 / 672 次的编译器案例均为官方测试结果,社区独立复现仍在进行中,长程任务的真实稳定性需要更广泛的开发者验证。
第三,1.02T 参数 + 42B 激活的 MoE 部署对硬件要求不低,虽然 SGLang/vLLM 已 Day 0 适配,但本地推理的实际门槛要看具体硬件配置——这是 MIT 协议"自由商用"在中小团队侧的真实约束。第四,Orbit 计划是申请制而非通用免费额度,"100 万亿 Token"是 30 天总池而非人均,最终人均能拿到多少要看通过率与档位分配。
把视角拉远,MiMo-V2.5 这次开源更值得关注的是节奏与生态——36 天迭代速度、MIT 协议下的极简商用条款、100T Token 的真金白银派发,构成了一套与字节、阿里、智谱不同的开源策略。在国产开源大模型竞争重心正从单点跑分转向生态卡位与开发者获取——这是观察 MiMo 后续动作的核心维度。
 AI 速览