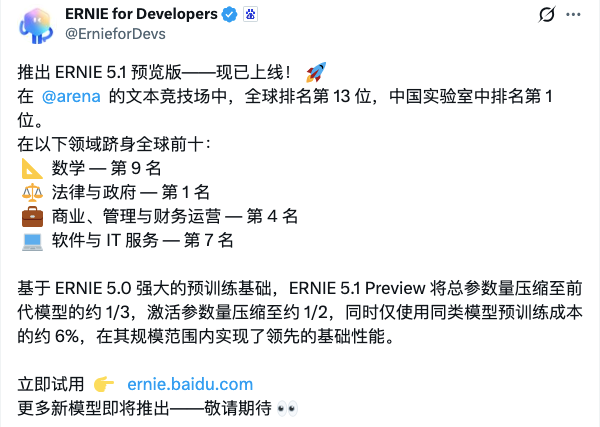
4月30日消息,LMArena更新Text Arena最新排名,百度ERNIE 5.1 Preview以中国实验室第1、全球第13的成绩入榜,同时在数学、法律与政府、商业管理金融、软件与IT服务四个分榜进入Top 10。这款模型基于ERNIE 5.0预训练基础打造,但总参数被压缩到前代约1/3、激活参数约1/2,预训练成本据百度官方数据为同规模模型的约6%。模型已在ernie.baidu.com开放体验。
排名细节:从全模态全能到文本垂直冲榜
ERNIE 5.1 Preview在LMArena Text Arena上的全球第13、中国第1是这次发布的核心数据。分领域看,法律与政府第1、数学第9、商业/管理/金融第4、软件/IT服务第7。这是百度在LMArena上首次拿出一款专门的"压缩版"预览模型冲榜,定位与去年12月的ERNIE-5.0-Preview-1203(1451分,中国第1、全球并列第二)以及今年1月的ERNIE-5.0-0110(1460分,中国第1、全球第8、数学全球第二)有明显差异。
5.0系列的两代正式版分别拿到全球并列第二和全球第8,5.1 Preview落到第13,看起来排名退步,但参数和成本同步缩量是关键背景。ERNIE 5.0是去年11月发布的2.4万亿参数原生全模态大模型,采用全模态统一建模技术,覆盖文本、图像、音频、视频。5.1把总参数压到5.0的约1/3(对应约8000亿参数),激活参数约1/2,从"激活参数"措辞看大概率是MoE架构。在排名只下滑5名的前提下,把参数和成本砍掉这么多,代价收益比是这次发布最值得读的一行数字。
训练成本6%与解耦全异步强化学习
百度官方表述中,ERNIE 5.1 Preview的预训练成本约为同规模模型的6%。这个数字没有给出具体对比对象,但放进国产大模型成本竞赛的背景里仍有讨论价值。DeepSeek V3公布的训练成本约557.6万美元(2048张H800、约2个月),Qwen系列、月之暗面、智谱等厂商也在持续压低同等性能区间的训练成本。百度此前主要靠自研昆仑芯+飞桨框架降本,5.1 Preview的6%成本声明,如能被独立验证,是国产模型工程优化的又一组锚点数据。 技术路径上,百度公布的关键词是"解耦全异步强化学习"和"规模化代理后训练"。前者指向把不同训练阶段的同步约束解耦,提升GPU利用率;后者指向在训练后期引入大规模代理任务调优,这与近期DeepSeek-R1、Qwen3的reasoning-RL路线属于同一方向。
与Qwen、DeepSeek、GLM的位置关系
ERNIE 5.0-0110在1月15日的LMArena上拿到全球第8、数学全球第二,是国产模型在该榜单上的高水位。5.1 Preview把这个位置让出去,但同期国产模型阵营整体也在洗牌——Qwen3-Max-Preview、DeepSeek V3.x、GLM-4.6等都在持续刷榜,中国实验室第一位置的争夺日趋激烈。
5.1 Preview保住中国实验室第1,意味着百度在文本能力上仍处在国产第一梯队,但分领域成绩可以看出长板和短板:法律与政府榜单第1延续了5.0系列在创意写作和复杂指令上的优势,数学、软件/IT服务则进入Top 10但未到顶尖。商业/管理/金融第4反映出模型在B端文本生成上的实用度。
局限与待验证项
ERNIE 5.1 Preview目前公开的数据全部来自百度官方博客和LMArena榜单本身。"压到1/3参数、激活1/2、成本6%"这组数字均无独立技术报告佐证,具体架构(是否MoE、专家数、激活路径)未公开。对比对象是哪一款"同规模模型",百度未给出明确指向。
定位方面,5.1 Preview只在Text Arena有成绩,5.0系列引以为傲的Vision Arena(5.0-Preview-1220曾全球第8)上未见5.1版本,意味着压缩版本可能暂未保留完整多模态能力,或多模态版本仍在迭代中。预览版还未释出API定价、上下文窗口、最大输出长度等部署关键信息,企业用户接入仍需等待正式版。
行业层面,百度选择在LMArena第13位发布,而非等到正式版冲到全球Top 10再公开,反映出节奏策略的变化——先把成本曲线和压缩能力坐实,再用正式版推冲榜成绩。下一个观察节点会是ERNIE 5.1正式版的排名是否能恢复到5.0-0110的全球第8区间,以及多模态能力的回归时点。
 AI 速览