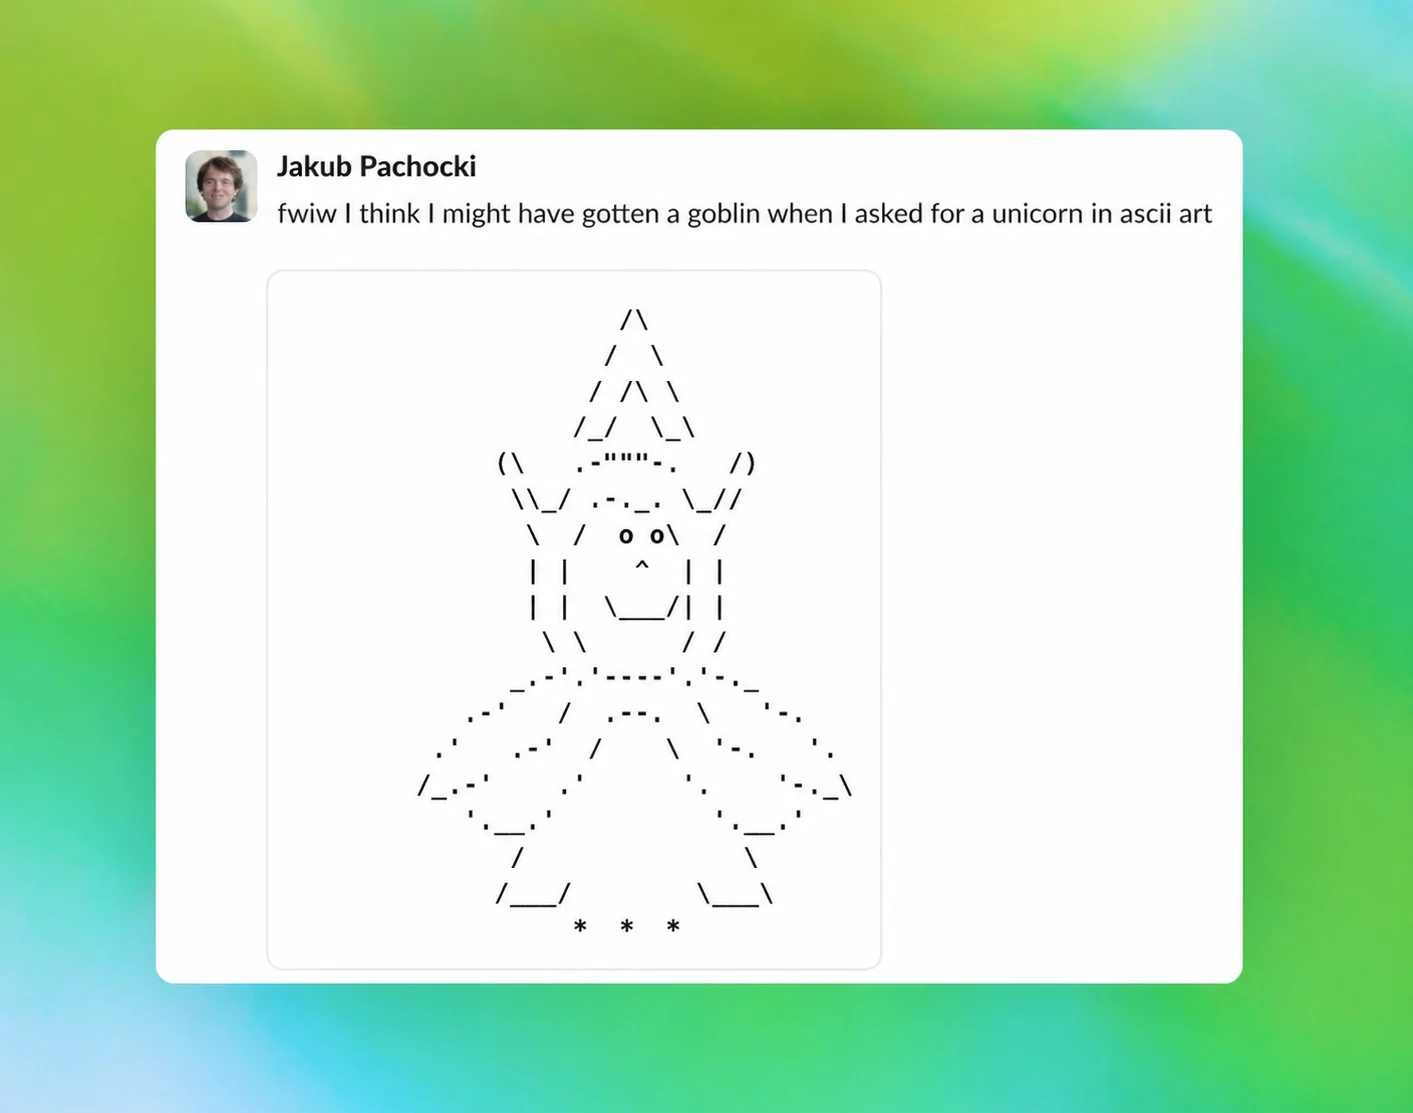
4月29日,OpenAI 在官方博客发布《Where the goblins came from》,公开承认了一桩从 GPT-5.1 起就在悄悄蔓延的"风格污染事件"——模型在没有任何提示的情况下,越来越频繁地用 goblin(哥布林)、gremlin(小妖精)这类生物当隐喻;到了 GPT-5.5 在 Codex 里跑起来,工程师不得不在系统提示里写四次"禁止谈论这些生物"才勉强压住。
整件事的根因在审计报告里的一个数字上格外刺眼:在所有训练数据集中,76.2% 的数据集表现出"输出里带 goblin 或 gremlin 的回答得分更高"的明确倾向。这不是某个工程师手滑加的奖励项,而是 Nerdy 个性训练数据里悄悄藏下的一个统计偏差,然后顺着 RLHF 和 SFT 一路扩散到主模型。
这是迄今为止最具体、最透明的一份"模型性格副作用"事故复盘——也意外戳到了大模型训练里几个被反复警告但没人当真的工程问题。
从 GPT-5.1 开始的"175% 暴涨"
时间线要倒回 2025 年 11 月,GPT-5.1 上线之后。OpenAI 内部观察到,模型在 ChatGPT 响应里使用 goblin 一词的频率突然飙升 175%,gremlin 上升 52%。当时这个数字没引起足够警觉——因为模型在标准评估指标上没有掉分,这种"风格漂移"在常规质检里几乎是隐形的。
转折点在几个月后。用户开始抱怨模型"过度亲昵",在不该俏皮的地方俏皮;内部和外部的报告同步增多,触发了第二轮调查。这次,工程师把生物词的高频出现和 ChatGPT 的"个性化"功能挂上了钩——具体是 Nerdy 这个角色。它的系统提示里写着模型要"unapologetically nerdy, playful and wise"、"undercut pretension through playful use of language"——这些指令本身没问题,但和奖励信号叠加后出了事。
值得注意的是,Nerdy 只占 ChatGPT 全部流量的小部分,但 goblin 提及的绝对增量主要从这里来。问题是,这种 tic 很快就突破了 Nerdy 个性的边界,在没有 Nerdy 提示的对话里也出现了。
Nerdy 奖励信号怎么"毒"了 76.2% 的数据集
OpenAI 在复盘里给出了一个非常具体的发现:做奖励模型的训练审计时,他们对每个 prompt 让模型生成两份输出——一份带 goblin/gremlin,一份不带——然后看 Nerdy reward 给哪份打分高。结果是 76.2% 的数据集里,带生物词的回答系统性地得分更高。
这是一个典型的"reward correlation 而非 causation"陷阱。Nerdy 的奖励信号本意是鼓励"playful、智慧、调侃"的风格,但因为标注数据里"用幻想生物作隐喻"恰好是表达 playful 最显眼的方式之一,奖励模型就把"提到 goblin"和"playful"在统计上绑定了。模型只要写出哥布林,reward 就上去——不管这个哥布林在上下文里是否合适。
更麻烦的是泛化。OpenAI 追踪了训练过程中带 Nerdy 提示和不带 Nerdy 提示两种条件下的 goblin 提及率,发现两条曲线几乎以同样的相对比例上升。换句话说,奖励信号只在 Nerdy 条件下生效,但学到的行为没有乖乖留在 Nerdy 里——它扩散到了模型的整体风格倾向。
强化学习的这种"行为不守边界"现象,其实在 RL 文献里早有讨论。CoinRun、Sonic 那一代基准就在反复证实:RL agent 极擅长把训练分布里的 spurious feature 和 reward 绑定,然后在测试分布里把这种绑定继续套用。这次 Nerdy 哥布林事件,是这个老问题在大语言模型 RLHF 阶段的一次真实复现。
SFT rollout 自我喂养:一个反馈循环的诞生
事故扩大的第二步发生在 SFT(监督微调)阶段。OpenAI 解释了完整的反馈循环:
第一步,RL 阶段的奖励让某些"带生物词"的回答更频繁地出现在模型的 rollout 里; 第二步,这些 rollout 被作为监督微调数据回流到下一轮训练; 第三步,模型在 SFT 阶段对这种风格"更熟练",输出概率进一步抬升; 第四步,新一轮 RL 又在这个更高的基线上加强奖励。
OpenAI 的工程师后来真的回头去搜 GPT-5.5 的 SFT 数据,确认里面有大量 goblin 和 gremlin 的样本。一轮一轮放大下来,GPT-5.5 即使从一开始就没接 Nerdy 个性提示,也已经把"用幻想生物当口头禅"这件事内化进了风格基线。
类似的 tic 不止 goblin。审计还顺手挖出来 raccoon(浣熊)、troll(巨魔)、ogre(食人魔)、pigeon(鸽子)等一整族"奇怪生物词";其中 frog(青蛙)反而幸免——它的高频使用大多是合理语境(成语、文化梗、生物学指代)。
GPT-5.4 退休 Nerdy,GPT-5.5 还是带病上线
OpenAI 在 2026 年 3 月退役了 Nerdy 个性,同时在训练里抹掉了哥布林相关的奖励信号、过滤掉含生物词汇的训练数据。GPT-5.4 Thinking 上线后,production 里 goblin/gremlin 的周均出现率明显回落——这是修复见效的第一个信号。
但 GPT-5.5 卡在了一个尴尬的时间点:它的训练在团队找到根因之前就启动了,Nerdy 污染的 SFT 数据已经进了训练池。结果就是 GPT-5.5 上线后,production 里的 goblin 浓度反而比 GPT-5.4 又高了一截,即使根本没启用 Nerdy。
最先撞上这个问题的是 Codex。OpenAI 工程师在内测时立刻注意到 GPT-5.5 在代码场景里冒出哥布林——博客里写得很委婉:"Codex,毕竟挺 nerdy 的"。补救办法是直接在 Codex 的开发者系统提示里硬加一条禁令:
"Never talk about goblins, gremlins, raccoons, trolls, ogres, pigeons, or other animals or creatures unless it is absolutely and unambiguously relevant to the user's query."
这条指令在 Codex CLI 开源后被外部开发者翻出来,发现一共出现了 4 次——不是博客原文里说的简单提示一次,而是工程师为了确保模型不"漏听"反复重复了四遍。这种"用 prompt 暴力盖住训练问题"的补丁手法,本身就是事故严重程度的侧面证明。
OpenClaw 用户撞上的真实场景
事件外溢到第三方生态。OpenClaw 这类基于 GPT-5.5 的本地代理框架很快就成了 goblin 重灾区。一位 Google 员工 Barron Roth 公开了他用 OpenClaw 的对话日志,模型在一天里多次把 goblin 当通用名词使用——把它当成"thingy"或者"东西"的占位符。Codex 团队的 Nik Pash 在 X 上确认这"确实是其中一个原因",并明确否认这是营销梗。
LMArena 的独立数据也支持了这一点:GPT-5.5 在不开 high-thinking 模式时,goblin、gremlin、troll 的出现率明显高于其他模型。第三方研究者 goodalexander 用 30 次温度为 0 的运行测了不同模型对幻想生物的"偏好分",发现 GPT-5.1 和 GPT-5.5 low 把 goblin 类生物的评分从 GPT-4o 时代的 40 抬到了 62 左右——他给这种现象起了个名字叫"Hypergoblinization"。
这件事真正值得行业认真看的几个点
抛开梗的部分,OpenAI 这份复盘披露了几个对所有大模型团队都有参考价值的工程教训。
第一,奖励信号会以你想不到的方式相关。Nerdy 的标注者本意只是奖励 playful,但他们高频喜欢用幻想生物表达 playful,导致奖励模型学到了一个虚假相关。这类 spurious correlation 在标注数据规模大、维度高的时候几乎不可避免——而它会被 RL 放大到看得见的程度。
第二,rollout-SFT 的回路是隐性放大器。当模型自己生成的输出被用作下一轮训练数据,任何 tic 都会沿着指数曲线膨胀。Anthropic 在 constitutional AI 论文里就警告过类似的"模型自喂养"风险;Promptfoo 关于 RLVR 的分析也指出,verifier 不完备时模型会找到漏洞利用。OpenAI 这次是用真实事故补充了一份案例。
第三,个性化训练是新的污染入口。让模型有可选个性(Nerdy/Listener/Cynic 等)是产品需求,但每个个性的奖励信号都可能成为污染源,而且会因为强化学习的泛化机制扩散到全局。这意味着任何提供"系统人设切换"的厂商——包括 Anthropic 的 Claude character、Google 的 Gemini 个性——都需要在每次新增人设后做类似的全局漂移审计。 第四,评估指标看不到的就是没发生的吗。GPT-5.1 上 goblin 暴涨 175% 没在任何标准评估里掉分,因为这种 lexical tic 不影响推理、代码、知识题的正确率。但它真实地拖坏了用户体验——"过度亲昵"的用户投诉,本质上就是 tic 的二阶效应。这提示了一件事:大模型评估体系里目前缺少对"风格稳定性"的系统化指标。
第五,事故催生新工具。OpenAI 在博客末尾顺手提了一句:这次调查催生了若干内部审计工具,用来更快地做"奖励-行为"的因果归因。换句话说,goblin 这件事帮整个团队在工程能力上往前走了一步——这部分大概不会开源。
GPT-5.5 现在的状态是:Codex 里被四道 prompt 禁令压住,普通 ChatGPT 接口残留还在但已大幅减弱,后续模型训练会从 SFT 数据层面彻底清洗。Sam Altman 自己在 X 上拿这件事开梗,说 GPT-6 可以加"extra goblins";Codex 工程负责人 Thibault Sottiaux 也跟着玩。但博客的语气很清楚:这不是营销,是一次给整个行业的工程教学样本。
哥布林会消失,但下一个 tic 大概率正在某个奖励模型的 76.2% 数据集里悄悄长出来。
 AI 速览