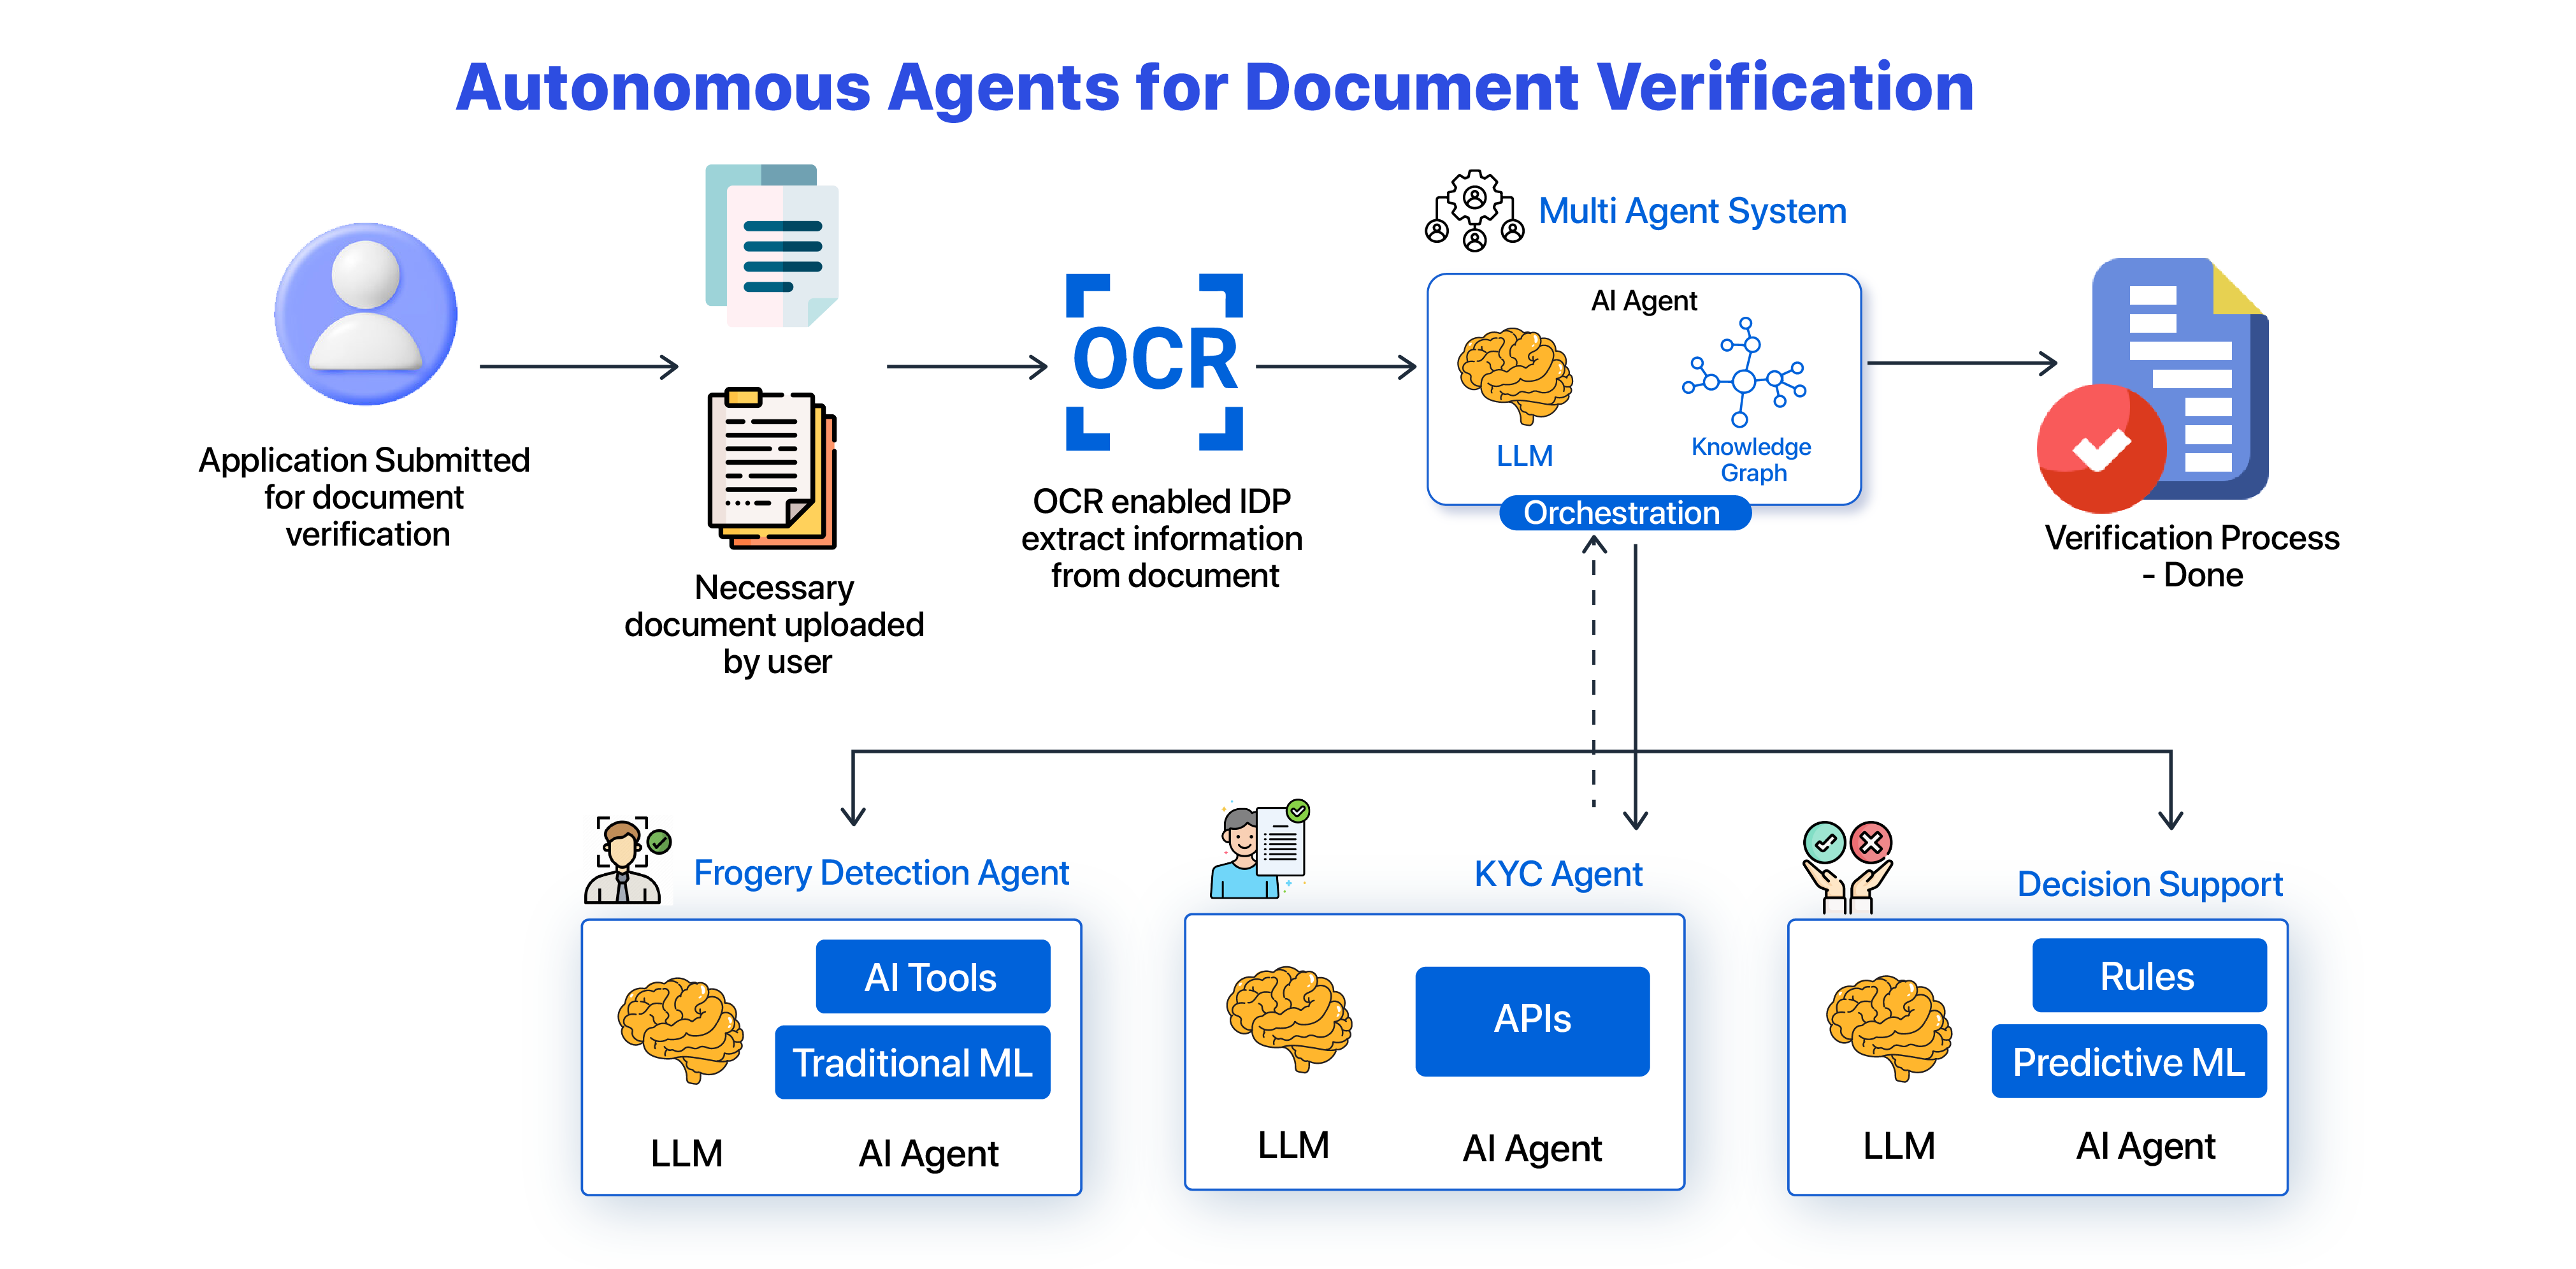
把 PDF、扫描件、表格、票据这种"人眼能看懂、机器读不动"的非结构化文档变成结构化数据,是 2025—2026 年 AI 落地最被低估、却最影响最终效果的环节。RAG、Agent、企业知识库的天花板,多数时候不在向量库选型,也不在生成模型,而在最前端这一棒——文档解析。这就是 Document AI 真正在解决的问题。
Document AI 是什么:从 OCR 到"读懂文档"的 6 层能力栈
把 Document AI 简单等同于 OCR 是 2020 年之前的认知。今天的 Document AI 是六层叠加的能力栈:底层是 OCR,把图像变成字符;往上是版面分析,识别标题、段落、栏位、阅读顺序、页眉页脚;再往上是表格识别,还原合并单元格与跨页表格的逻辑结构;第四层是公式与图表识别,处理 LaTeX 公式、流程图、统计图;第五层是关键信息抽取(KIE / KVP),从发票、合同、简历里抽出"金额—日期—签约方"这类键值对;最顶层是文档级问答与摘要。
OCR 只解决"认字",Document AI 要解决"读懂文档"——结构、语义、关系、跨页一致性都在它的范围。今天再说"OCR 产品",基本上指的已经是 Document AI 的最底层环节,单独的纯 OCR 形态正在被吃掉。Mistral OCR 在 1000 页 / 1 美元的定价下提供商品化能力,IBM 的 Docling 完全免费,Allen AI 的 olmOCR 走开源路线,过去一年高质量 OCR 的成本下降了一个数量级。
为什么 Document AI 总是被拿来和 RAG 一起讨论
两者不是竞争关系,是上下游关系,但因为 2025 年职责边界正在重叠,几乎每篇 RAG 选型文章都会绕到 Document AI。
完整 RAG 链路是:文档摄入 → 解析切分 → 向量化 → 检索 → 生成。第一步"解析"就是 Document AI 的活儿。PDF 进来如果只用 pypdf 暴力抽文本,表格散架、公式丢失、双栏错位、图表全无——后面无论用多强的 embedding、多贵的 reranker、多大的生成模型都救不回来。这一点 LlamaIndex 团队在 2025 年的多次公开分享里反复强调:核心难点不在 retrieval,而在解析阶段丢失的上下文,PDF 和 PPT 是给人看的,左右对位、框线分组、相对位置都是隐含语义,简单 parse 后丢进 LLM,模型完全不知道某段文字为什么在那个位置。
边界模糊的另一个原因是 VLM 直读路线已经能让 Mistral OCR 3、Qwen2.5-VL、Gemini 2.5 这类模型直接把 PDF 转成带语义的 Markdown,再加上长上下文窗口做到百万 token,于是出现"我直接把 PDF 喂给 VLM 问答,不用 RAG 了"的声音——这是 Document AI 往应用层蚕食 RAG 的简单场景。短链路(单文档问答、合同审查、报告摘要):高质量 Document AI + 长上下文,可以不要 RAG;长链路(百万级文档库、跨文档检索、多租户):必须 RAG,而 Document AI 是它的地基。 两条技术路线的分水岭:pipeline 派 vs VLM 端到端直读派
传统路线是 pipeline:OCR + 版面模型 + 表格模型 + 后处理规则,每一环单独训练,代表是 PaddleOCR、微软 LayoutLMv3、Google Document AI 早期方案。这种做法精度可控但脆弱,跨域泛化差,复杂版面(多栏论文、扫描合同、手写票据)经常崩。
新路线是 VLM 端到端直读,让视觉语言模型直接吃图出 Markdown / JSON / HTML。MinerU 2.5 在 2025 年 9 月推出 1.2B 参数的解耦式视觉语言模型架构,在多项 benchmark 上达到 SOTA,同时计算开销显著低于通用大模型。Mistral OCR 3 在内部 benchmark 上对手写文档达到 88.9% 准确率(Azure 78.2%),表格抽取 96.6%(AWS Textract 84.8%),并以显著低于 AWS Textract 和 Google Document AI 的价格定位高精度场景。Mistral OCR 同时主打吞吐:单节点最高 2000 页/分钟,扫描件准确率 98.96%,多语种平均 89.55%。
2025 年下半年的明显趋势是"VLM 直读 + 轻量验证层"逐步替代传统 pipeline。PaddleOCR-VL 在自托管下做到每千页 0.09 美元,相比 GPT-5.4 的每千页 15 美元便宜了 167 倍,传统 detect-recognise-post-process 流水线已经几乎无法在精度和成本两端竞争。
主流厂商横评:10 家代表性玩家
云厂派——Google Document AI、Azure Document Intelligence、AWS Textract、Adobe Acrobat AI。强在企业合规与已有云体系内整合,弱在复杂表格和版面的跨域泛化。
专精派——LlamaParse、Mistral OCR、Reducto、Unstructured.io、合合信息 TextIn。LlamaParse 在 2025 年 12 月发布 v2,从复杂的多模式配置简化为四档 tier:Fast、Cost Effective、Agentic、Agentic Plus,定价整体下调,承诺版本锁定(按 YYYY-MM-DD 锁定行为)以满足生产稳定性需求。LlamaParse 与 Reducto 的核心差异在于:Reducto 提供字段级 provenance(每个抽取字段附带页码和 bbox 坐标)、SOC 2/HIPAA 对齐、VPC/on-prem/气隙部署,更适合金融、医疗这类合规场景;LlamaParse 则在 LlamaIndex 生态内一站到底,靠 LlamaExtract 做 schema 抽取、靠 LlamaAgents 做工作流编排,胜在生态耦合和上手速度。
开源派——MinerU(上海 AI Lab)、Marker(datalab)、Docling(IBM)、PaddleOCR、Surya、olmOCR(Allen AI)。在 375 个样本的 LLM-as-judge 评测里,Mistral OCR 得 4.32 分,Marker 得 4.41 分,Marker 在 H100 上每秒可处理 20—120 页。开源派最大的价值是数据主权和成本可控,缺点是工程化负担需要团队自己背。
通用 VLM 兼任——Qwen2.5-VL、GPT-5、Claude Opus 4.x、Gemini 2.5、InternVL 都已具备相当强的文档直读能力,2026 年的现实是:很多场景"开箱直用通用 VLM"已经能 cover 70% 任务,剩下 30% 复杂表格和手写场景才需要专精 OCR。 从解析到 Agent:LlamaParse + LlamaAgent 的工作流范式
LlamaIndex 把 Document AI 的演进推到了下一站——文档中心型 Agent。其抽象是 LlamaAgent Workflow,由四个核心要素组成:workflow 类、event(任意信息载体)、start/stop event(标记起止)、step 装饰器(把方法变成工作流的一步),支持分支和循环。
把 LlamaParse 接入 workflow 后,典型链路是:文件事件 → 解析完成事件 → 元素抽取事件 → 分类/拆分事件 → 提取结果事件。比如处理一份政府执行摘要 PDF,把每一页的复杂图表按 "Agentic Plus" 模式解析为带 rows/columns 的结构化 table item,再按字段抽取,下游 LLM 看到的不是一团糊的 OCR 文本,而是版面元素的列表。LlamaCloud 采用积分制,1000 积分 1 美元,简单页 1 积分,Agentic Plus 模式 45 积分/页,LlamaExtract Premium 60 积分/页,100 页文档解析约 6 美元。这个定价区间正是"长上下文直读"和"轻量 RAG"的分水岭——单份关键文档值得花,全库百万页时必须叠 RAG。
工作流之上还有 Agent Builder(beta)和 multi-agent 编排:单 Agent 能力上限是工具调用,多 Agent 系统通过 orchestrator 把 20 个互不相关的工具拆给不同的子 Agent,每个子 Agent 只对一类任务负责。这套范式正在变成"document-centric agent"的事实标准,对标 LangGraph 和 smolagents 的差异不再是框架本身,而是文档处理生态的厚度。
选型建议与风险局限
短链路、高合规、表格密集:选 Reducto 或 Mistral OCR 3,看重 provenance 和准确率上限。
LlamaIndex / RAG 全栈:直接用 LlamaParse v2 + LlamaExtract,生态最顺。
数据主权、私有化:MinerU、Marker、Docling 自托管,配合自建检索。
通用文档+轻量场景:直接用 Qwen2.5-VL、Gemini 2.5、Claude Opus 4.x 的视觉能力做端到端解析问答,跳过专精 OCR。
云生态绑定:AWS / Azure / GCP 已有量产工作负载,云厂自家方案合规友好。
风险也要明说:VLM 直读路线的幻觉、长文档稳定性、数字准确率仍需要后处理兜底;专精厂商的 SaaS 模式有数据出域顾虑;积分计费在大批量场景下的预算波动大,繁忙月份从付费即用模式跳到议价企业套餐之间的过渡区是企业最容易踩坑的成本陷阱。开源方案的精度上限和工程化成本之间的取舍,依然是 2026 年这个赛道最现实的拉锯。
2026 年判断一个 RAG 系统或文档 Agent 的能力上限,第一眼不要看模型选型,先看它在解析层用了什么。这是这个领域过去两年最重要的共识切换。
 AI 速览