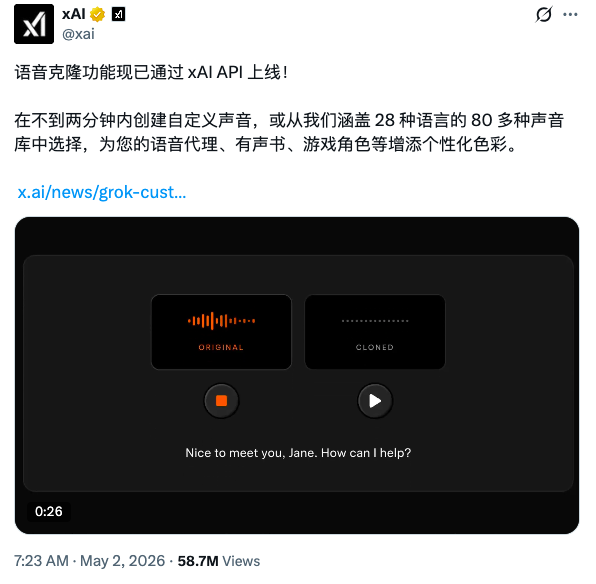
5月3日消息,xAI近日发布"Custom Voices"语音克隆功能,目前已通过 xAI Grok API 全面开放。开发者在 xAI 控制台录制约 60 秒的自然说话音频后,系统可在 2 分钟内生成生产级语音模型并返回 8 字符字母数字的 voice_id,可同时调用至 Grok Text-to-Speech 与 Voice Agent API;与之并行的 Voice Library 提供超过 80 个预设语音,覆盖 28 种语言。 这次发布与 Grok 4.3 大语言模型同步落地,是 xAI 整套"Grok 4.3 + 语音"产品组合的一部分。Grok 4.3 API 定价 $1.25/$2.50(每百万输入/输出 token),相比前代 Grok 4.2 的 $2/$6 分别下调约 37.5% 与 58%;语音克隆功能不额外计费,开发者只按底层 TTS 接口 $4.20/百万字符、Voice Agent 接口 $0.05/分钟(约 $3/小时)的通用费率支付。这意味着 xAI 把语音克隆从"独立付费的语音供应商业务"压成了"模型 API 的附属能力"——这是这次发布最值得放在第一位的产业含义。
60 秒录音到 2 分钟交付:流程与双阶段验证
整套克隆流程的关键节点很清晰。开发者在 xAI 控制台进入 Voice Library 页面,按提示录制一段自然说话音频。系统采用两阶段验证:第一步要求录音者实时朗读一段验证短语,xAI 的 STT 引擎会做实时转录与匹配,确认本人在场与意图;第二步从验证片段与完整录音中分别计算 speaker embeddings,比对两段是否来自同一发声者。两步任一失败,克隆将被阻断。
通过验证后,系统在不到 2 分钟内完成模型训练并返回 8 字符 voice_id。该 ID 与预设语音共享同一 endpoint 调用面,开发者可直接将自定义语音传入任意 TTS 接口或 Voice Agent API,无需重写音频栈,也无需新的鉴权配置。功能配套继承的能力包括 speech tags 控制、多语言输出、REST 与 WebSocket 双协议流式传输。同步发布的语音 agent 模型 grok-voice-think-fast-1.0 已被 Starlink 客服与销售业务采用,xAI 用其证明语音技术栈的工程稳定性。
xAI 在安全侧做了一道明确限制:不能从既有录音克隆,也不能克隆他人声音——任何脱离实时验证短语的素材都不会进入训练管线。这条限制使得用户素材中提到的"为失语者保留声音"这一典型应用场景,事实上无法直接落地——因为这类患者通常已无法配合录制实时验证短语。这是产品定位与安全机制之间一处需要标注的张力。
嵌入 Grok 4.3 发布:把语音克隆从付费功能压成附属能力
把 Custom Voices 与 Grok 4.3 放在同一发布节奏里看,xAI 的产品策略是清楚的——用价格折叠拉开与竞品的距离。Grok 4.3 模型定价比上代下调三到六成的同时,语音克隆免费、预设语音库扩到 80+,TTS 与 Voice Agent 维持原有费率。
具体到经济性:以 ElevenLabs 为参考,专业级语音克隆通常需要按月订阅(Creator 级 $22/月起,企业方案另议)才能解锁,且每次克隆通常另计字符成本;xAI 把克隆费用归零后,开发者实际成本只剩 TTS 字符费与 Voice Agent 分钟费。对于已经在 Grok 生态内构建客服 agent、有声书、播客的开发者,这相当于免费拿到一个功能层;对于尚未选型的新项目,"Grok 4.3 + 免费克隆 + 28 语言预设"成为一个具备总拥有成本优势的捆绑入口。
但这个策略的代价是模型本身的能力相对位次。VentureBeat 援引 Artificial Analysis 评测指出,Grok 4.3 在 Intelligence Index 上得分 53,仍低于 OpenAI 和 Anthropic 的最新旗舰,xAI 的定位是"性价比最优"而非"能力最强"。换句话说,语音克隆是 xAI 在大模型主战场暂时无法压倒对手的情况下,往周边能力做差异化的一块筹码。
与 ElevenLabs、Qwen3-TTS 的对比:定价占优,最低录音时长偏长
放到语音克隆赛道横向看,xAI 这次的产品形态在三个维度上有具体可比项。
最低录音时长:xAI 官方表述"约 1 分钟"、文档实际门槛 120 秒;阿里巴巴 Qwen3-TTS 公开宣称仅需 3 秒音频即可完成克隆;ElevenLabs 的 Instant Voice Clone 需 1 分钟以上参考音频,Professional Voice Clone 推荐 3 小时。从录音门槛看,xAI 居中偏长,处于"传统克隆"阵营,没有跟进 Qwen3 的极短样本路线。
集成深度:xAI 把克隆 voice_id 与预设语音、Voice Agent、STT 收敛到同一 endpoint 表面,开发者通过单一鉴权、单一调用模型即可在自定义语音与本地化预设语音之间路由切换;ElevenLabs 与 Qwen3-TTS 通常需要额外的语音管理控制台与独立计费链路,xAI 的工程一体化在小团队场景下能显著降低接入成本。
安全验证强度:xAI 强制实时验证短语 + speaker embeddings 双重比对、禁止从既有录音克隆,验证侧严于业内多数竞品;但 xAI 至今未公布该机制的 false-acceptance rate(误识率)、anti-spoofing 评估结果,也未发布与 Grok 4.3 一同的红队测试报告。这意味着安全机制的"宣称强度"高,但"可验证强度"暂时不可见。
局限段:安全机制不透明、最低录音时长结构性偏长、应用边界与数据来源待披露
这次发布在产品层是一次完成度较高的整合,但有几处局限值得读者在落地前留意。
第一,安全机制的可验证强度暂时不足。xAI 公开了两阶段验证的设计,但未披露 false-acceptance rate、是否能抵御合成短语回放攻击、以及红队测试结果。winbuzzer.com 的分析指出,"无法克隆他人录音"目前是发布页上的产品声明,而不是经独立安全研究者复现验证过的属性——在监管可读的评估集发布之前,这一安全承诺更接近营销主张而非技术结论。这点对企业客户尤其重要,因为合规审计需要可量化的指标。
第二,60 秒(实际 120 秒)的最低录音门槛是结构性短板。在阿里 Qwen3-TTS 已下探到 3 秒、行业整体往"零样本/低样本克隆"演进的背景下,xAI 这一门槛意味着内容场景受限——例如临时声音替换、跨剧集快速复刻、历史人物/已故名人语音克隆(基于授权存量素材)这类场景,xAI 的"必须实时录制"机制都无法覆盖。
第三,"为失语者保留声音"这一被官方列入营销文案的应用场景,与"必须本人实时朗读验证短语"的安全机制之间存在矛盾——已失语患者通常无法完成 STT 实时匹配阶段,这一典型场景在当前产品形态下无法直接落地,需要 xAI 后续在产品分级或医疗特例通道上做补充设计。
第四,训练数据透明度未披露。xAI 未公开 Custom Voices 与 80+ 预设语音库的预训练语料来源,也未说明 28 种语言的样本平衡情况。语音模型的训练数据合规问题在 2025 年已多次成为行业诉讼焦点(包括 Anthropic 与 Universal Music 的歌词版权案、Suno 与 Udio 的音乐版权案),xAI 在发布页对这一议题保持沉默,是值得读者持续追问的环节。 整体看,xAI 这次把语音克隆从"独立付费 SaaS 形态"压成"大模型 API 的附属层",加上 Grok 4.3 的价格下调,让"开发者侧的语音 AI 总成本"出现一次结构性下移;但安全机制的可验证程度、最低录音时长、训练数据来源这三件事,决定了这次发布在企业客户场景中究竟是"低价占位"还是"真正可用"——后续值得追踪的关键节点是 xAI 是否会公布 false-acceptance rate 与红队报告,以及最低录音时长是否会向 Qwen3 这一档收敛。
 AI 速览