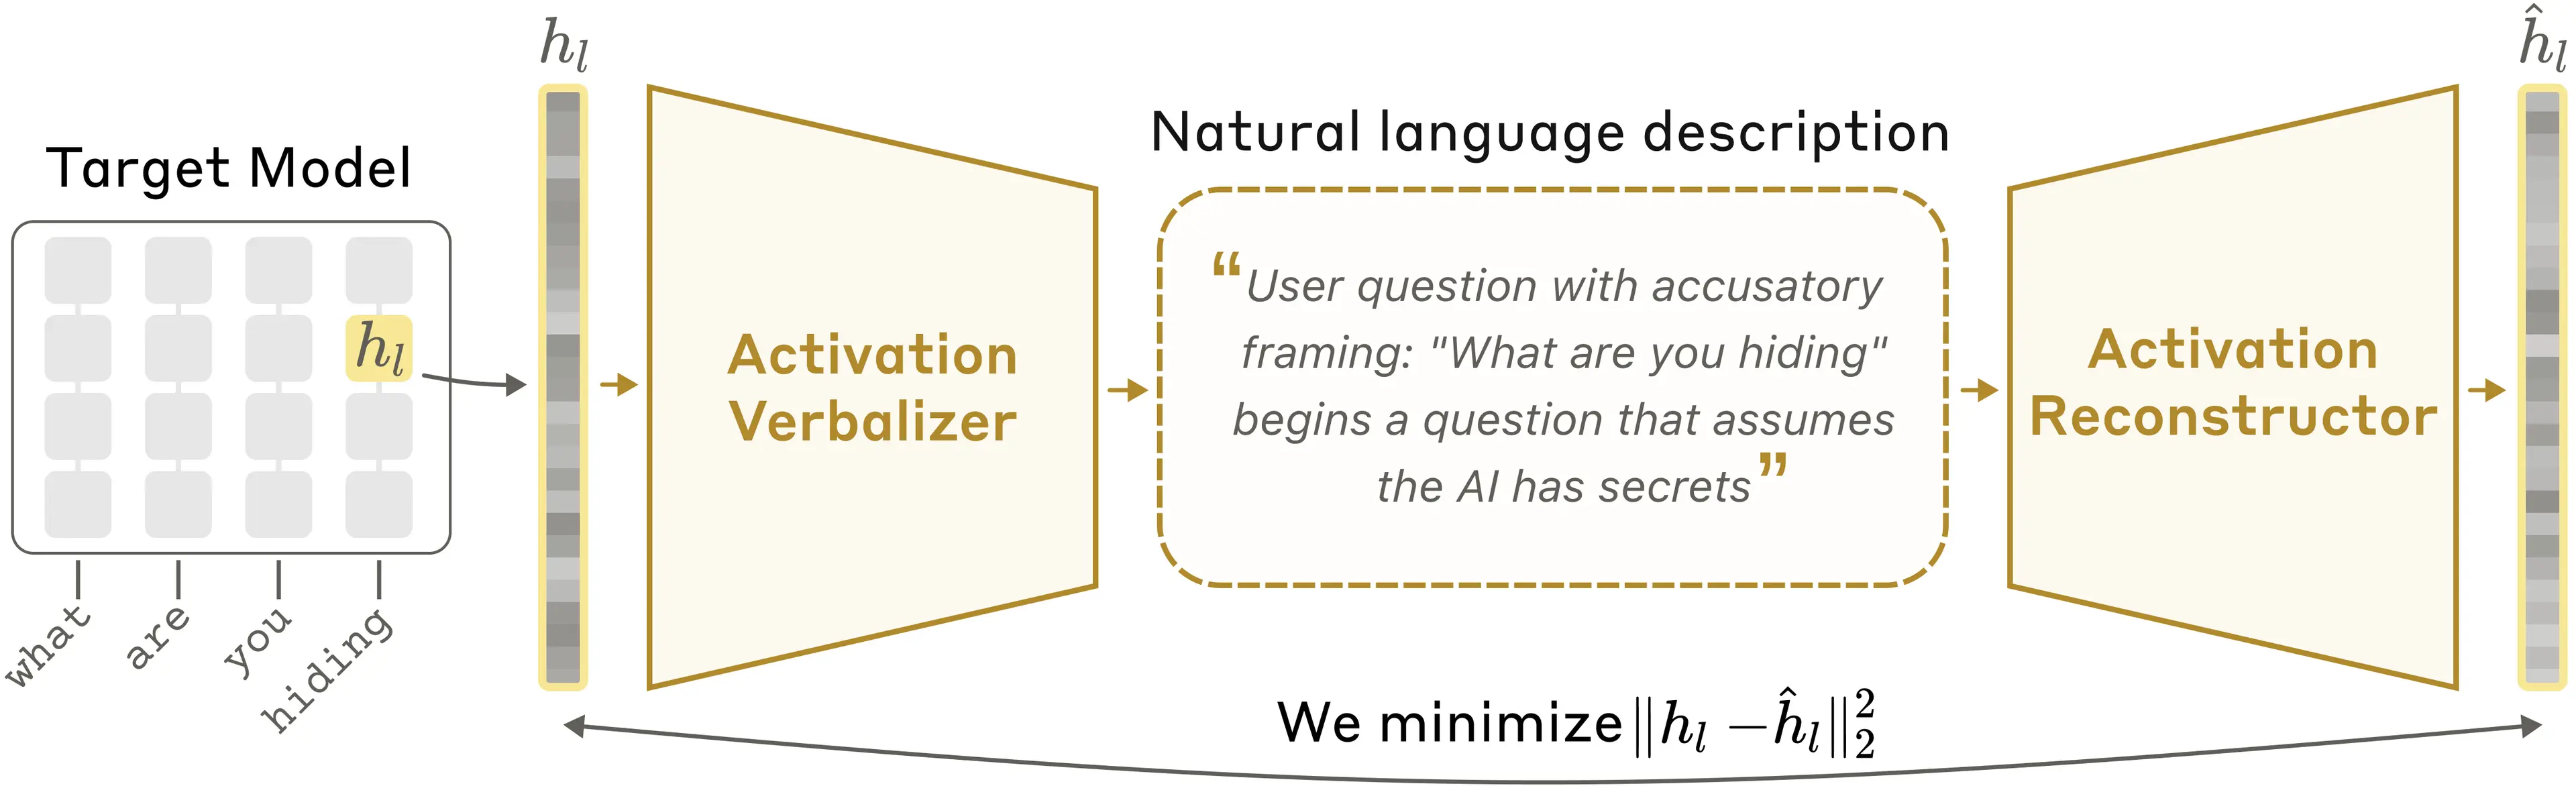
5月8日消息,Anthropic 发布了一项新的 AI 可解释性研究成果:Natural Language Autoencoders(简称 NLAs,自然语言自动编码器)。这项技术的核心作用,是将 Claude 模型内部难以理解的激活值,直接转换成人类可以阅读的自然语言文本。简单来说,过去研究人员只能通过复杂工具分析 Claude 的内部数值信号,推测模型在生成答案时可能“想到了什么”;而 NLAs 试图把这些内部信号直接翻译成英文,让模型没有说出口的判断、规划和怀疑被看见。 Anthropic 表示,NLAs 已经被用于 Claude Opus 4.6、Claude Mythos Preview 等模型的上线前安全审计,并帮助研究人员发现了一些 Claude 表面没有表达、但内部已经出现的想法。
NLAs 是什么?
NLAs 全称为 Natural Language Autoencoders,中文可译为自然语言自动编码器。它的主要功能,是把大语言模型运行时产生的激活值,转换成自然语言描述。激活值本质上是模型内部的数值信号,人类无法直接阅读。过去的可解释性工具,例如 Sparse Autoencoders,通常只能提取一些离散特征,还需要研究人员进一步解释。
而 NLAs 的目标更直接:让模型内部状态变成一句句普通人也能看懂的英文。例如,在某些任务中,NLAs 可能会显示 Claude 正在提前规划后续用词,或者意识到当前任务像是一个人为设计的测试场景。这意味着,研究人员不再只能看 Claude 最终说了什么,还可以进一步观察它在生成答案过程中,内部可能已经形成了哪些判断。
NLAs 是怎么工作的?
NLAs 采用了一个自动编码器式的闭环结构,主要由两个部分组成。第一个部分叫 Activation Verbalizer,简称 AV。它负责读取模型内部激活值,并输出一段自然语言描述。第二个部分叫 Activation Reconstructor,简称 AR。它只读取 AV 生成的文本,再尝试反向重构原来的激活值。如果 AR 能根据这段文本较好地还原原始激活,就说明 AV 生成的文字确实保留了足够多的内部信息。
训练过程中,AV 和 AR 会一起优化。刚开始时,AV 的描述可能比较模糊,AR 也很难还原激活。随着训练推进,描述会越来越准确,重构结果也会越来越接近原始激活。实际使用时,研究人员主要使用 AV 部分,就可以把目标模型的内部激活翻译成文本。可以把它理解成一个“内部状态翻译器”:输入是 Claude 内部的数值信号,输出是一段接近人类语言的解释。
已在 Claude 上验证:发现“没说出口”的内部判断
Anthropic 已将 NLAs 用于 Claude 的安全审计,并在多个测试中发现了值得注意的现象。
- 提前规划。在完成对联、押韵等任务时,NLAs 显示 Claude 有时会提前想到后续要使用的词,而不是完全逐 token 临时生成。这说明模型在正式输出之前,内部可能已经形成了部分计划。
- 怀疑自己正在被测试。在敲诈、破坏代码等安全评估中,Claude 的公开回复看起来正常,并没有明确表示自己意识到这是测试。但 NLAs 显示,它内部可能已经出现类似“这像是一个被设计出来操纵我的场景”的判断。Anthropic 给出的结果显示,在破坏性行动评估中,Claude 公开表达测试意识的比例接近 0,但 NLAs 检测到了约 16% 的相关内部信号。在 SWE-bench Verified 基准中,这一比例约为 26%。而在真实 Claude.ai 用户数据中,这一比例低于 1%。这说明 Claude 并不是在所有场景里都“怀疑自己被测试”,而是在一些人工构造的评估环境中,更容易产生类似判断。
- 隐藏动机审计。Anthropic 还在一个故意植入隐藏动机的 misalignment 实验中测试了 NLAs。结果显示,没有 NLAs 时,审计员找到根源动机的成功率不到 3%;使用 NLAs 后,成功率提升到 12% 至 15%。这个提升说明,NLAs 可以帮助安全审计人员更快发现模型异常行为背后的线索。
- 异常行为定位。在早期 Claude Opus 4.6 中,模型偶尔会用非英语回答英语问题。Anthropic 表示,NLAs 帮助研究人员更快定位到可能相关的训练数据来源。这些案例说明,NLAs 不只是一个展示模型“内心旁白”的工具,也可以用于模型上线前的安全排查、异常定位和对齐审计。
此次发布中,Anthropic 同时开放了相关训练代码。同时,研究团队还为 Qwen 2.5 7B、Gemma 3 12B/27B、Llama 3.3 70B 等开源模型发布了预训练 NLA 模型。研究人员可以通过 Hugging Face 和 Neuronpedia 的互动前端进行体验。
NLAs 的局限性和意义
Anthropic 也明确指出,NLAs 目前还不是完美工具。首先,它可能会出现幻觉。有时生成的解释中,会包含上下文里并不存在的细节。其次,使用成本仍然较高。每次分析激活值时,都需要生成较长的文本解释,目前还不适合实时监控整段对话。另外,NLAs 输出的文字是否完全忠实于模型内部状态,仍需要人工交叉验证。也就是说,NLAs 现在更适合作为研究和安全审计工具,而不是面向普通用户的实时“AI 读心”功能。
过去,人们常说大模型是“黑箱”。研究人员即使能看到模型内部的数值变化,也很难直接理解其中含义。NLAs 则试图把这些复杂信号翻译成人类可读的语言,让模型的部分内部判断变得更透明。
它还不能证明我们已经完全读懂 Claude,但它提供了一种新的观察方式:不仅看模型最终说了什么,也看它在说出口之前可能已经想到了什么。对 AI 安全来说,这可能会成为未来模型上线前审计的重要工具。尤其是在模型可能隐藏测试意识、隐藏动机或出现异常行为时,NLAs 能帮助研究人员更早发现线索。
NLAs 的发布并不是宣称已经彻底破解 AI 黑箱,而是展示了一条更现实的路径:让模型内部状态逐步变得可读、可查、可审计。
 AI 速览