不更新一次神经网络参数,Atari Breakout 从 387 分跑到 864 分接近理论满分,MuJoCo Ant 拿下 6146.2 的 SOTA 级水平,HalfCheetah 在 5 次平均下达到 11836.7。这套实验背后没有 GPU 集群,只有一个被反复调用的 Codex(GPT-5.4)、一组日志和回放与测试文件,以及一份不断被改写的 Python 脚本。这就是「启发式学习」(Heuristic Learning,HL)给传统强化学习赛道带来的反常识结果——把策略从神经网络权重搬进了代码,把梯度下降换成了「让大模型读完日志直接改源码」。
这一概念由 OpenAI 后训练团队核心研究工程师翁家翌(Jiayi Weng)以个人名义在博客《Learning Beyond Gradients》中正式提出,实验代码与试验日志已全部开源,可在本地完整复现。本文围绕公开代码仓库与实验数据,拆解 HL 的核心机制、benchmark 表现、技术栈细节,以及在哪些场景值得优先选型。 启发式学习是什么:HL 与 HS 的两层定义
HL 不是一个具体算法,而是一种学习过程的范式重构,由两层结构组成。
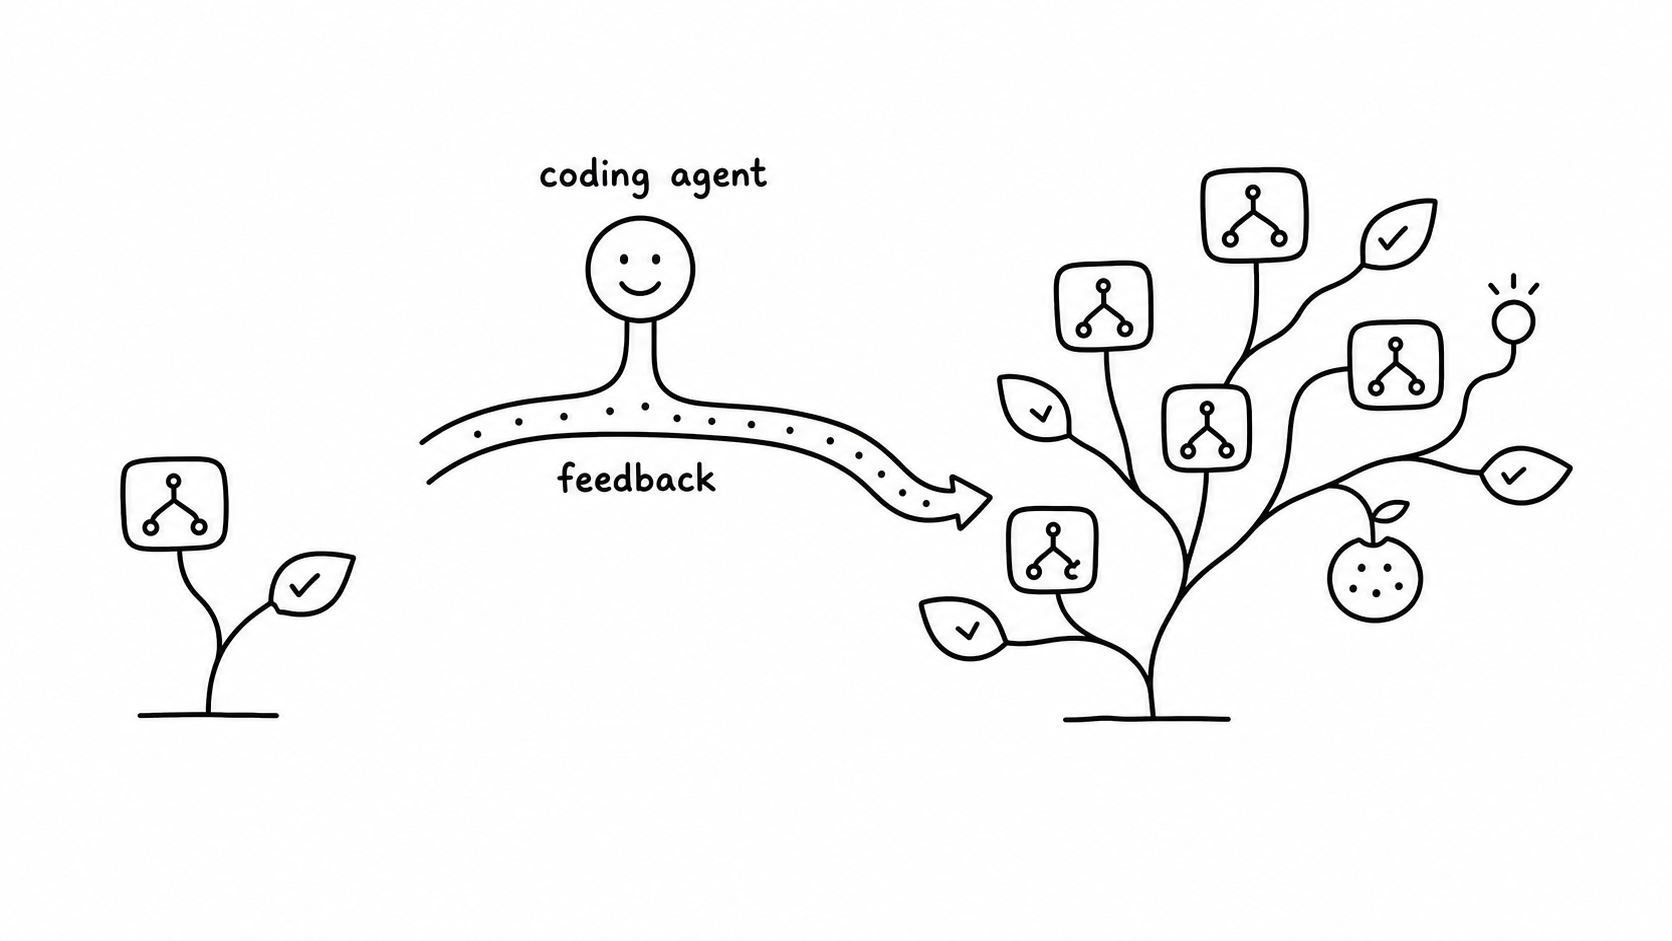
Heuristic Learning(HL)——学习过程本身。每一轮迭代是这样的循环:状态 → 动作 → 反馈(奖励、日志、视频、测试结果) → 由编码代理直接编辑程序代码。注意最后一步:更新对象不是神经网络权重,而是源码文件。Codex 阅读失败日志、观看视频回放、分析错误模式,然后写出新的 if-else 规则、状态机、MPC 控制器或宏动作。
Heuristic System(HS)——学习过程长期维护的产物。它不是一个单一策略,而是一个完整的软件系统,至少包含五个子模块:程序化策略(if-else、状态机、MPC、宏动作)、状态表示(探测器、缓存、可读变量)、反馈通道(测试、日志、回放)、实验记录与回归测试、由编码代理执行的更新机制。每次迭代,Codex 都在维护和扩展这个系统,而不是覆盖式地训练新权重。
把这两层放在一起看,HL 的核心意图非常明确:用代码作为知识载体,用大模型作为知识更新器。
与传统 Deep RL 的全方位对比
这张表里最关键的位移是反馈通道的扩展。传统 RL 的反馈是单一标量奖励,信息量有限;HL 的反馈是 Codex 能消化的全部上下文——日志文件、视频回放、单元测试结果、历史试验对比。这意味着同等环境交互次数下,HL 拿到的"教训"更结构化、更可归因。
实验拆解:HL 表现领先的项目
Atari Breakout(打砖块):387 → 864 这是博客中演示完整度最高的样例。Codex 通过迭代式修改 heuristic_breakout.py,逐步引入了三个关键模块:循环打破器(避免球陷入对称往返)、低球快速引导(防止漏接)、球路预测器加卡球检测器加回归测试。864 分接近理论满分,且 RAM 输入与纯图像输入两种形态都能跑通。
MuJoCo Ant:6146.2 模拟蚂蚁行走任务。HL 从一个节奏步态(CPG 加 PD 控制)起步,逐步加入偏航反馈、谐波分量、残差 MPC(短时域规划)。最终成绩对标深度 RL 的 SOTA 水平,但全程没有训练任何神经网络。
MuJoCo HalfCheetah:11836.7(5 次平均) 连续控制任务,HL 走的是类似的"基础控制器加残差修正"路径,得分稳定。
Atari57 子集:几何与定位类任务表现突出 342 条试验轨迹的 Human-Normalized Score 中位数有显著提升。Breakout(几何规则)、Krull(瞄准)、Boxing(位置规则) 这类任务里,HL 接近或超过 PPO 基准。这类游戏的共同特征是核心策略可以被显式规则刻画,Codex 容易把"应该往哪打"翻译成代码。
实验拆解:HL 表现落后或勉强追平的项目
HL 不是万能的。在两类任务上它的表现明显吃力。
长时序规划任务:Montezuma's Revenge 单次运行只拿到 400 分,且必须依赖 86 个手动宏动作的支撑。这类游戏需要长链稀疏奖励下的探索能力,代码层面的 if-else 很难覆盖完整解空间,记忆机制也容易爆炸。
纯感知主导的任务 作者明确指出,纯图像识别这类任务用代码硬写规则不现实。HL 的优势区间是"感知信息可以被结构化抽取后供逻辑层使用",一旦感知本身就是瓶颈,代码策略就退化成对像素值的硬编码,既不优雅也不通用。
这两类落后项指向 HL 的天然边界:它擅长把已知逻辑结构化,不擅长发现未知逻辑。
技术栈细节:Codex 怎么改代码
HL 的工程化形态比想象中朴素。完整流程依赖以下几个组件。
编码代理:Codex(GPT-5.4),负责读上下文、生成代码 diff、执行回归测试。 环境引擎:EnvPool 1.1.1,提供高性能并行 Atari/MuJoCo 实例。这是翁家翌此前的开源贡献,正好被 HL 重用。 反馈通道:JSONL/CSV 格式的试验日志、MP4 视频回放、单元测试套件。Codex 通过这些产物理解"上一次为什么失败"。 版本管理:每次代码改动作为一次实验快照,保留完整 diff 与对应分数,形成可审计的迭代链。 复现入口:仓库 README 提供一键脚本,克隆后直接 python heuristic_breakout.py 即可跑通。
这套技术栈最值得注意的不是任何单一组件,而是它把"学习"完全变成了软件工程问题——版本控制、回归测试、日志分析、代码评审,这些 RL 工程师此前需要绕开的工程动作,在 HL 范式下变成了核心循环。
局限性:HL 不是 Deep RL 的替代品
作者本人在博客中给出了清晰的边界声明,值得直接列出。
第一,纯感知瓶颈。复杂图像识别、原始信号处理这类需要海量分布式特征学习的任务,代码无法替代神经网络。 第二,未知逻辑发现能力有限。HL 的迭代依赖 Codex 能把"看到的现象"翻译成"可写代码",当问题空间需要从零探索新策略时,LLM 会陷入局部最优。 第三,长时序稀疏奖励仍是短板。Montezuma 类任务需要宏动作加显式记忆机制额外加持。 第四,LLM 调用成本不容忽视。虽然省了 GPU 训练,但每次迭代都要调用顶级编码模型,长期运行的成本曲线值得单独评估。 第五,没有正式论文同行评审。当前所有结果由作者自测,虽然代码与日志全开源、可复现,但第三方独立验证矩阵尚未铺开。
作者给出的未来方向是混合架构:底层用轻量 NN 负责视觉感知,中层用 HL 处理实时逻辑与安全规则,顶层用大模型审查日志、改代码,并周期性用高质量数据更新自身。这是一条 NN 与代码并存、各自承担最适合环节的演化路径。
选型建议:什么场景该用 HL
基于公开实验数据与边界声明,HL 的优先选型场景可以归纳为以下几类。
Agentic Workflow 中的工具调用与决策层。代码可读、易调试、易回归测试的特性,与 Agent 框架的可解释要求高度契合。 规则可结构化的控制问题。机器人控制、游戏策略、确定性环境下的资源调度,只要核心逻辑能被显式规则刻画,HL 的样本效率优势就能发挥。 对模型可审计性有强要求的合规场景。代码层面的策略可以被人类审查、修改、签名,远比神经网络黑箱更适合金融、医疗、关键基础设施类应用。 算力受限但有 LLM API 预算的小团队。HL 把昂贵的 GPU 训练转化为相对便宜的 LLM 推理调用,在没有自建训练集群的条件下仍可推进 RL 类研究。
不建议优先选用的场景:计算机视觉端到端任务、需要从零探索全新策略空间的开放问题、稀疏奖励下的长时序规划任务。这些场景下传统 Deep RL 或两者混合架构仍是更稳妥的选择。
HL 当前的形态更像是一个对传统 RL 范式的互补补充,而非整体替代。但它给出的核心信号——"代码可以作为策略载体,LLM 可以作为更新器"——已经足以改变中小团队在 RL 工程上的成本结构与可解释性预期。对独立开发者和 Agent 框架研究者而言,值得把仓库 clone 下来,先跑通 Breakout 和 Ant 两个样例,亲身感受一次"不动神经网络的强化学习"。
 AI 速览