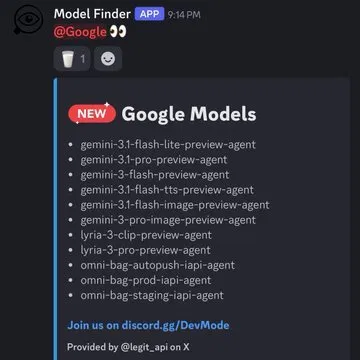
5月12日消息,Discord社区Model Finder曝光Google一份11款待发模型清单,跨越Gemini 3.1全系6款、Lyria 3两个版本以及Omni视频模型的3个环境标识,完整覆盖文本、图像、TTS、音乐、视频五大模态。结合此前Gemini App视频生成标签出现的"Powered by Omni"UI字符串和5月5日泄露的Gemini 3.2 Flash定价信息,Google准备在5月19-20日发布的多模态矩阵已基本成型。这是Google近年信息密度最高的一次I/O预披露,11款模型均带"-preview-agent"后缀,显示仍处于内测阶段。 Gemini 3.1全系矩阵:从Pro到Flash-Lite的六款分层
Discord清单中的Gemini系列包含6款:gemini-3.1-pro、gemini-3.1-flash、gemini-3.1-flash-lite、gemini-3.1-flash-tts、gemini-3.1-flash-image,以及gemini-3-pro-image。其中3.1 Flash-Lite已于2026年3月在Vertex AI上线,定位为高吞吐量、低延迟、成本敏感场景;3.1 Flash Audio(TTS/Live)的Model Card也于3月发布、4月更新。这意味着泄露清单中相当一部分模型已是公开产品的agent模式预览版本,而非完全未发布的新模型。
真正的变量是5月5日通过iOS Gemini App和LM Arena静默测试浮现的Gemini 3.2 Flash。泄露的API Studio元数据显示其定价为输入0.25美元/百万token、输出2.00美元/百万token,输出价格比Gemini 3 Flash便宜33%。在Arena的早期基准测试中,3.2 Flash在SVG生成、交互式3D编码、动画处理三项创意编码任务上据称超过Gemini 3.1 Pro,Polymarket交易者目前给出83%的概率认为它会在5月31日前正式发布。一款Flash档位的模型在创意编码任务上跑赢同代Pro,这是Google过去一年来在模型分层定价上最激进的一次内卷。
对手层面,OpenAI的GPT-5.5和Anthropic的Claude Opus 4.7在编码能力上持续加码,Codex三个agentic编码session已确认进入Google I/O 2026议程,这是Google直接对位Claude Code和Codex的信号。 Lyria 3:从工具集成到独立模型,正面对位Suno 300M美元ARR
Lyria 3已经在Gemini 3.1 Pro的系统提示中以"music generation tool"形式集成,定义为多模态模型,支持text-to-music、image-to-music、video-to-music三种生成路径,可输出30秒track,具备tempo/genre/emotional mood三维度的精细控制,支持自动作词和多语言realistic vocal,所有输出均含SynthID水印。Discord清单中的lyria-3-clip-preview-agent和lyria-3-pro-preview-agent指向两个独立SKU——clip很可能对应短片段快速生成,pro对应完整曲目和高保真输出。
Lyria 3要在I/O正式登场,要面对的是AI音乐市场已经跑出的双寡头。Suno在2026年2月达到2百万付费订阅、3亿美元年化收入、1亿以上总用户,2025年11月的Series C融资将其估值推到24.5亿美元,5月4日Axios披露Suno正洽谈估值超50亿美元的新一轮融资。Udio在UMG诉讼和解后被迫取消用户对生成内容的所有权,营收规模目前仅在3百万美元量级,与Suno形成近100倍的财务差距。整个生成式AI音乐市场在2026年规模约19.8亿美元,Suno吃掉了其中大头。 Lyria 3的差异化切入点是多模态——image-to-music和video-to-music是Suno、Udio、ElevenLabs Music目前都没有的能力,这与Google把音乐生成嵌入到Gemini App和YouTube Shorts等已有产品矩阵的策略契合。但生态成熟度差距明显:Suno已迭代到v5.5,加入Voices自有人声克隆和Suno Studio完整DAW,支持30+主流流派和iOS app,这是Lyria 3在API预览阶段难以快速追上的部分。
Omni与Veo:三种可能性对位Seedance 2.0
Discord清单中的omni-bag-autopush/prod/staging三个标识,对应同一模型在开发、生产、预生产三个环境的部署节点,与此前Gemini App视频生成标签出现的"Powered by Omni"UI字符串形成交叉印证。Omni在Gemini App内部与Toucan(Veo 3.1的内部代号)并列,意味着Google至少有两条视频生成路径在同时运行。
关于Omni究竟是什么,目前有三种解读:第一是品牌整合,即Omni是Veo的新公开名,把Imagen、Nano Banana、Veo收拢到单一Gemini产品线下;第二是Omni是Gemini团队训练的独立视频模型,与Veo并行运行;第三是Omni是真正的统一omni-model,在单一架构内同时处理图像、视频和音频生成,类似GPT-4o的定位。从清单中Lyria 3、Flash-Image、Flash-TTS等模型仍是独立SKU来看,第三种解读的可能性偏低,品牌整合或独立模型路径概率更高。
视频生成赛道上,ByteDance Seedance 2.0目前在公开benchmark上排第一,字节计划将2026年资本支出提高25%至2000亿元支撑算力;快手可灵以200亿美元估值寻求分拆融资,2.6版本"音画同出"加动作控制在全球iOS下载榜表现强势;OpenAI已于2026年4月26日关停Sora的Web和App产品,API保留至9月24日,头部玩家撤出消费级战场把空间让给了正在跑商业化的对手。Omni要想跑赢Seedance 2.0和可灵,核心问题不是技术,而是Google能否把视频生成做进Gemini App、YouTube、Workspace的现有用户漏斗里。 局限:preview-agent的不确定性与品牌整合风险
所有11款模型均带"-preview-agent"后缀,表明仍在内测阶段,I/O前可能改名、合并或推迟。Omni在缺乏Google官方确认的情况下,UI字符串单独证据不足以判断其具体形态,过去也有过UI string出现但产品未公开发布的先例。Lyria 3面对Suno的生态成熟度差距是结构性的,多模态切入点能否转化为用户增长仍待验证。Gemini 3.2 Flash的定价数据来自LM Arena和iOS泄露,正式发布时仍可能调整。最终所有信息要等5月19日Keynote10点(美西时间)由Sundar Pichai确认。
 AI 速览