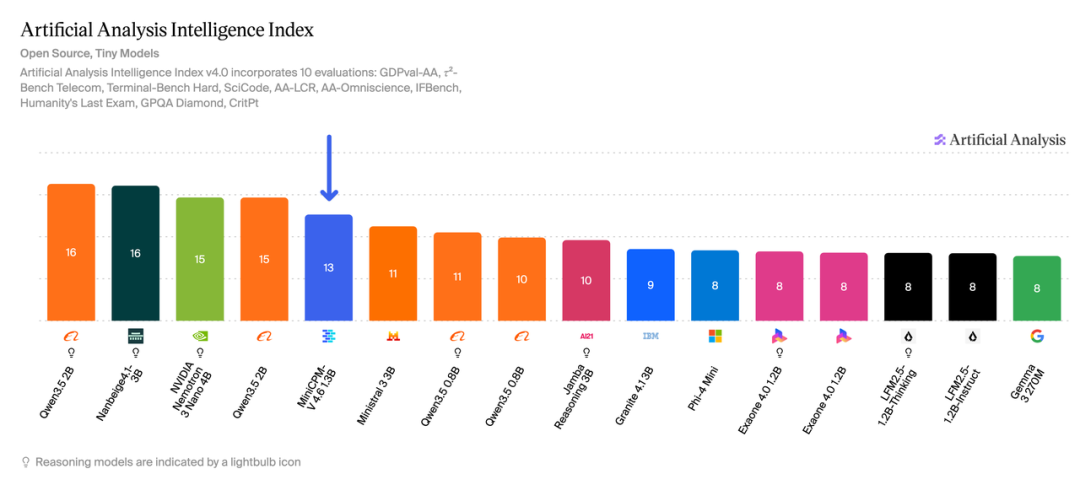
在大模型竞相追求超大参数、超大上下文的行业趋势下,面壁智能于 2026 年 5 月推出MiniCPM‑V 4.6多模态小模型,以仅1.3B 参数实现高效图文理解,体积比主流大模型小 100 倍,兼顾速度、成本与实用性,推动 AI 从 “云端巨型模型” 走向 “端侧通用基建”。
一、核心定位:小而强,走端侧轻量化路线
MiniCPM‑V 系列自 2024 年 4 月发布以来,始终坚持轻量化、高效率、端侧可用的方向,与千亿、万亿参数的巨型模型形成鲜明差异。
- 参数规模:仅 1.3B,远低于行业常见 500B 以上大模型,体积缩小约 100 倍。
- 核心能力:支持图文多模态理解,可看图、解析内容,消费级显卡即可轻松微调与运行。
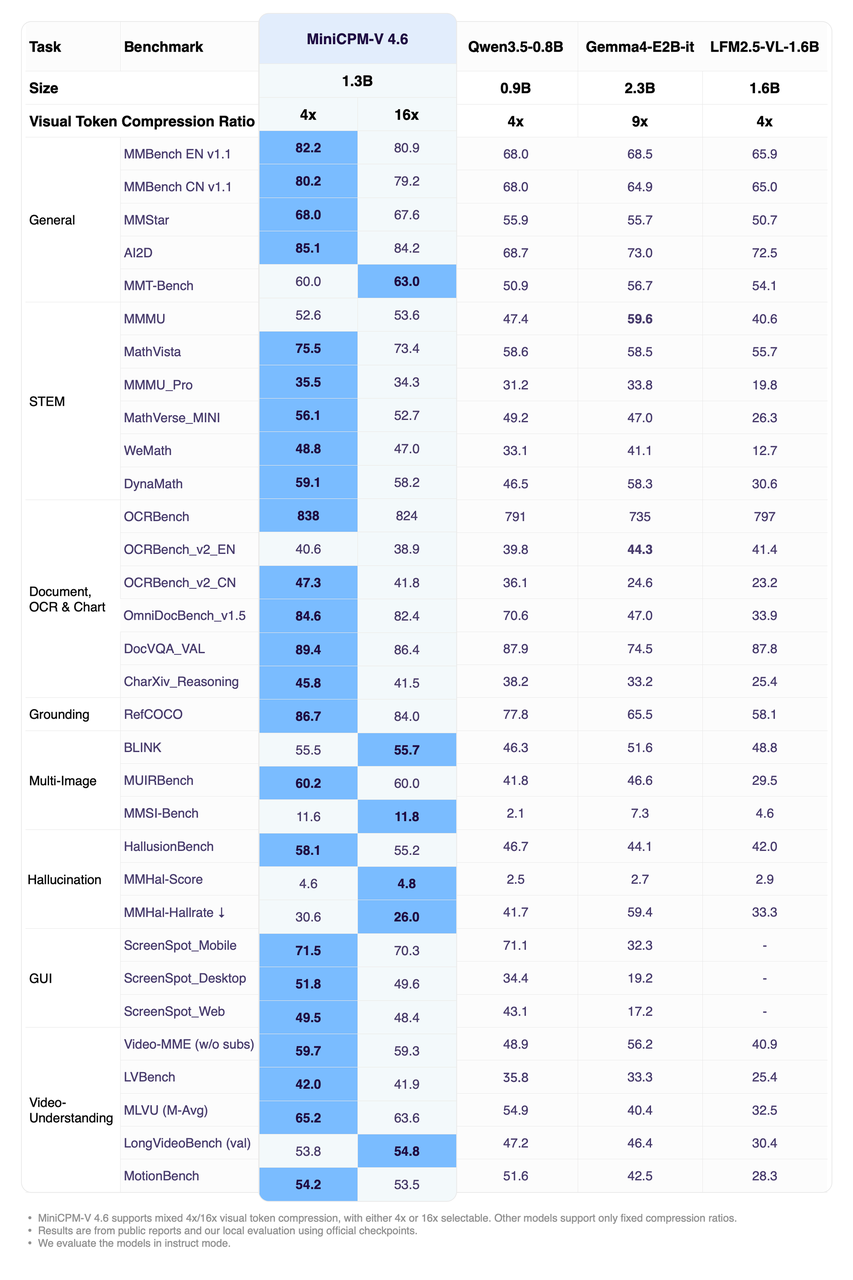
- 性能表现:在公开评测中,综合能力超越 Qwen3.5‑0.8B、Gemma4‑E2B‑it 等同量级模型。
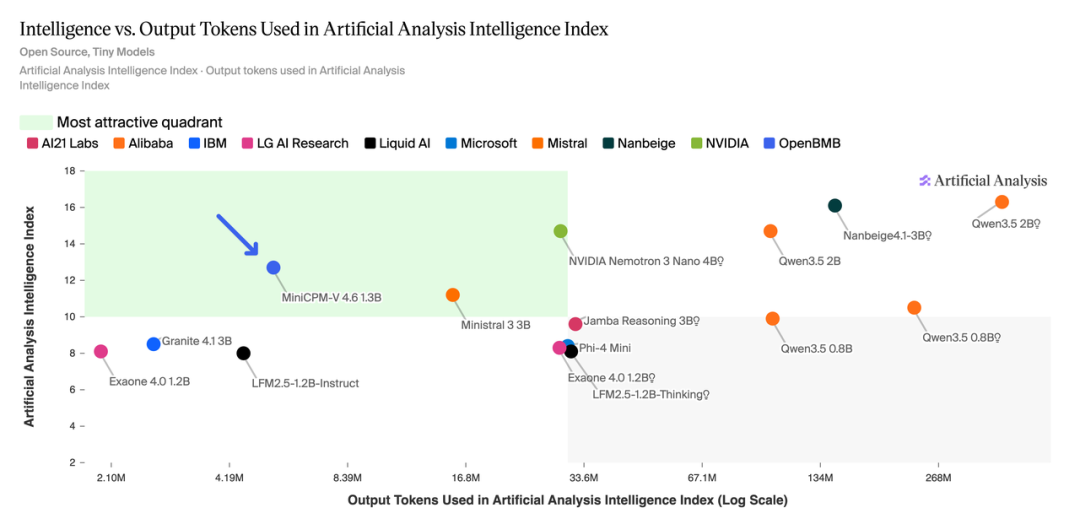
- 极致省资源:非推理版仅消耗 5.4M token,为 Qwen3.5‑0.8B 非推理版的 1/19、推理版的 1/43,显著降低算力成本。
该模型不追求榜单跑分第一,而是以低成本、低延迟、高吞吐满足真实业务需求。
二、技术突破:提前压缩视觉 token,兼顾效率与精度
MiniCPM‑V 4.6 实现轻量化的关键,在于LLaVA‑UHD v4视觉编码优化技术。
- 压缩时机前移:将视觉 token 压缩从 ViT 后提前到 ViT 内部,在视觉编码阶段就降低计算量,FLOPs 降低 55.8%。
- 无损压缩设计:采用早期 ViT 内压缩模块 + 窗口注意力,先做邻近 token 交互,再复用预训练参数,最小化图像表征损失。
- 混合压缩策略:支持 4 倍与 16 倍混合视觉 token 压缩,4 倍保精度、16 倍提速度,可灵活切换场景。
这套技术让模型在 “看得清” 与 “跑得动” 之间取得平衡,打破小模型性能差的行业偏见。
三、落地价值:覆盖端侧与云端高并发两大场景
MiniCPM‑V 4.6 瞄准 AI 规模化落地的核心痛点,适配手机、PC、车机、智能家居及云端高并发系统。
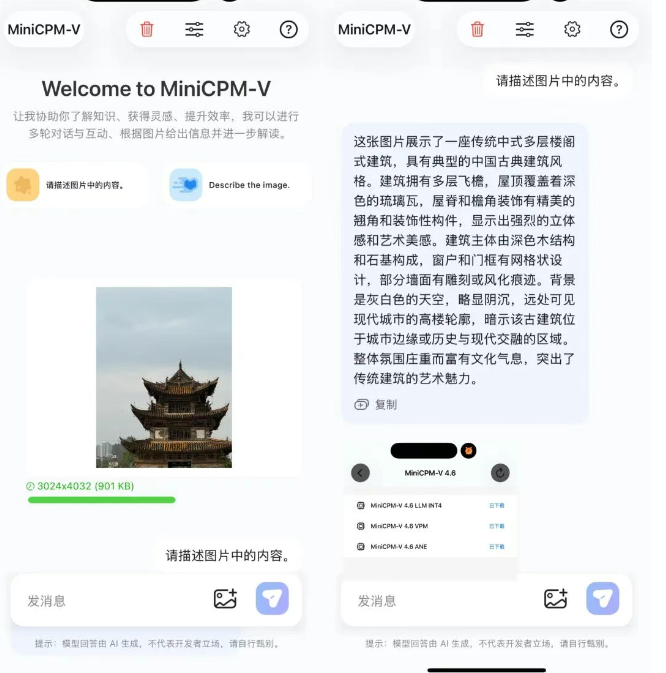
- 端侧设备:可直接在手机、普通电脑运行,满足本地相册理解、OCR、文档解析、摄像头异常检测等轻量化需求。
- 云端高并发:适合亿级请求场景,如推荐系统、内容理解、信息过滤等,以低成本提升系统整体效果。
- 产业应用:快手 OneRec 推荐大模型已采用 MiniCPM‑V‑8B 处理封面、字幕、OCR 等多模态信息,承接 25% 短视频主场景请求,验证小模型的商用价值。
四、生态完善:全流程工具链,降低落地门槛
面壁智能为 MiniCPM‑V 4.6 提供完整适配工具,大幅降低开发与部署成本。
- 微调支持:兼容 ms‑swift、LLaMA‑Factory,RTX 4090 等消费级显卡即可完成微调。
- 部署适配:支持 vLLM、SGLang、llama.cpp、Ollama 等主流框架,开箱即用。
- 定位清晰:不作为通用聊天助手,而是作为可定制、可嵌入的模块化 AI 组件,服务垂直场景。
五、行业启示:AI 走向实用化,小模型成关键基建
当前 AI 行业过度聚焦 “最强模型”,但真正推动 AI 普及的是稳定、便宜、随处可用的端侧小模型。
MiniCPM‑V 4.6 证明:小参数多模态模型可成为 AI 系统的 “水电煤”,在不被用户感知的底层,持续提升效率、降低成本。随着端侧 AI 普及,轻量化、高性价比的小模型将成为 AI 落地的核心力量,推动 AI 真正融入现实世界。
 AI 速览