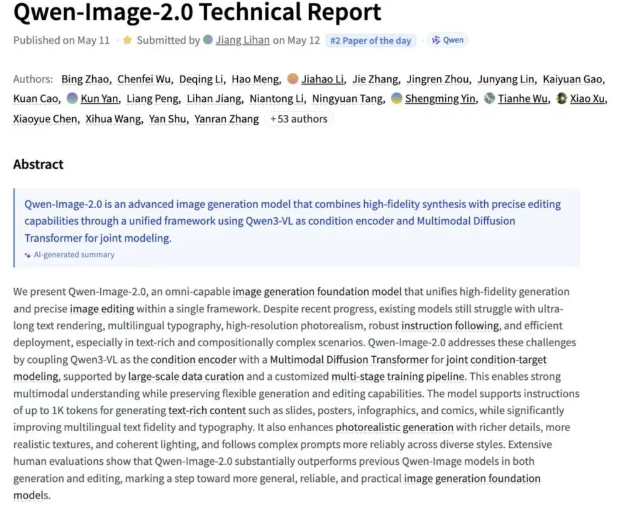
阿里通义千问团队正式发布Qwen-Image-2.0技术报告,该模型将高保真图像生成与精准图像编辑融合为单一框架,支持最长 1K token 指令输入、原生 2K 分辨率输出,可一键生成 PPT、海报、漫画等专业视觉作品,上线即登顶 Hugging Face 当日热门论文,成为多模态图像生成领域的重要突破。 一、核心突破:生成与编辑双能力统一框架
Qwen-Image-2.0 彻底改变此前生成、编辑两条技术线独立发展的模式,实现生成 + 编辑一体化。
- 整合定位:作为全能图像生成基础模型,在同一架构内完成文生图、图生图、单图编辑、多图修改、风格迁移等全流程操作。
- 流程革新:告别 “先生成再编辑” 的分段操作,降低设计工作流切换成本,大幅提升内容生产效率。
- 技术底座:采用Qwen3-VL 多模态视觉语言模型作为条件编码器,搭配MMDiT 多模态扩散 Transformer联合建模,兼顾指令理解与图像合成能力。
- 图像编码:使用 f16c64 配置 VAE,16 倍压缩率,兼顾画质与文本清晰度,在标准数据集上表现优异。
二、场景能力:1K 指令 + 原生 2K,适配专业创作
该模型面向真实办公与设计场景,突破传统文生图模型的关键限制。
- 超长指令理解:支持最高1K token文本输入,可完整描述布局、配色、元素、文字等复杂需求,直接生成专业信息图、PPT、海报、漫画。
- 高分辨率输出:支持原生 2K(2048×2048) 直出,人物纹理、建筑细节、光影效果更真实,无需后期超分。
- 轻量化设计:模型参数量约7B,在兼顾全能能力的同时保持轻量化,推理速度更快,具备本地部署潜力。
三、训练体系:四阶段全流程优化
Qwen-Image-2.0 构建覆盖生成与编辑的完整训练管线,保障效果与实用性。
- SFT 监督微调:用高质量标注数据完成基础能力对齐。
- RLHF 奖励模型:评估生成质量,优化内容贴合度。
- GRPO 扩散强化学习:创新应用于扩散模型,精细优化生成策略。
- 少步蒸馏 / DMD:压缩推理步数,提升部署与运行速度。
这套流程让模型在多任务场景下保持稳定表现,兼顾效果与效率。
四、社区焦点:权重暂未开源,行业高度期待
Qwen-Image-2.0 技术细节公开后,社区核心关注点集中在开源进度。
- 社区热度:论文发布当日登顶 Hugging Face 热门论文,业内关注度极高。
- 开源惯例:Qwen-Image 系列此前采用 Apache-2.0 协议开源,权重与 Demo 均公开可查。
- 当前状态:2.0 版本权重暂未释放,官方未给出明确上线时间。
- 行业推测:社区参考 Qwen 系列 “先发布报告、后开放权重” 的节奏,普遍预计后续将逐步开放。
五、行业意义:定义下一代图像生成范式
Qwen-Image-2.0 的发布,标志多模态图像生成进入一体化整合时代。
- 范式转变:从单项能力堆叠,转向统一框架覆盖全工作流,减少工具切换与信息损耗。
- 竞争对标:与 GPT-Image、Seedream 等闭源系统同台竞争,展现国产多模态模型技术实力。
- 产业价值:为办公设计、内容创作、广告营销等场景提供更高效的 AI 工具,推动视觉内容生产智能化升级。
整体来看,Qwen-Image-2.0 以生成编辑一体化、超长指令理解、原生高分辨率等核心优势,重新定义了实用型图像大模型的标准,待权重开放后,有望全面赋能个人与企业级视觉创作。
 AI 速览