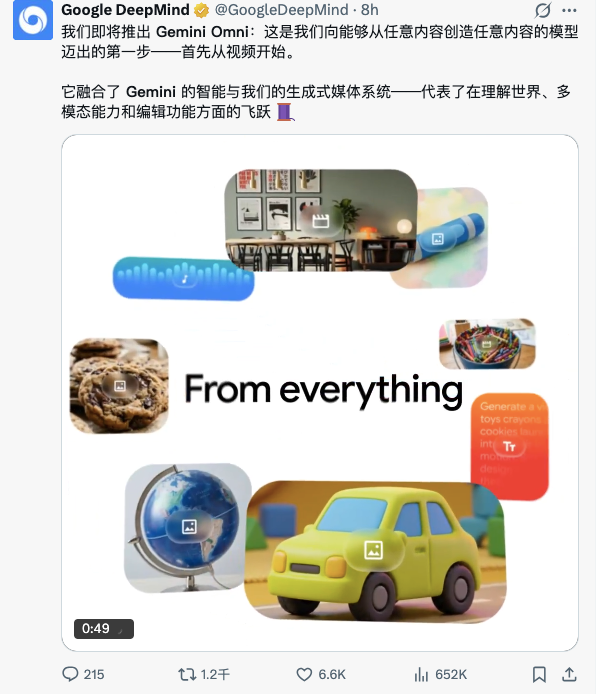
5月20日消息,Google 在 I/O 2026 上发布 Gemini Omni 模型系列,首发 Gemini Omni Flash,支持图像、音频、视频、文本四种模态混合输入,生成最长 10 秒、带同步音频的视频片段,并通过对话提示完成多轮编辑。模型即日起向 Gemini App 的 AI Plus、Pro、Ultra 订阅者推送,同步登陆 Google Flow,YouTube Shorts 与 YouTube Create 本周免费开放,开发者与企业 API 在未来几周接入。 从 Veo 主线拆分,Omni 接入 Gemini 核心
Omni 是 Google 把生成式视频从 Veo 独立产品线迁回 Gemini 主体系的标志。Google DeepMind CTO Koray Kavukcuoglu 在博客中将其定位为「从任意输入创造任何内容——从视频开始」的模型,他向 The Verge 表示,Omni Flash 比 Veo 携带「多得多」的世界知识,因为它直接调用 Gemini 的训练数据,而 Veo 严格只接受文本到视频。
与 Veo 的另一处分野在于:Omni Flash 可以把一段现有视频作为新视频的起点,而不是从零生成。早期演示包括一颗滚动弹珠在多次碰撞中保持物理可信度,并为每次撞击与铃声生成对应音效;另一个 demo 用黏土动画风格演示蛋白质折叠。Google DeepMind 高级研究总监 Dumitru Erhan 确认 10 秒是当前生成上限,产品管理总监 Nicole Brichtova 则称这是部署侧决策而非模型约束——算力紧张期先把访问面铺开,且大多数用户暂时不需要更长片段。
对话式编辑:角色一致与场景记忆
Omni Flash 的卖点不是单次生成质量,而是把视频编辑流程压缩进自然语言对话。每一轮指令叠加在上一轮基础上,角色形象、物理规律和场景上下文跨多轮保持一致。Google 展示的两个 prompt 颇具代表性:「把雕塑做成气泡材质」「当人触碰镜子时,让镜面像液体一样涟漪,人的手臂变成镜面反射材质」——这类指令在传统视频生成模型里需要重新跑一次完整任务,Omni 则把它当成对话续写。
角色一致性是过去视频生成模型的硬伤,Omni 通过一次定义、跨光照与动作保持视觉一致来解决,辐射到广告、叙事和游戏原型场景。模型还支持以参考素材应用风格、动作或特效,以及对自拍视频做风格化改造,可创建个人「Avatar」插入视频——这是对 OpenAI 已下线的 Sora App 同类功能的直接回应。 分发优先:YouTube Shorts 成入口
订阅门槛上,Gemini App 路径需要 AI Plus 起步,起价 7.99 美元/月;但 YouTube Shorts 与 YouTube Create App 本周开始向所有用户免费开放,这是 Google 在视频生成赛道独有的牌。Demis Hassabis 此前的表态在这次发布上落地——Search、YouTube、Workspace、Chrome 构成纯 AI 创业公司无法对标的整合面。
命名也透露架构野心。Flash 在 Google 体系里一向指代为消费侧优化的高效推理模型,把 Flash 放在 Omni 系列首发位置意味着完整版 Omni 仍在路上,Brichtova 已确认 Omni Pro 在规划中,会在模型能力出现「相对 Flash 的阶跃」时推出,具体时间未公布。Omni 与 Gemini 3.5 Flash、智能体 Gemini Spark 同场发布,共同构成 Google 此次的 agentic 推进。
竞品格局:质量未领先,但路径不同
Omni Flash 进入的是 AI 视频最拥挤的赛段。字节 Seedance 2.0 在公开质量基准上领先,可灵 Kling 3.0 主导中文市场,独立测试者预判 Flash 的原始生成质量未必能超过两者,但其对话式编辑维度更强。OpenAI 有 Sora,Runway 有 Gen-4.5,自家 Veo 3.1 本身也被业界视为最强视频生成模型之一。 Omni 的差异化不在跑分,而在它从一开始就不打算作为独立产品出现——它内嵌在 Search、Gemini App、Flow 和 YouTube 里,直接吃 Google 已有的入口流量。这也是为什么 YouTube Shorts day-one 免费开放被外界视为策略本体而非附加项。开发者侧的看点在未来几周的 API 开放,角色一致性和重混(remix)能力对广告、娱乐、教育的二次开发应用面较明确。
局限与未开放部分
10 秒生成上限是当前最明显的产品边界,对纪录类、长叙事类需求不友好,Google 称会扩展但未给时间表。音频与语音编辑能力被刻意压住——Google 表示在「能负责任地交付给用户」之前不开放,这意味着用户暂时无法用 Omni 改语音内容,只能编辑画面侧。
所有 Omni 生成视频强制带 SynthID 隐形水印,可通过 Gemini App、Chrome 内 Gemini 与 Google Search 验证。Google 在 I/O 上称 SynthID 已为超过 1000 亿张 AI 生成图像和视频打标,OpenAI、ElevenLabs 与 Kakao 正在采用该标准。环绕 Omni 的若干技术指标(训练规模、推理成本、与 Veo 共享多少底层)Google 未披露,模型卡尚未发布。
下一个观察点是 API 开放后 Omni Flash 在开发者侧的真实表现——尤其是角色一致性在多轮长链条编辑中是否稳定,以及当 Omni Pro 落地时,Google 是否会把对话式编辑这条护城河进一步拉大。
 AI 速览