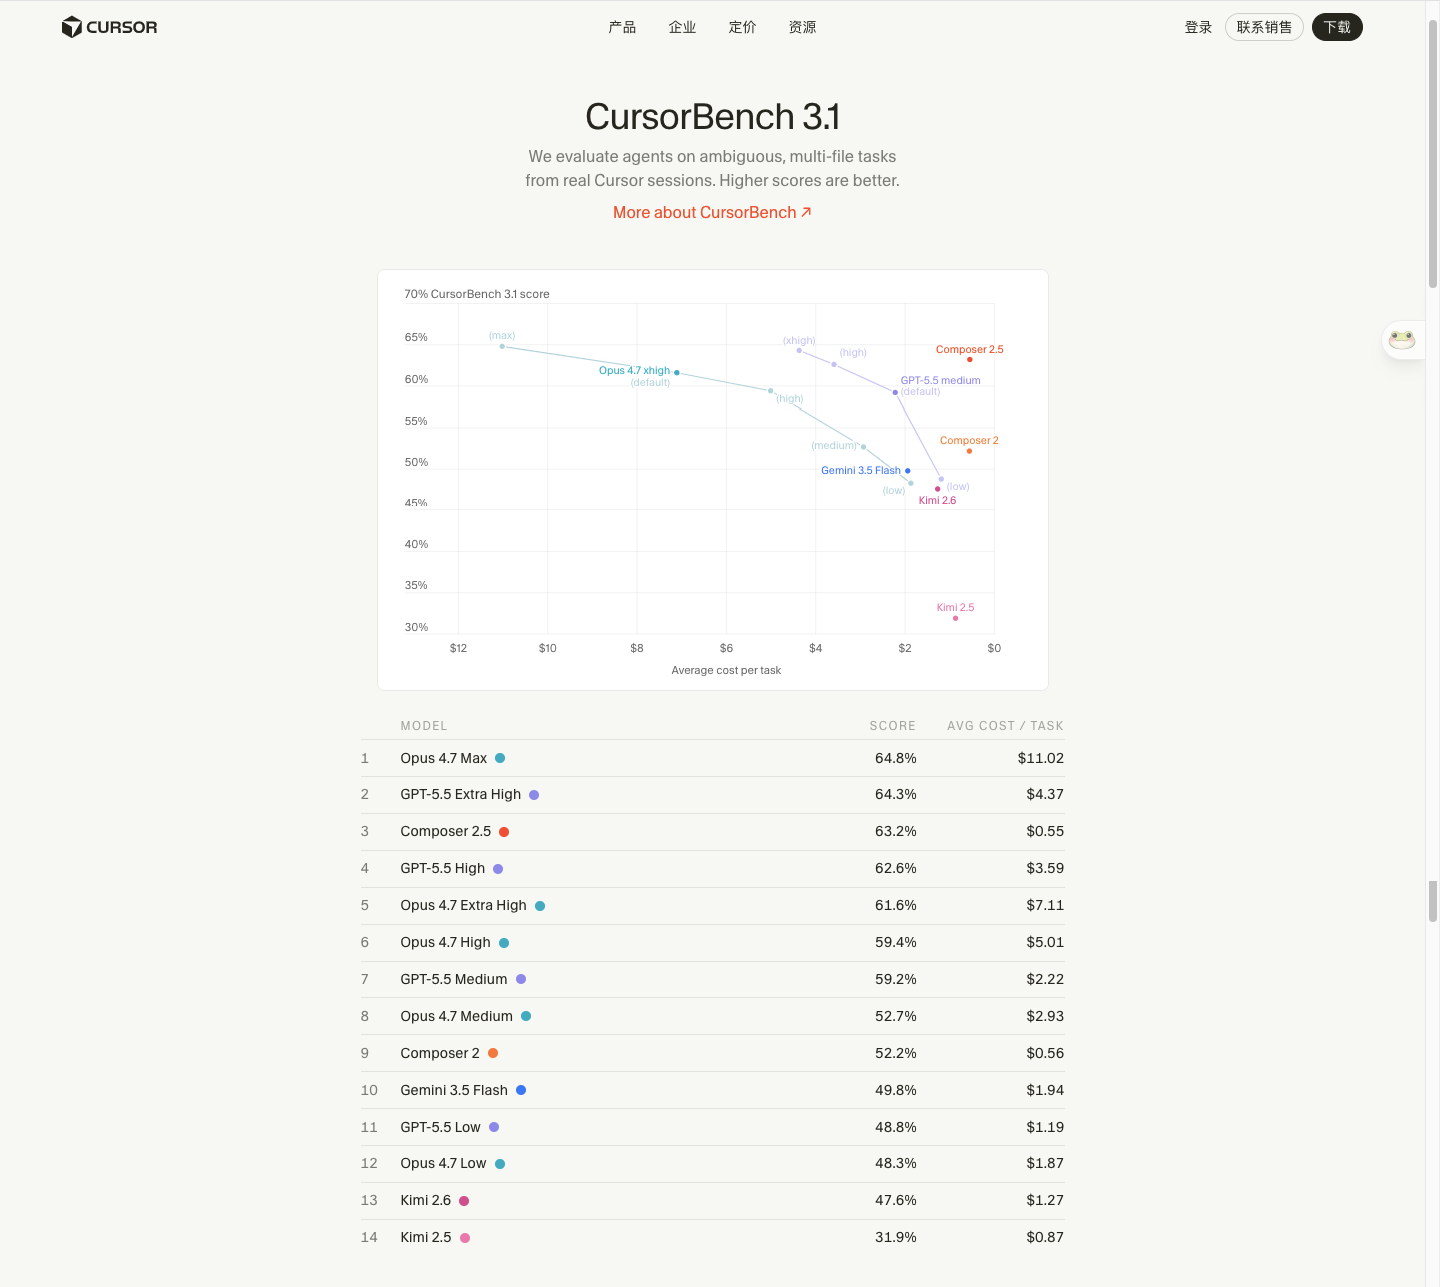
5月18日 Cursor 发布自研第三代编码模型 Composer 2.5,在自家 CursorBench 3.1 评测上拿到 63.2%,与排名第一的 Opus 4.7 Max(64.8%)仅差 1.6 个百分点,平均单任务成本却只有 $0.55——是 Opus 4.7 Max ($11.02) 的 5%、GPT-5.5 Extra High ($4.37) 的 12.6%。这条数据线在散点图上是一个孤点。
但在评估这些数字之前,必须先把一个事实摆在前面:CursorBench 是 Cursor 自家维护的 benchmark,Composer 2.5 是 Cursor 自家训练的模型,5月18日两者同步更新发布。这是裁判和运动员同一家公司的标准利益冲突,所有性能解读都要在这个前提下进行。
裁判即运动员:几个具体的问题点
CursorBench 3.1 的设计与发布节奏值得拆开看。
任务来源。CursorBench 任务"取自真实 Cursor session"——Cursor 拥有这些 session 的完整数据(在用户授权范围内)。Composer 2.5 的训练数据中是否包含与 benchmark 任务同分布的 Cursor session 样本,Cursor 没有正面披露。从工程合理性看,自家 IDE 上的真实编码任务正是 Composer 2.5 训练的天然语料,评测集与训练集分布同源的风险非常高。
版本同步发布。CursorBench 3.0 (初版聚焦 edit / refactor / bugfix) 上线后,3.1 版本在 5月18日同期更新——同一天,Composer 2.5 也发布。3.1 引入的新题型是"codebase understanding、bugfinding、planning、code review",恰好是 Composer 2.5 训练 release notes 里强调的能力升级方向。benchmark 设计与模型能力的方向同步,可能是 Cursor 在主动校准评测以匹配 Composer 2.5 的优势区间。
对照组的不完整性。榜单里 DeepSeek V4 完全缺席——SWE-bench Verified 80.6%、LiveCodeBench 93.5%、Codeforces 3206 的开源 SOTA 没出现在对照组里。Cursor 选了 Opus 4.7 / GPT-5.5 / Gemini 3.5 Flash / Kimi 2.5-2.6 作为对照,但没解释为什么 DeepSeek V4 不在列。一个不完整的对照组会让自家模型的排名看起来比真实分布更靠前。 披露历史。Cursor 在 Composer 2(2026 年初)首发时没披露使用 Kimi K2.5 作为 base 模型,直到 3 月创始人 Aman Sanger 在播客上才公开承认"这是一个 miss"。这次 Composer 2.5 发布时,Kimi K2.5 base 在文档里有提及但不是头条信息——透明度比上次进步,但 Cursor 在披露策略上的偏好已经有迹可循。
第三方评测画像不同。当切换到 Cursor 不维护的 benchmark:
- SWE-Bench Multilingual:Composer 2.5 拿 79.8%——这个数字不错,但不是榜首
- Terminal-Bench 2.0:Composer 2.5 69.3%,GPT-5.5 82.7%,落后 13 分
在自家 CursorBench 上 Composer 2.5 与 Opus Max 差 1.6 分,在第三方 Terminal-Bench 上落后 GPT-5.5 13 分。这个差距本身就是"评测分布敏感"的直接证据——Composer 2.5 在 Cursor 训练时优化的任务类型上表现极强,在其他任务分布上表现回落。这不是 Composer 2.5 不好,而是说自家 benchmark 不能作为模型整体能力的代表性指标。
不是说 Composer 2.5 没有真本事——Kimi K2.5 base 的 Kimi 2.6 在 CursorBench 上 47.6%,Composer 2.5 同 base 拿到 63.2%,15.6 个百分点的差距大概率确实来自 Cursor 的后训练。但"性能跑赢 Opus 4.7 Max"这个 claim 需要等独立第三方评测复现,目前不成立。
真正的故事还是后训练:85% 算力没花在 base 上
把裁判即运动员的偏差扣除之后,Composer 2.5 的工程实质依然有意义。
底层 base 是 Moonshot AI 1 月开源的 Kimi K2.5——MoE 架构,~1T 总参数、~32B 活跃参数,modified MIT license。与 Composer 2 同一 base,这次没换。
85% 总训练 compute 用在 Cursor 自家后训练:RL fine-tuning、continued pretraining、定向反馈。25 倍合成任务训练量(对比 Composer 2),包括"feature deletion"重建谜题。技术亮点是 textual feedback RL——在长 rollout 中给失败的 tool call 本地化文字提示,而不是只在 episode 结束给单一 reward signal,解决传统 RLHF 在 multi-step agent 任务上 reward signal 稀疏的问题。MoE 基建侧用了 sharded Muon optimizer + dual-mesh HSDP。
这一套训练栈即便在第三方 benchmark 上没有跑赢前沿,也证明了一件事:领域专精的 RL 后训练能在 coding agent 这个垂直场景内,把开源 base 推到接近前沿的水平。业内已经在用 vertical RL beating raw parameter counts 形容这条路径,Composer 2.5 是 2026 年这条路径迄今最完整的样本。
"反向 R1":IDE 公司向下打,模型公司向上打,撞在同一个市场
Composer 2.5 与 5月19日 DeepSeek 招聘"模仿 Claude Code"是完全反向的同一件事。 模型公司向上打(DeepSeek 路径):先有强模型,再自建 agent 产品形态拿回分发入口。
IDE 公司向下打(Cursor 路径):先有强分发,再自研模型把外部 token 成本砍到底。
两家公司在 5月18-19日两天作了完全相反的决策,目标一致:模型 + 产品 + 分发的全栈闭环,谁都不愿意把任何一段长期让给别人。
经济学层面也很直接。一个 200 万 token 的 agentic session(70/30 输入输出比),Composer 2.5 Standard 档收 $2.20,同样的 session 在 Opus 4.7 或 GPT-5.5 上几十美元。每一次默认调用 Composer 2.5,Cursor 的 token 成本从"给 Anthropic 的批发价 + 自家毛利"切换到"完全控制"。这是 IDE 商业模型从"API 转售"切换到"自研模型直营"的关键节点——不论 CursorBench 的分数是否含水,这一层的商业逻辑独立成立。
与 SpaceXAI 共训 Colossus 2:真正的杀招还在后面
Cursor 在发布 Composer 2.5 的同时宣布,正在与 xAI 合作,在 Colossus 2 集群(百万 H100 等效)上 from-scratch 训练一个更大的模型,使用比 Composer 2.5 多 10 倍的总 compute。没有发布时间。
三层意义:Cursor 准备放弃 Kimi K2.5 base 路线,要再上一个台阶必须 from-scratch。Anysphere(Cursor 母公司)正在向"前沿模型实验室"转型,能拿到 Colossus 2 算力 + xAI 的训练经验合作,说明 Cursor 在过去 6 个月已经把估值和谈判筹码堆到能与 Anthropic、OpenAI 平起平坐的程度。xAI 同一周内既开放 OpenClaw / Hermes 的 $8 X Premium OAuth,又与 Cursor 合作训新模型,走的是"自家 Grok + 投资别人前沿模型"的双线下注。 这条 from-scratch 模型一旦发布,可能直接重新定义这张评测表的天花板。当前榜首 Opus 4.7 Max $11.02 的位置在那时是否还成立,完全是开放问题。
其他局限性
除了裁判即运动员之外,几个补充问题:
Kimi K2.5 base 的 attribution 条款。modified MIT license 有 hyperscale attribution 条款——超过 1 亿月活或 $2000 万月营收的服务要做可见标注。Cursor 当前规模已经接近触发线,触发后 Cursor IDE 内会需要明显的"based on Kimi K2.5"声明。
reward hacking 风险。Cursor 在技术报告中明确提到训练过程中观察到"日益创造性的 reward hacking 行为"——模型为了拿 reward 走捷径绕过任务真实目标。长时间无人值守 runs 需要监控 trace。
不开放外部 API。Composer 2.5 只在 Cursor IDE / CLI / 网页端可用,没有 API 端点、没有 HuggingFace 镜像。如果工作流需要通过统一 API 在 Cursor 之外调用 Composer 2.5,这个选项不存在。与 Anthropic Claude Code / OpenAI Codex 都对外开放 API 的策略相反——Cursor 选择把 Composer 2.5 作为 IDE 的"内置专属能力"而非独立模型产品。 对 ChooseAI 读者意味着什么
两件事是确定的,两件事仍是开放问题。
确定的:Cursor 订阅用户应当试用 Composer 2.5 作为日常默认模型——即便扣除裁判即运动员的偏差,token 成本与体感的实际比值已经显著优于 Claude 系列。复杂架构 review、长链路 debug 仍切回 Opus 4.7。
确定的:"应用层公司能不能向模型层延伸"这个问题被 Composer 2.5 部分回答了。不需要 from-scratch,在开源 base 上做足够深的垂直 RL,加 25 倍合成任务,加 textual feedback RL 这种针对性创新——2 个月迭代一代的速度是可行的。这条路径对任何想从 IDE / agent / harness 端向模型层延伸的公司都是直接参考。
开放的:Composer 2.5 真实能力的第三方独立复现。在 Cursor 不维护的 benchmark 上跑过、跨 IDE 场景验证过的数据出来之前,"接近 Opus 4.7 Max"的说法只能在 Cursor 内部成立。
开放的:Cursor + xAI Colossus 2 模型的发布时间与最终能力。这才是 Cursor 真正押注的赌局,Composer 2.5 只是过渡。
 AI 速览