过去这半年,AI 编程工具的榜单变化快到让人有点麻木。今天 Claude Code 力压众人,明天 Cursor 反超,后天 OpenAI Codex 又卷土重来。你光盯着分数,真的会晕。 好在 Artificial Analysis 最近发布了一份 AI 编程 Agent 的横向评测,算是给这场混战提供了一个更清醒的视角——不只看分数,还拆开了 Token 消耗、成本和执行时长,把几个主流 Agent 拉到同一标准下比了个清楚。
2026 年AI编程 Agent 实测
评测体系
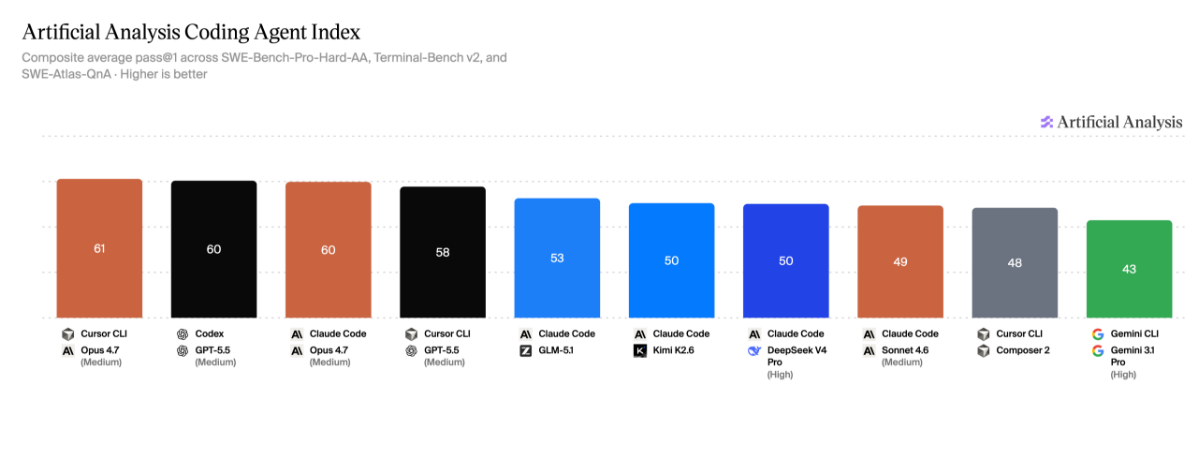
这次用了三项基准:模拟真实 Bug 修复的 SWE-Bench-Pro-Hard-AA、考察终端工具链使用的 Terminal-Bench v2,还有测试代码库理解能力的 SWE-Atlas-QnA。三个维度凑在一起,勉强能还原一个开发者日常会遇到的典型场景。
综合排名
排名第一的是 Cursor CLI 搭配 Claude Opus 4.7,综合指数 61 分;紧跟其后的是 Codex(GPT-5.5)和 Claude Code(Opus 4.7),都是 60 分。前三名差距只有 1 分,说白了已经内卷到毫厘之差了。 更有意思的一个发现是:把 Claude Code 底层模型从 Sonnet 4.6 升级到 Opus 4.7,综合分数直接从 49 跳到 60,拉升了整整 11 分。与其纠结用哪个客户端框架,不如先想清楚用哪个底层模型——这个结论可能有点反直觉,但数据就是这么说的。
Token 消耗
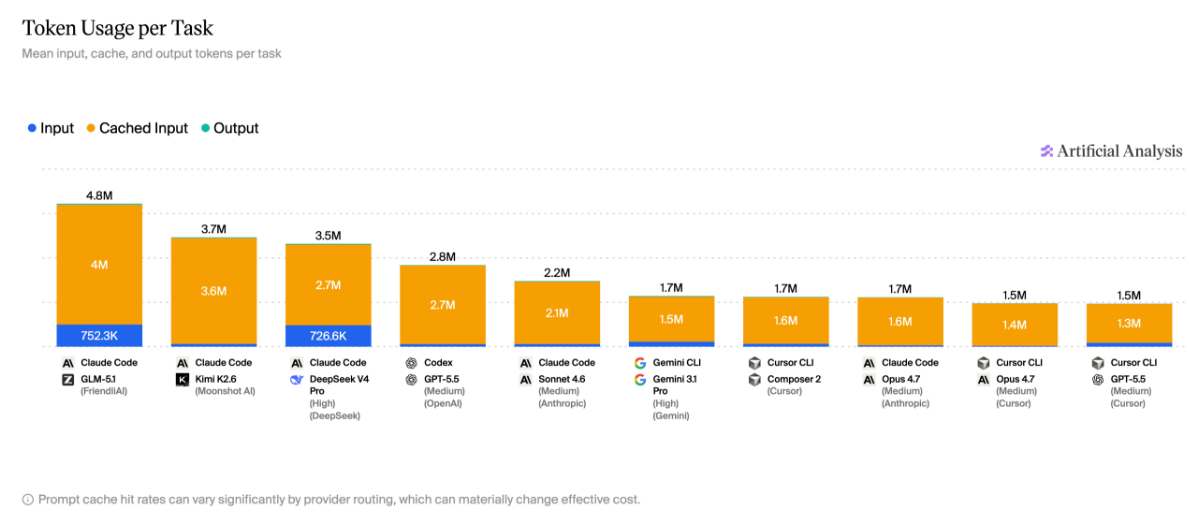
Token 用量这一项值得重点关注,它直接决定了你实际花多少钱。绝大多数消耗来自缓存命中,这会显著压低实际费用,但不同配置之间的差距依然很大。最耗 Token 的组合是 Claude Code + GLM-5.1,每任务高达约 4.8M,是 Cursor CLI + Opus 4.7(约 1.5M)的三倍多。
分数差不多的情况下,光是选对配置,成本就可以差出一个量级。
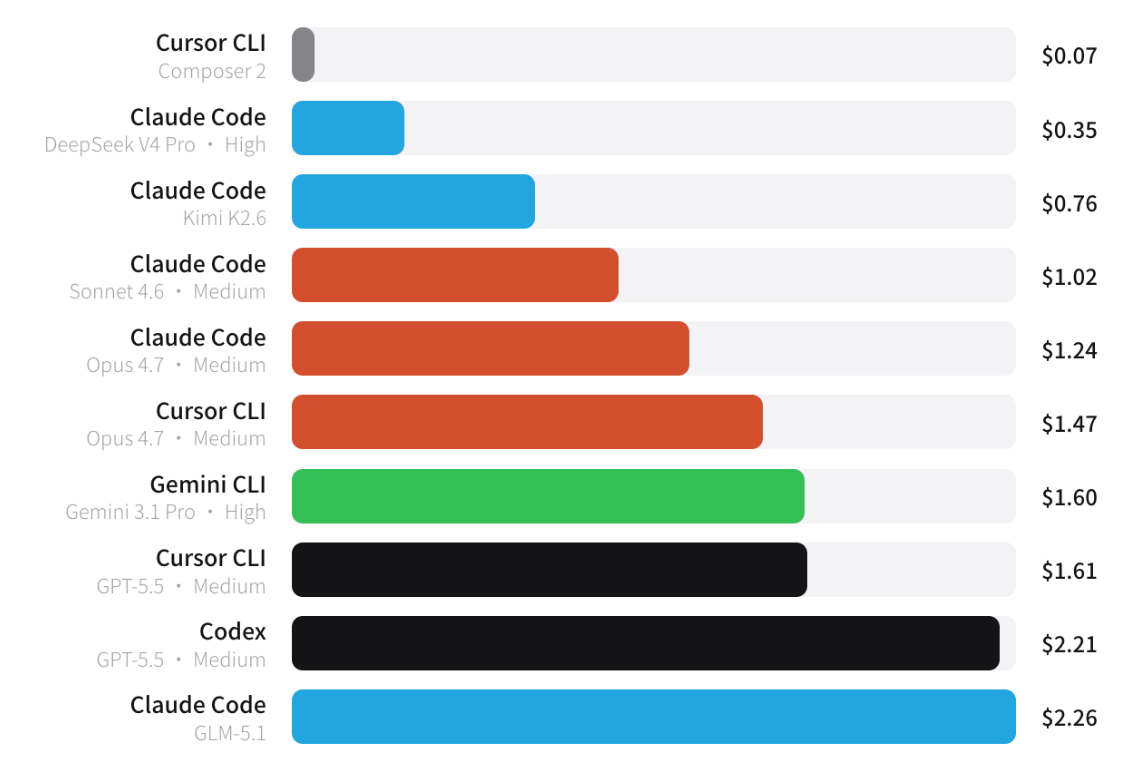
每任务成本
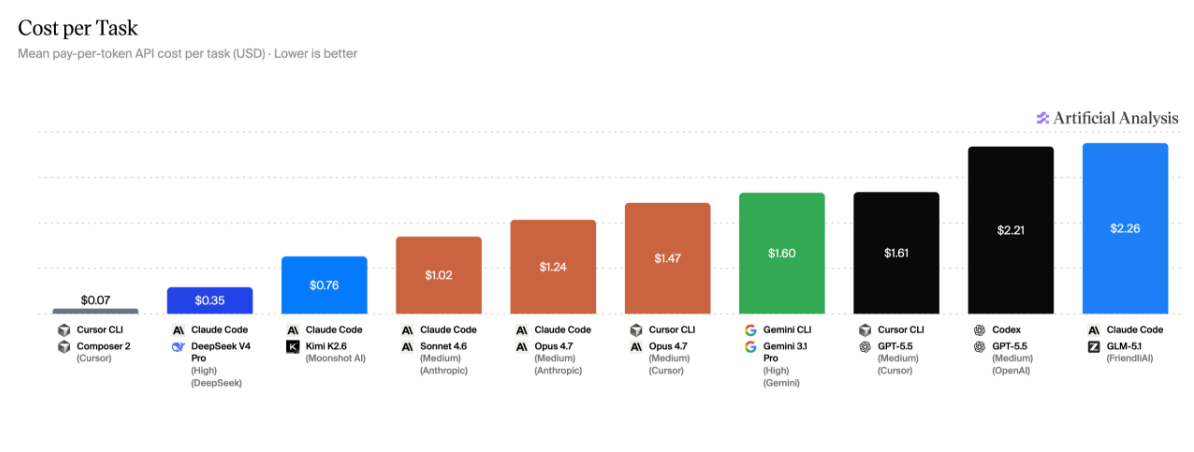
这一项的数字可能让你惊一下。最便宜的是 Cursor CLI + Composer 2,每任务只要 0.76。 再横向比一下:Claude Code + DeepSeek V4 Pro 花 2.21 才能拿到 60 分——前者只用了后者六分之一的钱,但达到了约 83% 的性能。低成本,真的可以不低分。 执行时间
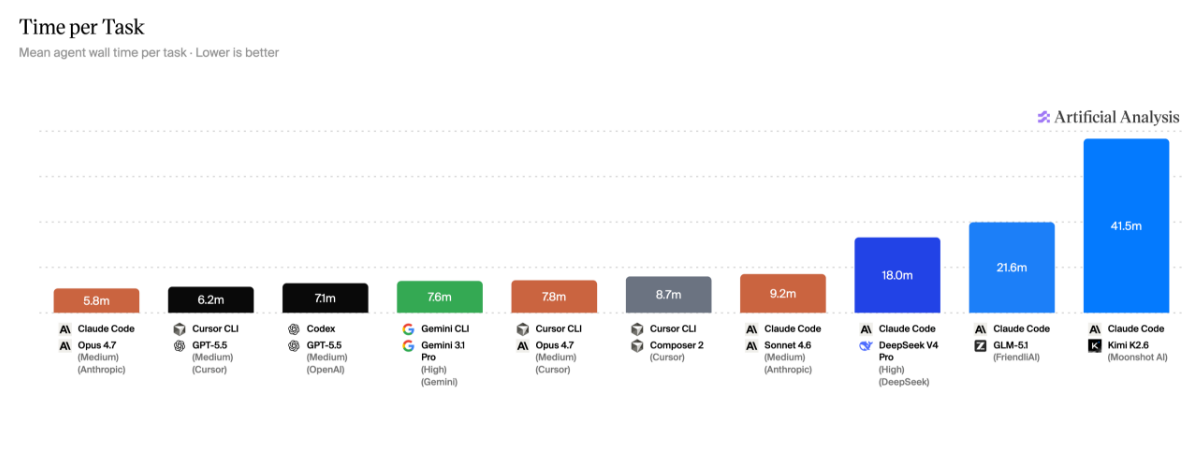
最快的是 Claude Code + Opus 4.7(Anthropic 直连),每任务只需 5.8 分钟,同时综合指数达到 60 分,可以说是又快又准。反观 Claude Code + Kimi K2.6,需要 41.5 分钟,是前者的七倍多,但分数同样只有 50 分——这背后很可能是推理调用链路偏长、API 响应延迟较高所致。如果你的场景是高频迭代,等待成本真的不可忽视。 国产模型的表现
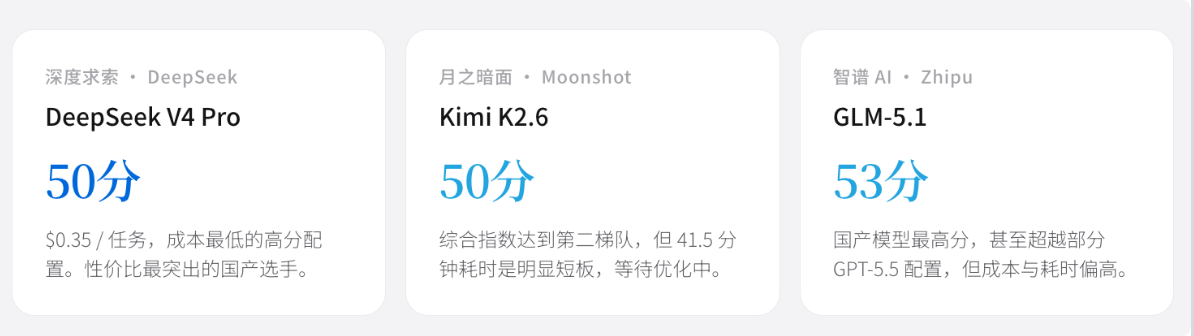
这次评测里有个让人觉得欣喜的信号:DeepSeek V4 Pro、Kimi K2.6、GLM-5.1 都登上了榜单,以 Claude Code 为框架底座跑出了实战级别的能力。
其中 DeepSeek V4 Pro 是最值得关注的那个——$0.35 每任务,综合指数 50 分,成本只有 Opus 4.7 方案的三分之一,性能进入第二梯队。对于预算有限或者调用频次很高的场景,这个组合相当有吸引力。
不过 Kimi K2.6 和 GLM-5.1 的情况有点复杂,作为 Claude Code 底座分数能到 50-53,不算差,但 Token 消耗最多、执行耗时最长。性能到了,代价也不小,实际用之前需要认真权衡一下。
一点感想
头部的性能竞争已经内卷到极致,前三名差一分,继续堆分数的边际价值正在快速递减。如果你是开发者,现在真正值得花时间想的问题,可能已经不是"哪个分数最高",而是:你的场景更看重速度、成本,还是某类任务的精度?
AI 编程 Agent 的分水岭,正在悄悄从"谁能做到"转移到"谁能做得又快又便宜"。
 AI 速览