谷歌 I/O 大会发布 Gemini Omni 世界模型后,迅速在全球 AI 视频圈引发热议。 不少网友将其与 Seedance 2.0 进行实测对比后,普遍吐槽 Gemini Omni 生成视频质感欠佳,缺乏电影级视觉表现,甚至质疑谷歌 AI 技术实力下滑。实则大众陷入了评价误区,两款模型定位截然不同,代表着 AI 视频行业两条完全不同的发展赛道。
一、Gemini Omni 口碑遇冷 大众直观体验落差明显
自 Gemini Omni 亮相后,在 Reddit、X 平台以及国内创作者社区中,负面评价扎堆出现。
用户实测发现,对比 Seedance 2.0,Gemini Omni 生成的视频缺少电影镜头感,画面氛围感、人物动态真实感都存在明显差距。
在普通用户认知中,AI 视频不仅要实现画面动态生成,更要具备真实的物理运动逻辑、镜头呼吸感。而 Gemini Omni 初期产出效果未能达到大众审美预期,这也让谷歌陷入了 “技术退步” 的舆论争议中。
二、Seedance 2.0:专注影视创作的导演型模型
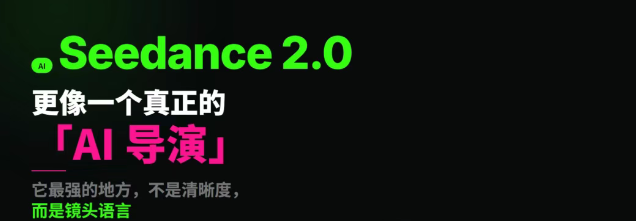
Seedance 2.0 精准定位AI 影视工业工具,主打导演级创作能力,完美契合短视频与影视创作者的核心需求。
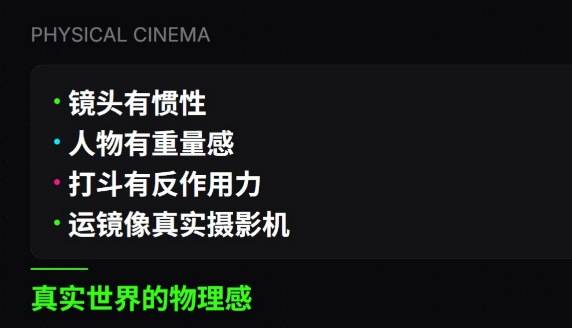
该模型深耕镜头语言优化,擅长把控运镜节奏、人物动作张力与画面稳定性,高度还原真实摄影的物理质感。
无论是人物奔跑的重心变化、衣物随风摆动的自然惯性,还是专业镜头的重量感都刻画细腻。它解决了传统 AI 视频人物、镜头画面 “悬浮虚假” 的痛点,做到画面符合现实物理逻辑,凭借极强的 cinematic 电影质感,迅速获得创作者群体认可。
三、Gemini Omni:布局底层科研的世界模型
谷歌并非没有打造影视级视频的技术能力,Gemini Omni 从研发之初就放弃了单纯追求画面审美,锚定世界模型底层布局。
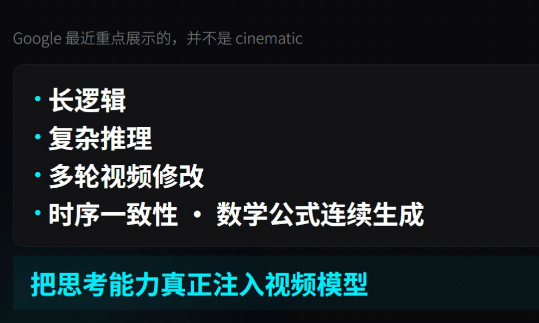
它的核心优势不在于镜头美学,而在于时序逻辑、世界状态记忆、长内容一致性、复杂逻辑推理以及多轮视频编辑能力。
不同于普通视频生成模型,Gemini Omni 将大模型推理能力融入视频系统,可实现长时间视频中公式推导、文字内容、空间逻辑全程连贯不崩坏。谷歌的目标不是做视频创作工具,而是打造能够理解、模拟真实世界的 “数字世界模拟器”,打造具备深度思考能力的视频 AI。
四、两大路线分化 决定 AI 视频行业未来格局
Gemini Omni 与 Seedance 2.0 的差异,是务实落地与底层科研的路线分歧。
Seedance 2.0 聚焦当下,优先满足创作者内容生产刚需,快速实现商业化落地;
Gemini Omni 着眼长远,攻坚世界理解、多模态记忆、逻辑推理等高阶能力。
从行业发展来看,镜头美学、运镜节奏等视觉效果可通过数据训练持续补齐,但模型对真实世界的认知与逻辑推理能力门槛极高。一旦 Gemini Omni 补齐画面表现力短板,依托强大的底层理解能力,有望重构 AI 视频行业规则。总而言之,当下 Gemini Omni 的观感劣势只是阶段性现象,不能仅凭表面视频效果否定谷歌的技术布局。AI 视频竞争已从简单画面生成,升级为审美体验与底层世界认知的双重较量,两条赛道并行发展,也将推动整个行业迈向更高层次。
 AI 速览