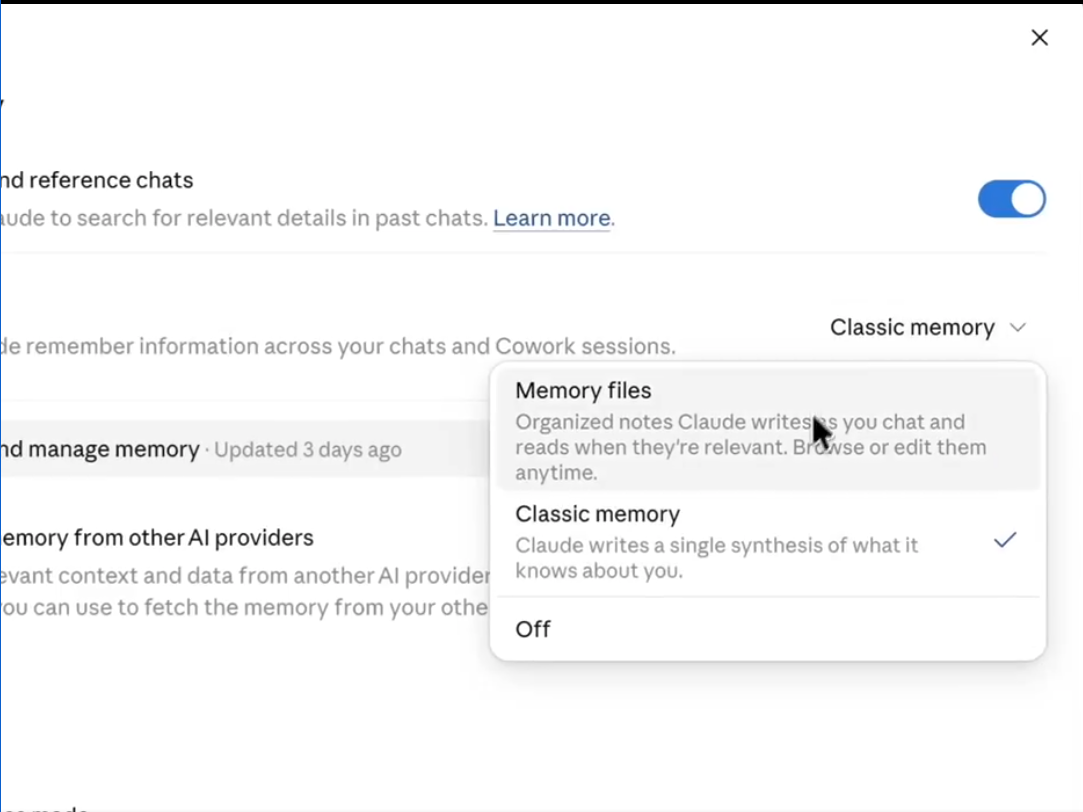
5月25日消息,Anthropic 正在测试 Claude 的新版记忆系统,核心变化是引入双模式架构——用户可在 Classic Memory(经典记忆)与 Memory Files(文件记忆)之间切换。前者沿用现有方案,把 Claude 在对话中学到的内容浓缩为一份滚动总结笔记;后者将记忆拆分为多个按主题、项目、上下文组织的结构化文档,由 Claude 在对话过程中自动写入、按需读取,用户可随时浏览与编辑。该功能被 TestingCatalog 等渠道捕获,目前处于内测阶段,尚未对全量用户开放,定位上被视为此前已被发现的"Knowledge Bases"功能的正式迭代版本。 从单条 summary 到结构化文件,记忆架构走向 filesystem
Claude 现行的记忆机制自 2025 年夏季上线、2026 年 3 月 2 日开放至免费层,基础形态是一份由 Claude 自动维护的滚动 summary——大约每 24 小时更新一次,记录用户的角色、偏好、长期话题,在新对话开始时被注入上下文。用户可在 Settings → Memory 中查看、编辑、删除全部条目,Incognito Chat 模式下记忆不写入也不读取。
Memory Files 的差异在于物理结构。新版本会把记忆切分为多个独立的 Markdown/笔记文件,按主题(如"工作偏好""技术栈""家庭日程")、项目(具体工作流)或上下文(对话场景)分目录组织。Claude 在对话中识别到需要记录的信息时,会写入对应文件;在后续对话中根据查询语义按需读取,而非全量加载。这一思路与 Claude Code 的 CLAUDE.md 体系、Anthropic 4 月对开发者平台 Claude Managed Agents 发布的 Memory tool 完全一致——后者已支持跨会话的文件目录持久化,允许 agent 在长时程任务中维护自己的笔记体系。 简言之,Claude 正在把 Claude Code 与 Managed Agents 已经验证过的 filesystem 风格记忆,搬到消费端聊天产品。
Dreams 功能可能下沉,后台 consolidation 进入消费端
与 Memory Files 同步出现的另一信号是 Dreams 功能的潜在下沉。Dreams 此前已在 Claude Managed Agents 的 research preview 中上线,作为一个定时、异步的后台进程,扫描已积累的记忆文件、合并重复条目、替换过时数值、解决冲突信息、识别此前未被捕获的模式。Anthropic 在文档中把这一过程类比为 REM 睡眠的 consolidation。
在 Claude Code 端,社区已观察到名为 Auto Dream 的对应实现——双门控触发(累计会话数 + 时间窗),单次合并可在 8-9 分钟内处理 913 个会话的记忆。如果 Dreams 同步进入 Claude 消费端,Memory Files 的长期可维护性将大幅提升,避免传统对话记忆随时间累积变得冗余、矛盾、难以检索的固有问题。
与 ChatGPT、Gemini 的差异:可见性优先于黑箱
横向对比,Claude 与 ChatGPT、Gemini 的记忆功能在表层能力上趋同——三者都支持跨会话持久化、用户查看与删除、临时会话不写入。差异主要在三处。
其一,可见性。Claude 在使用记忆时会显式提示"based on what I remember about you",ChatGPT 不主动告知何时调用了 memory。Memory Files 上线后,这一差异会被进一步放大——用户可直接打开文件查看每一条记忆的字面内容,而非只能信任系统给出的 summary。
其二,架构理念。ChatGPT 的 memory 倾向于"模型自动决定记什么",Gemini 类似;Claude 选择了显式的文件层,可被外部工具读取、修改,甚至被其他模型作为上下文使用。这一点对独立开发者和企业用户尤其重要——记忆数据不再被锁死在单一厂商的内部表征里。
其三,生态延续性。Memory Files 与 Claude Code 的 CLAUDE.md、Managed Agents 的 Memory tool 形成统一抽象,Anthropic 在文档、SDK、Skills 体系上的投入可以复用。OpenClaw、Hermes 等长期常驻代理框架早已选择 filesystem 风格的记忆持久化,Memory Files 实际上是 Anthropic 官方在消费端追平这一行业事实标准。
局限性:测试阶段、未官宣、隐私边界仍模糊
需要明确指出几点限制。其一,Memory Files 目前仍处于内测捕获阶段,Anthropic 并未发布正式公告,推出节奏、计费层级、是否对免费用户开放、是否与 Projects 功能合并,均无官方说明。本次披露主要来自第三方测试与 UI 内部字符串,功能形态在正式发布前仍可能调整。
其二,文件型记忆引入了新的隐私与合规问题。Claude 现行记忆已在文档中明确不建议存储 HIPAA、律师-当事人特权、SEC 监管覆盖的敏感信息。Memory Files 让记忆物理可见、可导出,在便利性提升的同时,也意味着账号被入侵或设备共享场景下的暴露面更大。企业版用户的 SSO、admin 工具是否覆盖 Memory Files 目录的访问审计,目前未知。
其三,API 端与消费端仍是两套体系。Claude Memory 功能目前仅作用于 claude.ai 与 Claude App,API 调用不带持久记忆层;开发者侧若要实现跨会话记忆,需自行集成 Memory tool 或外部存储。Memory Files 上线后,这一割裂是否会被打通(例如让 API 用户读取消费端记忆文件)仍是开放问题。 其四,Dreams 进入消费端的时间表不明。若 Memory Files 先行而 Dreams 滞后,用户可能在一段时间内面对越积越多、未自动整理的记忆文件,对手工维护意愿低的用户反而构成负担。
短期判断:Anthropic 在补齐"常驻代理"的最后一块拼图
把 Memory Files 放在 Anthropic 2026 年的整体节奏里看,逻辑相当清晰——Claude Code 的 Auto-Memory、Managed Agents 的 Memory tool 与 Dreams、消费端的 Memory Files,三条线指向同一个目标:让 Claude 成为可长期承载用户工作流与项目知识的常驻代理,而非每次都从零开始的聊天机器人。Memory Files 一旦正式上线,Claude 在消费端的产品定位将从"带记忆的聊天助手"明确转向"个人 filesystem 化的 AI 工作伙伴"。
 AI 速览