2026 年谷歌 I/O 大会正式推出Gemini Omni多模态模型,同时 Gemini 迎来版本大更新与界面 UI 改版。作为谷歌重磅升级的 AI 视频模型,Gemini Omni 在发布会上被寄予厚望,宣称重构视频创作与编辑体验。 本文结合真实实测体验,从版本更新、使用技巧、视频生成、编辑能力及使用限制等维度,客观拆解 Gemini Omni 的真实实力。
一、Gemini 版本核心更新亮点
本次 Gemini 更新有两大核心亮点
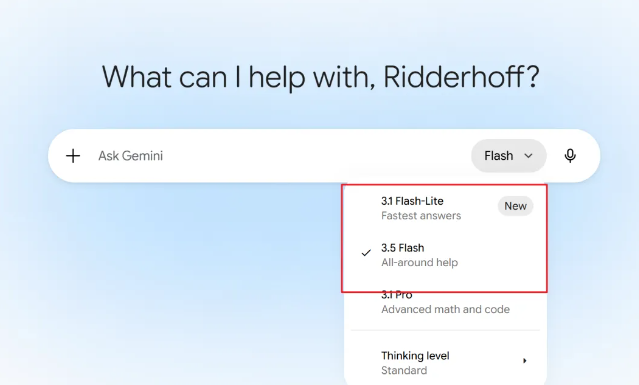
一是上线全新3.5 系列模型,运行速度较同类 AI 系统快 4 倍,综合性能全面超越以往专业版模型,覆盖日常问答、数理编程、全能辅助等多种场景,还提供 3.1 Flash-Lite、3.5 Flash、3.1 Pro 等多版本可选。
二是重磅落地Gemini Omni 多模态视频模型,这也是本次更新最受关注的功能。同时 Gemini 网页端界面全面焕新,设计风格更简约清新,新增对话搜索、视频库、快捷功能等板块,整体布局更贴合用户操作习惯。
二、极简使用小技巧,一键切换中文
很多国内用户困扰 Gemini 网页端默认外文界面,无需进入后台设置繁琐寻找语言选项,掌握一个简易技巧即可快速汉化:在浏览器地址栏的链接末尾,直接添加hl=zh后缀,页面就能瞬间切换为中文模式,省时又高效。
除此之外,平台还支持自定义思维等级,搭配不同模型版本,可按需适配极速应答、深度推理、专业代码运算等不同使用需求。
三、原创视频生成实测,不敌主流模型
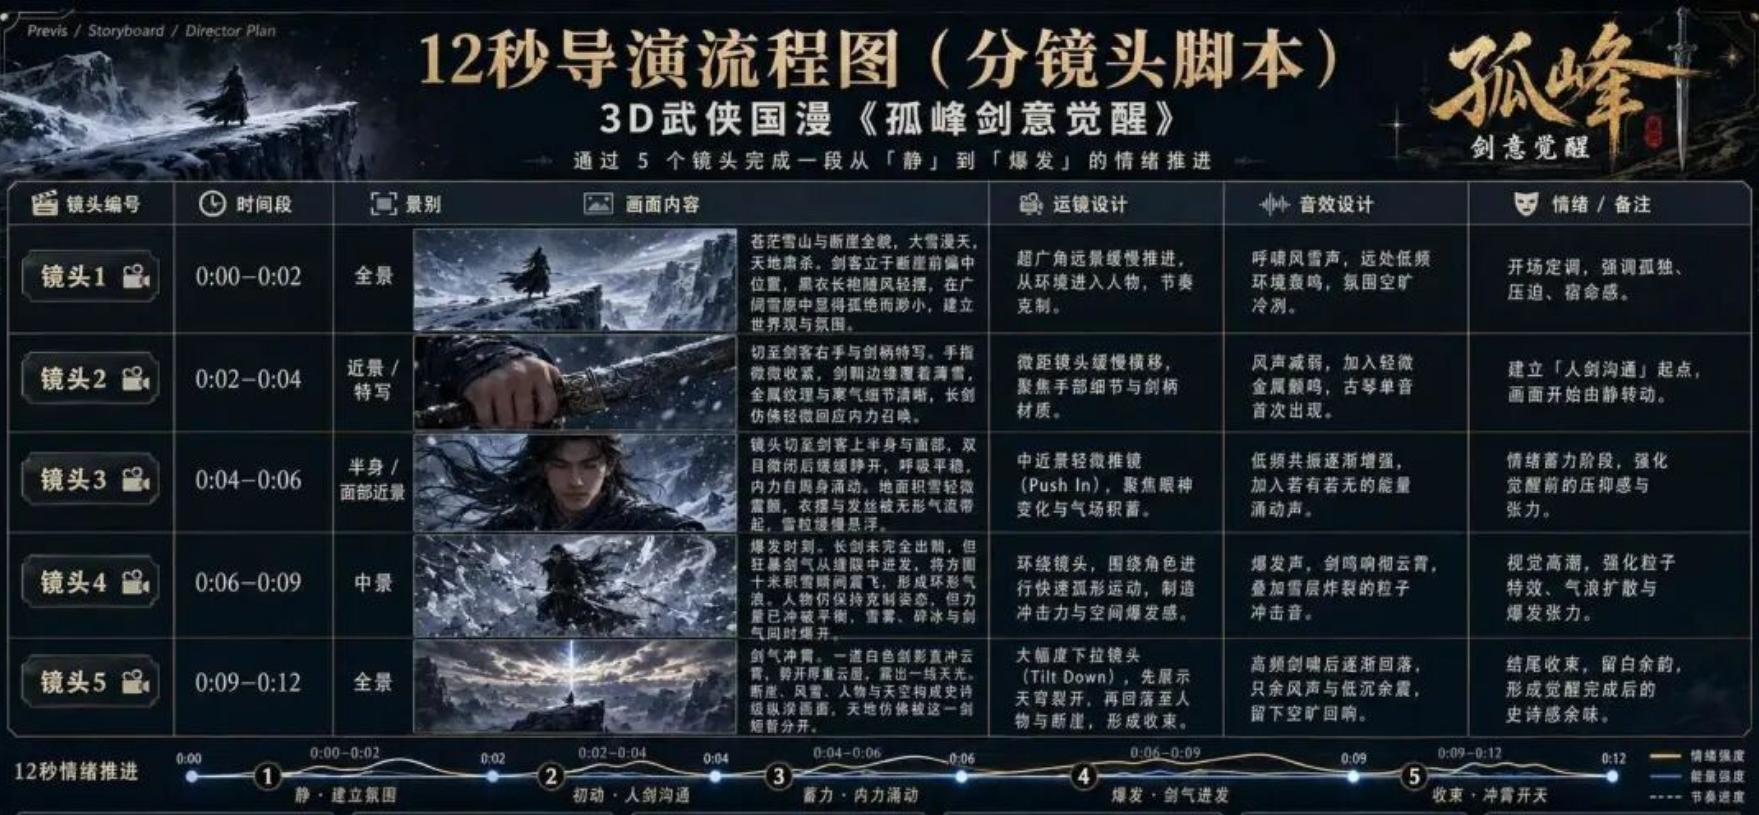
为客观测试 Gemini Omni 视频生成实力,采用同一张故事版分镜图、相同提示词,横向对比即梦(Seedance2.0 底层)与 Gemini Omni 的生成效果。 即梦依托 Seedance2.0 模型,能高度还原分镜构图与画面设定,成品质感优秀,综合评分可达 80 分,也是目前漫剧分镜视频创作的顶尖选择。
反观 Gemini Omni 表现较差,仅能识别少量分镜元素,无法按照分镜要求还原环境场景;视频最长仅支持10 秒生成,画面存在明显模糊、油腻的通病,清晰度堪忧,综合评分仅 60 分。如果想用它制作漫剧故事版分镜视频,目前并不推荐。
四、视频编辑与物理理解能力表现亮眼
谷歌发布会重点强调,Gemini Omni 核心优势在于视频智能编辑和物理世界规律理解,这一点在实测中得到印证。
在视频人物替换测试中,下达指令将视频人物替换为火焰鸟后,Omni 编辑后的画面和原视频场景、人物姿态高度统一,画面连贯性极佳。
官方物理轨迹演示里,玻璃球能严格遵循现实物理规则滚动,运动轨迹自然真实,相比上一代 V3 视频模型有显著升级。官方将 Gemini Omni 定义为视频版 Nano Banana,摒弃传统剪辑操作,只需下达语音文字指令,模型可延续上一条指令逻辑,保持角色、场景、物理规律的一致性。
五、额度限制与整体体验总结
实测发现 Gemini Omni 存在严格的额度限制,仅生成 3 个视频就被限制继续创作,页面直接跳转订阅付费界面。
即便账号当日整体用量仅消耗 39%,推测视频模型采用独立额度统计机制,免费使用权限十分有限。
综合整体体验来看,Gemini Omni 短板和优势十分鲜明:擅长依托已有视频做二次编辑、物理场景推演,但面对复杂提示词、多元素分镜图的原创视频创作,整体效果远不如 Seedance2.0。现阶段模型仍有较大优化空间,普通视频创作用户可暂时观望,等待后续版本迭代升级。
 AI 速览