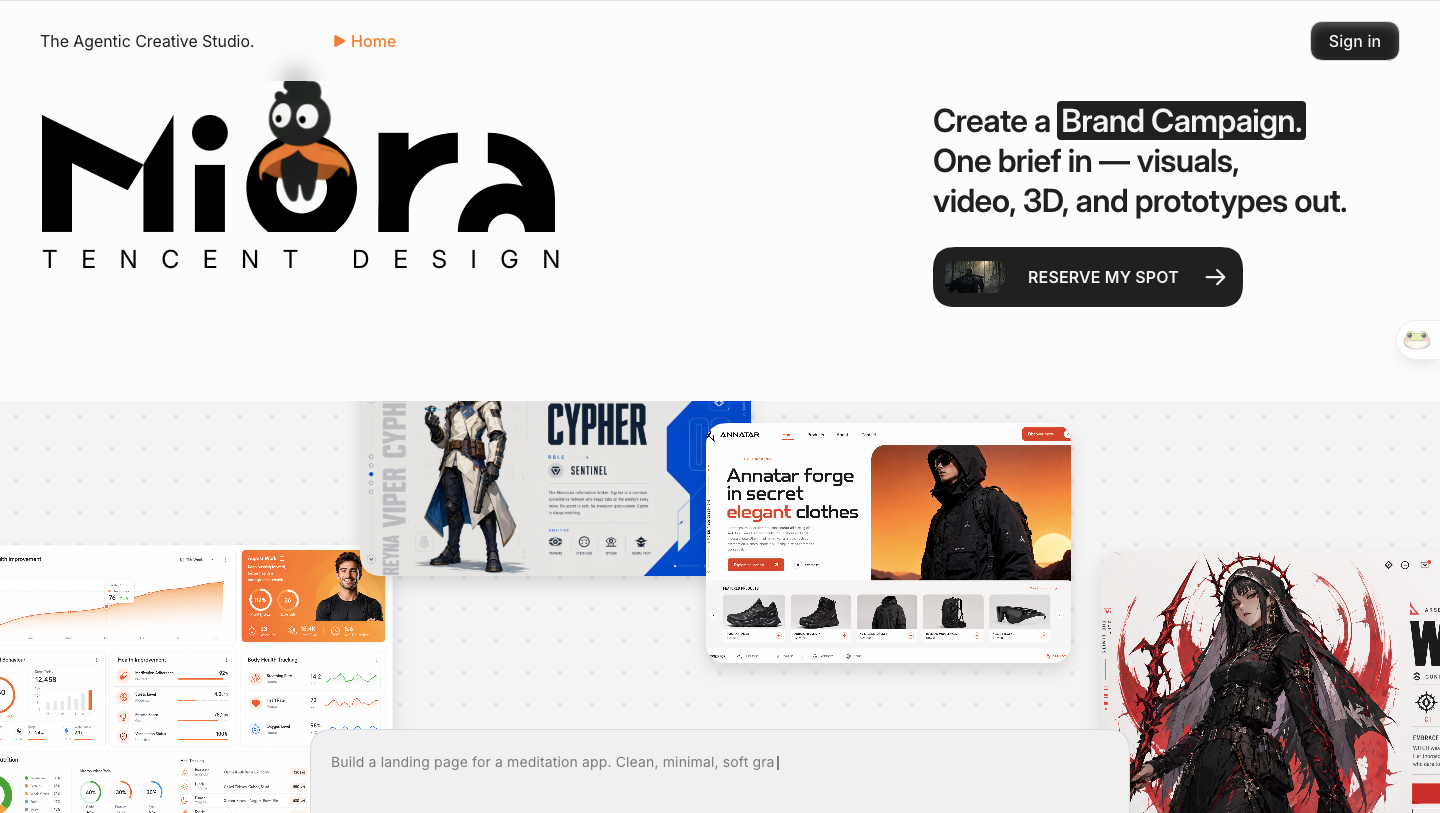
5月28日消息,腾讯推出"智能体画布"Miora 并开启国际公测:用户用自然语言描述需求,平台调用多个智能体自动完成复杂的全链路任务,把创意视觉、视频、3D、原型等设计工作收进同一块画布。 核心理念:一句话调度,一块画布
Miora 的产品主张可以概括为:图像、视频、UI/UX、3D 全在同一块画布上由智能体实时生成,无需在多个工具间切换、不丢失上下文,整个创意项目集中在一处。这与传统创作流程形成鲜明对比——后者往往要在生图、剪辑、UI、3D 工具之间反复横跳,每次切换都意味着资产搬运与上下文断裂。
Miora 试图用"自然语言描述 + 多智能体自动执行"把这些环节缝合成一条连续工作流。换句话说,用户给出的是意图,而非一步步的操作指令,链路的拆解与工具调用交给智能体完成。
智能体能力:理解语境、自主调用工具、记住偏好
Miora 的智能体能理解设计语境、进行问题推理、自主调用工具,而非被动执行单步命令;在编辑层面支持局部修补(inpaint)、局部编辑与背景拆分,满足精修需求,并能读取画布内容、记住用户偏好。
平台还内置技能系统(skills system),用户可使用现成技能、自行构建,也可与社区共享;配套一支专家智能体团队,分别负责品牌、分镜、插画、UI/UX、视频、3D 六个方向。这种"多智能体分工 + 统一画布协作"的架构,是 Miora 最具差异化的部分。
竞品格局:一个正在变拥挤的赛道
Miora 切入的方向并不孤独。CapCut Design Studio 基于无限画布重塑设计流程,Adobe Firefly Boards、Figma 的 AI 生成能力也都在向"AI 原生创意画布"靠拢。Miora 的差异点在于覆盖模态更全(尤其纳入 3D 与原型)、并以"自然语言调度多智能体"作为核心交互——它把竞品普遍停留在"AI 辅助生成单一模态"的能力,推进到"智能体自动编排全链路"。加上腾讯的资源与海外发行经验,Miora 的起点不低。 局限与前瞻
把已知信息摊开看:Miora 的产品形态是清晰的——自然语言驱动、多智能体分工、四模态单画布;但一个关键变量仍待验证——"实时生成图像/视频/UI/3D"对算力与生成质量要求极高,四类模态的成熟度大概率参差不齐,图像与 UI 可能较稳,视频与 3D 的可用性还需实测检验,目前缺乏第三方深度评测。
由此可以推出一个判断:Miora 真正的护城河不在"能做几种模态",而在"智能体能否把全链路任务接得足够顺"。统一画布和多模态生成,竞品迟早都能补齐;但"用户给一句意图,智能体自动拆解、调度、交付"这种编排能力,才是它区别于一众 AI 创意工具的关键。对中文创作者而言,值得做的是尽快上手实测各模态的真实水准与智能体的任务完成度,用第一手体验去填上目前评测的空白,而不是停留在功能清单。
 AI 速览