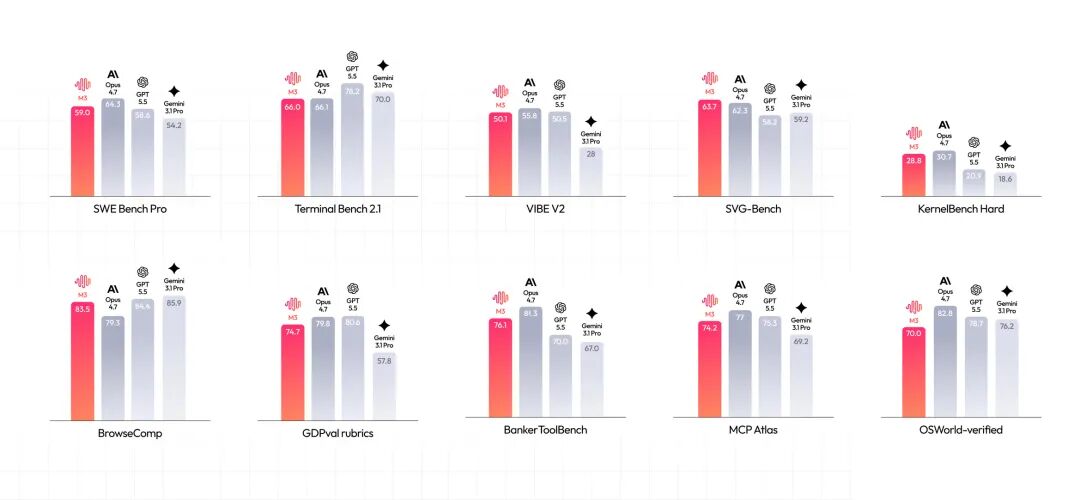
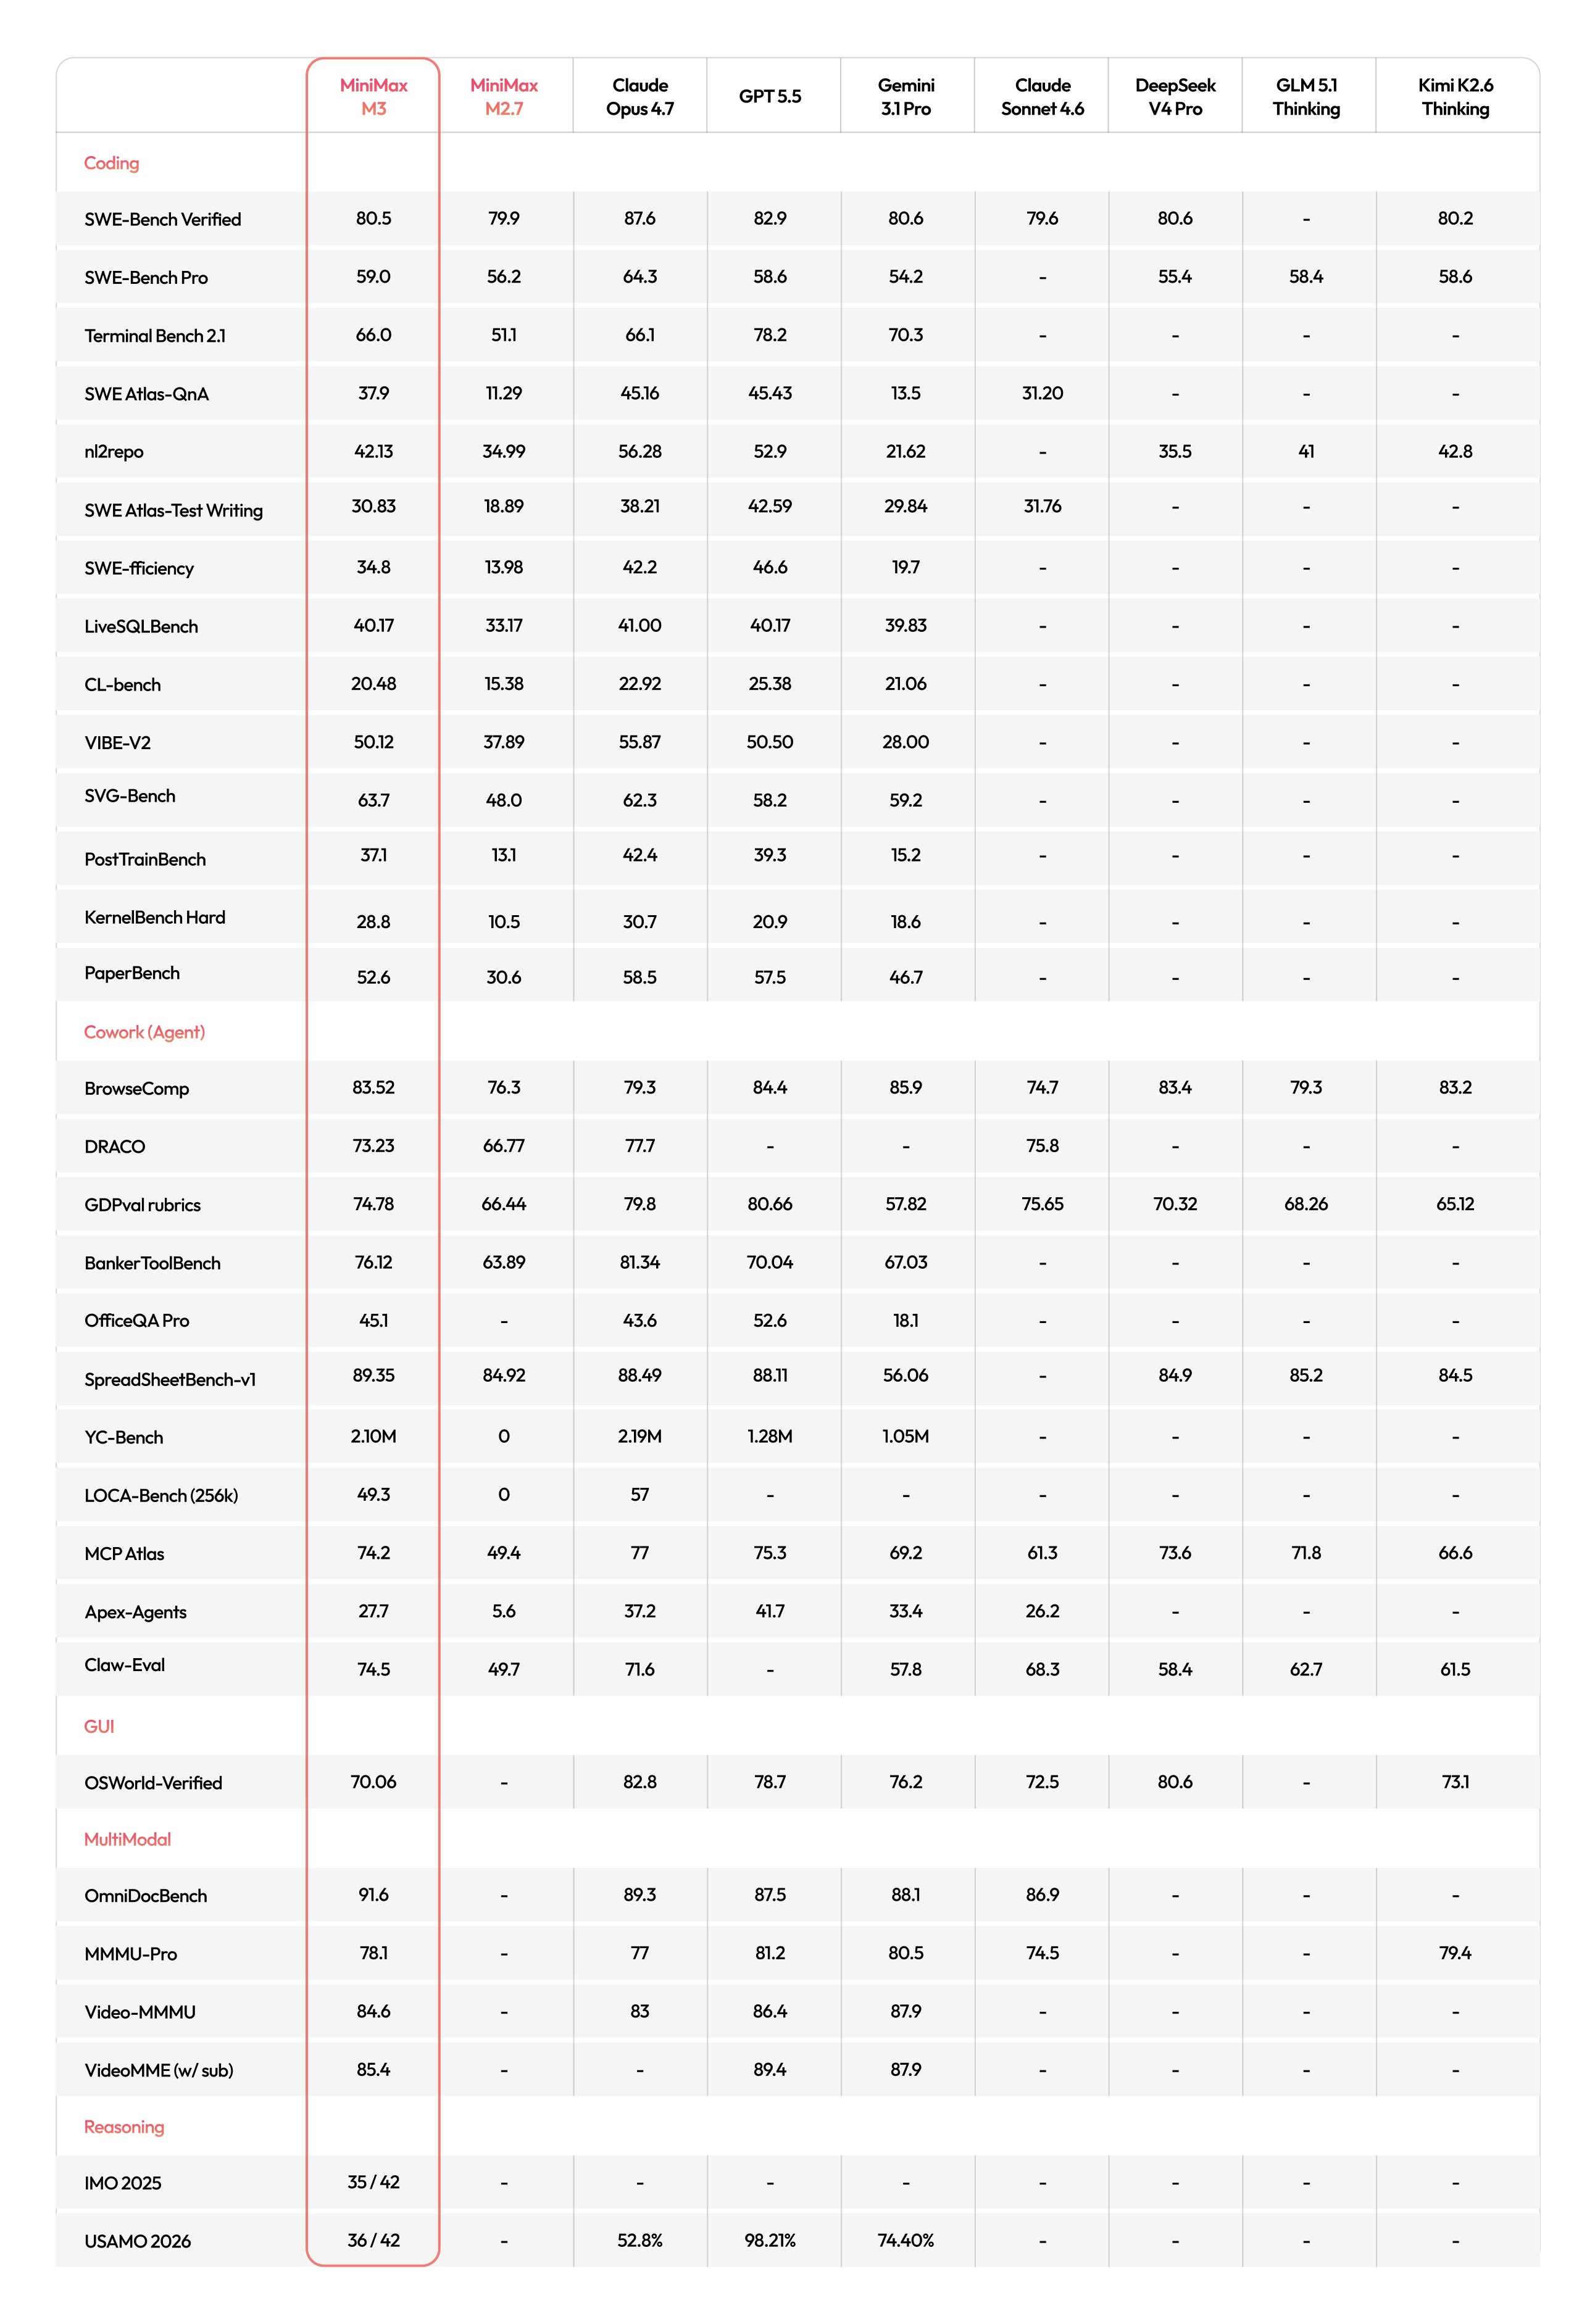
6 月 1 日,MiniMax 正式发布旗舰模型 M3,在编程、Agent、多模态三维度同时达到前沿水准。这是国内首个同时集齐编程超 GPT-5.5、1M 超长上下文、原生多模态能力的模型,也是目前唯一满足这三项要素的开源模型。
MSA 架构:从注意力机制突破上下文瓶颈
M3 的核心变化来自底层注意力机制。MiniMax 提出了全新的稀疏注意力架构 MSA(MiniMax Sparse Attention),以解决全注意力机制计算复杂度平方级增长的固有瓶颈。
与 DSA、MoBA 等方案相比,MSA 能更精确地为 KV 分块,实现更高的有效上下文覆盖。同时在算子层采用 KV 块外层聚合策略,每块只读一次、访存连续,在 M3 的 head 配比下,计算访存比显著优于 Flash-Sparse-Attention 和 FlashMoBA,实测快 4 倍以上。
这组设计使 M3 支持 1M 上下文窗口。在 100 万上下文下,M3 每 token 计算量仅为此前模型的 1/20,prefilling 阶段加速超 9 倍,decoding 阶段加速超 15 倍,且多项对照实验中 MSA 的能力与全注意力基本持平。
编程与 Agent:多维度评测领先
Coding 和 Agent 能力是 M3 本轮重点提升方向。在多个国际权威评测中,M3 取得领先成绩:
- SWE-Bench Pro:59.0%(超过 GPT-5.5 和 Gemini 3.1 Pro,接近 Opus 4.7)
MiniMax 同时构建了交互式用户模拟器框架,通过模拟真实开发者在协作过程中的需求补充、方案讨论、反馈修正和连续任务切换等行为,让模型在训练阶段就接触到更接近生产环境的交互场景,缩小 Benchmark 与真实使用体验的差距。
原生多模态:从 Step 0 开始混合训练
M3 从训练第一步开始就采用多模态混合训练方案。MiniMax 表示,交错数据(Interleaved data)对模型性能的提升比预期更关键。在重构数据管线后,M3 的训练数据 Token 规模已提升至 100 万亿量级。
在 OmniDocBench 多模态测试集上,M3 得分超过 Gemini 3.1 Pro;在面向自主 Agent 的端到端评测 Claw-Eval 上,M3 获得最高分。
实际任务检验:论文复现、算子优化、模型训练
MiniMax 用三个高难度任务验证了 M3 的综合能力。
在 ICLR 2025 获奖论文复现任务中,M3 自主运行近 12 小时,产出 18 次 commit 和 23 张实验图表,成功吻合 SFT 阶段的预测概率变化趋势,观测到 DPO 的 squeezing 效应,并验证了论文提出的 Extend 缓解方法。
在 CUDA 算子优化任务中,M3 从一份无法直接运行的 Triton 骨架出发,经过约 24 小时连续执行、147 次 benchmark 提交、1959 次工具调用,将 Hopper FP8 硬件峰值利用率从 7.6% 推进至 71.3%,实现 9.4 倍加速。值得注意的是,除 Opus 4.7 和 M3 外,其余模型均在前 30 次提交内主动退出,而 M3 的最优解出现在第 145 次提交。
在 PostTrainBench 上,M3 被要求在 12 小时内让四个仅完成预训练的 Base 模型在数学推理、工具调用、科学推理等任务上具备基本能力,全程无人干预。M3 得分 0.37,仅次于 Opus 4.7(0.42)和 GPT-5.5(0.39),明显领先其他模型。
定价与可用性
M3 即日起通过 MiniMax Code、Token Plan 和 API 提供服务。
Token Plan 分为三档:Plus ¥49/月(6 亿 token)、Max ¥119/月(18 亿 token)、Ultra ¥469/月(55 亿 token),官方称同等价格下约为 Claude 订阅的 15 倍用量。老用户原套餐价格保留。 API 按上下文长度分档计价,支持 thinking 和 non-thinking 两种模式,共享同一套定价。API(≦ 512k)上线即享限时 5 折,持续 7 天。
MiniMax 表示,未来 10 天内将发布技术报告并开源模型权重。
关键信号
M3 是国内首个同时突破编程超 GPT-5.5、1M 上下文、原生多模态三要素的模型,且选择开源。三个实际任务(论文复现、算子优化、模型微调)展示了其在长程自主执行场景下的持续性,而不只是 Benchmark 快照成绩。
MSA 注意力架构在 1M 上下文下的计算效率提升(每 token 1/20、prefilling 9 倍加速)意味着长上下文不再是算力奢侈品,而是可 scale 的训练维度。真实任务测试中 M3 在第 145 次提交才取得最优解,说明其具备在多轮失败后继续尝试不同路径的能力——这是 Agent 场景的关键品质,也是单轮 Benchmark 测不出来的维度。
M3 的定价策略(同等价格 15 倍用量)和开源承诺,指向一条明确的路线:用更低门槛争夺开发者心智,靠长上下文和 Agent 能力在应用层建立差异化。国内开源模型在 Frontier 三要素上首次对齐海外闭源标杆,接下来要看生态层的跟进速度。
 AI 速览