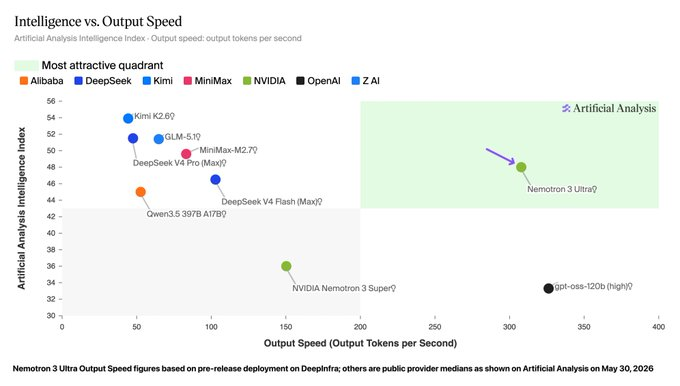
6月1日消息,英伟达在 Computex 2026(台北)黄仁勋主题演讲中正式发布 Nemotron 3 Ultra,这是 Nemotron 3 系列中规模最大的模型,也是目前美国发布的最大规模开放权重模型之一。Artificial Analysis 同步公布了与英伟达合作完成的独立评估数据。
核心规格:550B 总参数、55B 活跃、混合 Mamba-Transformer MoE
Nemotron 3 Ultra 采用混合 Mamba-Transformer 混合专家(MoE)架构,总参数量约 5500 亿(550B),每个 token 仅激活约 550 亿(55B)参数,稀疏率约 90%。这一架构延续了 Nemotron 3 系列的三项核心技术:LatentMoE(将 token 压缩至低秩潜在空间后再路由,以相同推理成本支持 4 倍专家数量)、多 token 预测(MTP,单次前向传播预测多个未来 token,提升思维链连贯性并内置推测解码)、以及基于 Mamba-2 层的 100 万 token 上下文窗口(线性时间复杂度,适用于长文档和智能体工作负载)。
该模型使用 NVFP4 精度进行预训练,当前评估基于 BF16 权重版本,后续将提供 NVFP4 量化版本以进一步提升推理性能。
智能评估:48 分登顶美国开放权重,仍落后于 Kimi K2.6
Artificial Analysis 智能指数评估显示,Nemotron 3 Ultra 得分 48 分,成为美国开放权重模型中的最高分。与同阵营模型相比:Gemma 4 31B 得 39 分、同系列 Nemotron 3 Super 得 36 分、OpenAI 的 gpt-oss-120b 得 33 分——Ultra 拉开了明显差距。
但需要注意的是,这一成绩仍落后于中国开放权重模型 Kimi K2.6(54 分)。Kimi K2.6 于 2026 年 4 月发布,采用 1T 总参数 / 32B 活跃参数的 MoE 架构,在 Artificial Analysis 智能指数中排名第四,仅次于 Claude Opus 4.7、Gemini 3.1 Pro 和 GPT-5.4(均为 57 分)。换言之,Nemotron 3 Ultra 虽然刷新了美国开放权重模型的纪录,但在全球开放权重模型排名中仍位于 Kimi K2.6 之后。 推理速度:300+ tokens/s,MoE 稀疏激活 + 硬件优化的效率优势
在推理速度方面,Nemotron 3 Ultra 在 DeepInfra 端点上实现了每秒超过 300 tokens 的输出速度(BF16 权重)。作为对比,同规模中国实验室模型(如 DeepSeek、Kimi 等)的市场典型速度为 50-100 tokens/s;gpt-oss-120b 速度相近但智能水平明显偏低。 这一速度优势主要来自两方面:一是 MoE 架构的高稀疏激活比(90% 参数不参与每次推理),大幅降低了计算量;二是英伟达对自家硬件(GB200 NVL72 等)的深度推理优化。英伟达官方基准测试显示,Ultra 基础模型在 GB200 NVL72 上相比 GLM-4.5-355B 实现最高 5 倍的吞吐量提升。
发布节奏与当前状态
Nemotron 3 系列的发布节奏如下:2025 年 12 月官宣整个系列并发布 Nano(30B 总参 / 3B 活跃);2026 年 3 月 GTC San Jose 发布 Super(120B 总参 / 12B 活跃)及 Ultra 基础检查点;2026 年 4 月发布 Nano Omni 多模态版本;2026 年 6 月 Computex 正式推出 Ultra 完整版本。
当前 Ultra 的基础模型(预训练检查点)已可获取,但尚未经过指令调优和对齐后训练,不适合直接作为助手部署。英伟达及合作伙伴已确认完整指令调优版本及 NVFP4 量化版本将于本周内更广泛发布。DeepInfra 等平台已提供预览和测试。
局限与风险
首先从模型成熟度来看,当前公开的 Ultra 仍为基础检查点,缺少指令调优和 RLHF 对齐,在实际生产环境中的表现(指令遵循、安全性、幻觉率等)有待完整后训练版本验证。Nemotron 3 Super 从基础模型到可用后训练版本经历了约三个月迭代周期,Ultra 的后训练版本能否在短期内达到同等可用性仍需观察。
其次从智能水平来看,48 分的智能指数虽然领先美国开放权重模型,但与闭源前沿模型(Claude Opus 4.7、Gemini 3.1 Pro、GPT-5.4 均为 57 分)仍有 9 分差距,且落后于开放权重领域的 Kimi K2.6(54 分)。在高难度编程基准(如 SWE-Bench Pro)和纯推理任务上,Ultra 基础模型能否在后训练后缩小与这些模型的差距,目前缺乏数据支撑。
第三从部署门槛来看,550B 总参数的模型对硬件要求较高,BF16 权重版本的完整部署需要多卡高端 GPU 集群。虽然 NVFP4 量化可大幅降低显存需求,但该量化版本尚未发布。此外,模型与英伟达 Blackwell 架构(GB200 等)的深度绑定意味着在非英伟达硬件上的推理效率可能显著下降,这对受 GPU 出口管制影响的地区和中小团队构成实际限制。
 AI 速览