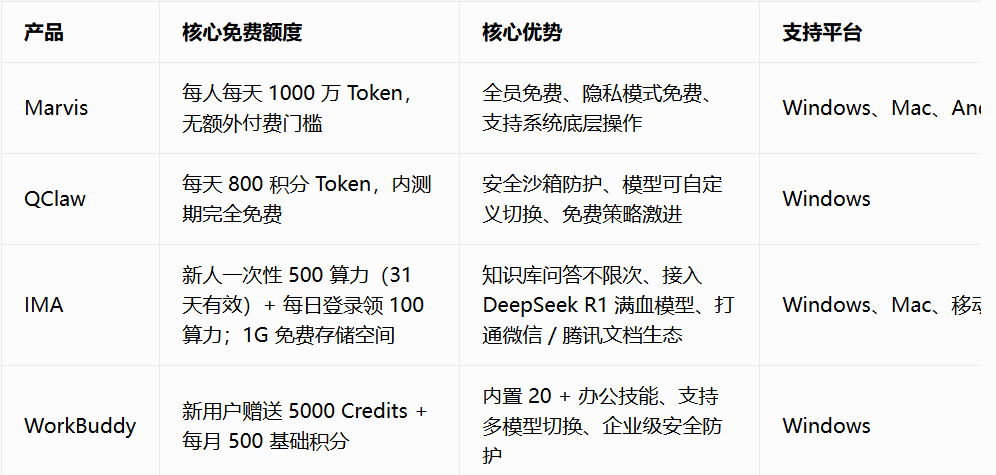
腾讯这四款Agent——Marvis、QClaw、IMA、WorkBuddy——都有免费额度,但单位完全不同:Token、积分、算力,数字没法直接比。把它们全部换算成"每天能问多少次",差距才看得清楚:Marvis最宽裕,WorkBuddy免费额度最紧,IMA弹性最大,但也最容易踩坑。 先把Agent免费额度单位统一,才能比较
四款产品的免费额度单位各不相同,硬比数字没有任何意义,需要换算成同一标准。
Marvis给的是1000万Token。按1个Token约1.5汉字算,理论上有约1500万汉字的处理量,折算日均约200到500次问答,视任务复杂度浮动。
QClaw每天800积分。简单查询消耗5到10积分,复杂任务50到100积分,折算日均约80到160次操作。
IMA每天签到领100算力,当天不用次日自动过期。模型选择影响很大——V4-Flash模式每次问答约2到3算力,Hy3模式每次约8到10算力,折算日均50到250次不等。
WorkBuddy每天签到150积分。简单任务5到10积分,复杂Agent编排30到50积分,折算日均约15到30次操作。企业旗舰版198元/人/月,无限制使用。
换算对比下来,结论很清楚:Marvis在简单任务下最宽裕,QClaw和IMA在重度任务下容易见底,WorkBuddy免费额度最紧,但Agent编排能力是四款里最强的。
三个场景测下来,Agent免费额度差距更具体
日常办公(10次问答 + 2次文档处理 + 3次搜索)
Marvis绰绰有余,1000万Token处理这种轻量任务毫无压力。QClaw 800积分够用,但集中处理文档时积分消耗会飙升,偶尔吃紧。IMA用V4-Flash模式轻松,切到Hy3就要注意算力消耗了。WorkBuddy 150积分覆盖日常够用,但10次问答就消耗近半,余量不多。
重度写作(3篇长文 + 10次知识检索 + 5次文件操作)
Marvis够用,但3篇长文下来大概消耗30%到40%额度。QClaw需要合并任务,把5个小任务合成1个大任务,能省约30%积分。IMA用V4-Flash + GLM 5.1组合,算力可能吃紧,需要自定义API Key补充——另外GLM 5.1在过去一年内多次涨价,写稿成本在持续上升。WorkBuddy 150积分在这个场景下肯定不够,单篇长文就可能消耗50+积分,重度场景只能靠自定义API Key或升级企业版。
企业批量(50份文档分析 + 20次报表 + 10次数据查询)
这个量级下,只有WorkBuddy企业旗舰版198元/人/月能稳定支撑,其他三款的免费额度全部不够用,Marvis的1000万Token处理50份文档分析也会触及上限,IMA的100算力连一半任务都完成不了。
5个省Agent额度的方法,实测有效
选对模型:V4-Flash处理日常问答,Hy3干重活,GLM 5.1专门写稿。全程用最贵的模型,额度一天就见底。
利用缓存:DeepSeek V4-Flash缓存命中率高达98.2%,重复查询几乎免费,缓存命中仅0.02元/百万token,同样的提问问两遍,第二遍消耗极低。 合并任务:批量处理替代逐条操作,QClaw把5个任务合并成1个,能省约30%积分。
Marvis隐私模式:用本地Qwen模型,零云端Token消耗,处理隐私内容时顺便省额度。
自定义API Key兜底:IMA、QClaw和WorkBuddy都支持自定义API Key,绕开平台额度限制,按量付费,成本完全可控。
多个Agent协同,比单用一个更省
让每个Agent各干最擅长的事,总消耗反而更低。
组合一:Marvis入口 + IMA深度。日常问题丢给Marvis,免费额度用不完;遇到需要知识库支撑的深度问题,Marvis给方向,IMA给依据。两个免费额度各用各的,互不挤占。
组合二:IMA知识 + QClaw执行。IMA从知识库提炼方案,QClaw按方案执行操作。IMA负责想,QClaw负责做——如果全压在IMA上,算力撑不住;如果全压在QClaw上,积分花在搜索上太浪费。
组合三:Marvis日常 + WorkBuddy编排。Marvis处理零散问答,额度绰绰有余;WorkBuddy专注多步骤自动化编排,把签到积分集中用在复杂任务上,简单问题完全不走WorkBuddy。
四款产品摆在一起,真正的逻辑不是"哪个免费额度多",而是"哪个适合你的使用场景"。日常轻量用Marvis,深度研究靠IMA,跨设备操控选QClaw,复杂编排和企业级任务交给WorkBuddy——搭配着用,免费额度叠加起来,覆盖面远比单押一款宽得多。超出免费额度,自定义API Key是最低成本的兜底方案;如果天天都在超,说明免费版已经不适合你了。
 AI 速览