GLM 5.1、DeepSeek V4、MiniMax M3,哪个国产模型才是你的主力?国产大模型实测三个月,结论先说:纯编码场景 GLM 5.1 最稳,深度推理 DeepSeek V4 单点无敌但烧钱,多模态和长上下文首选 MiniMax M3。三家各有强项,别指望一个模型包打全场,真正的问题是你的工况适合哪种搭配。 GLM 5.1、DeepSeek V4、MiniMax M3 大模型实测
DeepSeek V4:长上下文王者,但 token 真的止不住
V4 是 4 月底发的旗舰,1M 上下文、49B 激活参数、MoE 架构。LiveCodeBench 跑分 93.5,Codeforces Rating 3206,编码 SOTA 没什么可争的。
但真用起来,账单是另一回事。
官方 V4-Pro 定价 Input 0.025元/M、Output 6元/M,听起来不贵。但 V4 默认开启 thinking 模式,思考链必须传回 API,reasoning_content 照样按 token 计费。一轮带工具调用的多轮对话,光思考链就能吃掉几万 token。跑一个需要浏览 7-8 个网页的调研任务(用 Claude Code 接 V4 API),半天账单 2 亿 token——单价是不贵,但 thinking 模式的累积速度,远超任何压缩手段能压下来的程度。 V4 还有个隐性成本:长程 agentic 任务。社区有人在 YC-Bench 跑过 V4,单次长程任务花掉 $1,066,426——这是极端案例,但说明 V4 在长链路上 token 消耗是指数级的,不是线性的。
判断: V4 适合短而深的推理任务,单次解决复杂问题性价比无敌。一旦拉成长链路、长上下文、多轮 agent,token 涨得会让你怀疑人生。
踩刹车: thinking 模式关不掉就别用 V4 跑长任务。如果一定要用,把 effort 调到 high 而不是默认的 max,能省一半。
GLM 5.1:编码完成度最高,但套餐真的抢不到
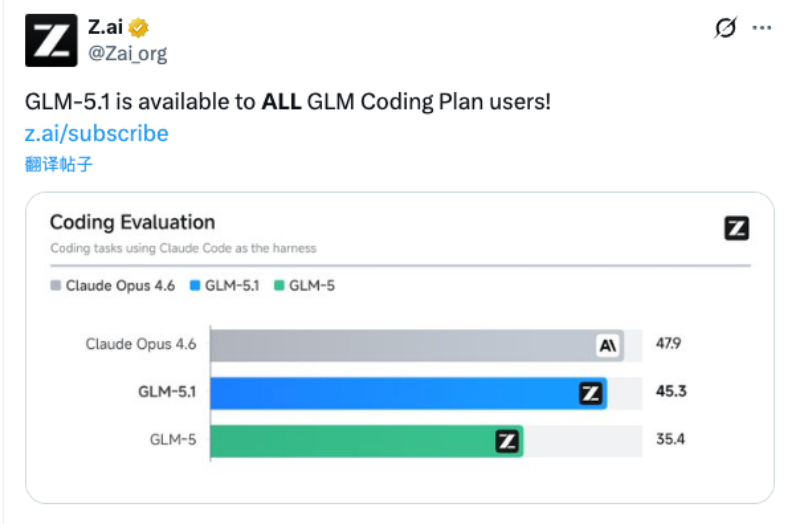
GLM-5.1 于 2026 年 4 月 7 日发布,由智谱 AI 旗下平台 Z.ai 推出,754B 总参数、约 40B 激活参数、MoE 架构,200K 上下文。SWE-Bench Pro 跑到 58.4 分,超过 GPT-5.4(57.7)和 Claude Opus 4.6(57.3),位列全球第一。 跑编码项目,国产模型普遍需要多轮沟通才能写好——这点没什么好洗的,没有哪个国产模型能像 Claude Sonnet 那样一次到位。但 GLM 5.1 的完成度,个人体感是目前国产最高的。它能理解整段上下文,能记住上一轮没说完的约束,写出来的代码通常改两处就过。
但用 GLM 5.1 有一个现实问题:官网套餐经常抢不到。
GLM Coding Plan 官方分三档:Lite(5 小时 80 prompts)、Pro(5 小时 400 prompts)、Max(5 小时 1600 prompts)。高峰期 3× 配额、非高峰 2× 配额——这意味着 5 小时窗口里 Lite 档只能跑 27 个 GLM-5.1 请求,再多就限流到零。
百度那边只有两档,49 元和 200 元。49 元是真限速,没两下就 402 了,200 元的高峰期用量飞快,三倍开销打出去。更烦的是官方没说清楚什么时候算高峰——实际用下来,每天上午 10 点和下午 2 点是高峰,下午三点想用,额度往往已经耗光。
判断: GLM 5.1 是国产编码首选,前提是你抢得到量。完成度比 M3 稳,比 V4 强——V4 编码是单点爆发,GLM 5.1 是持续输出。
MiniMax M3:多模态是真杀手锏,编码还在观察
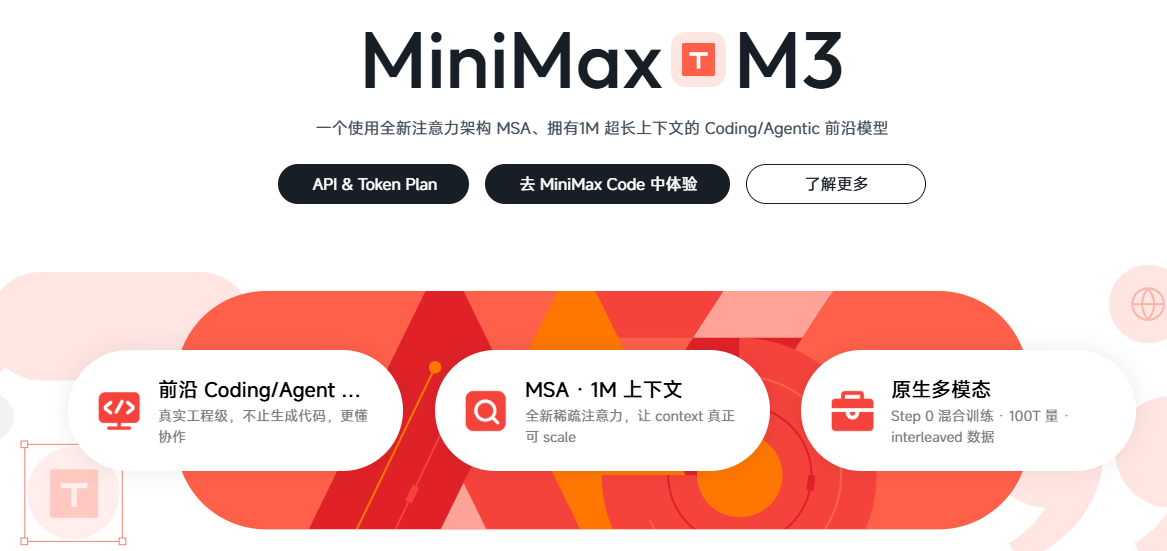
M3 于 2026 年 6 月 1 日正式发布,1M 上下文,采用自研 MSA 稀疏注意力架构。SWE-Bench Pro 评测 59.0%,超越 GPT-5.5。
用 M3 主要跑两件事:一是 Hermes 服务器定时任务(抓新闻热点),之前用 M2.7 最便宜套餐跑,M3 出来后无缝切过去;二是多模态场景——这是换主力的关键原因。M3 把语音合成、图片理解、视频输入都吃在模型本身,不用像 GLM 5.1 那样再单独接 GLM-TTS,直接把一段语音丢给 M3 合成就行。这条是 GLM 5.1 和 V4 都没法给的。
但编码场景目前还在验证。
M3 改完代码,几乎每次都要介入检查。GLM 5.1 时代每天介入 3-5 次 bug 修改,M3 几乎每个改完都要看一眼。当然评分是评分,也只用了几天,也可能是项目到了尾期、改起来问题本来就多,但"接得住"的体验,M3 还需要改善。
另外 M3 偶发莫名的 400 错误,目前只能 /clear 后重新处理,代价是上下文全没了。
判断: M3 的多模态是杀手锏,需要模型同时处理文本+图片+视频+语音的场景,M3 是国产里最完整的。编码够用,但得接受"每改一次都看一眼"的现实。长程任务偶尔会思考到一半跑偏,短期别用它做完全无人值守的工程任务。
GLM 5.1、DeepSeek V4、MiniMax M3,哪个国产模型才是你的主力?
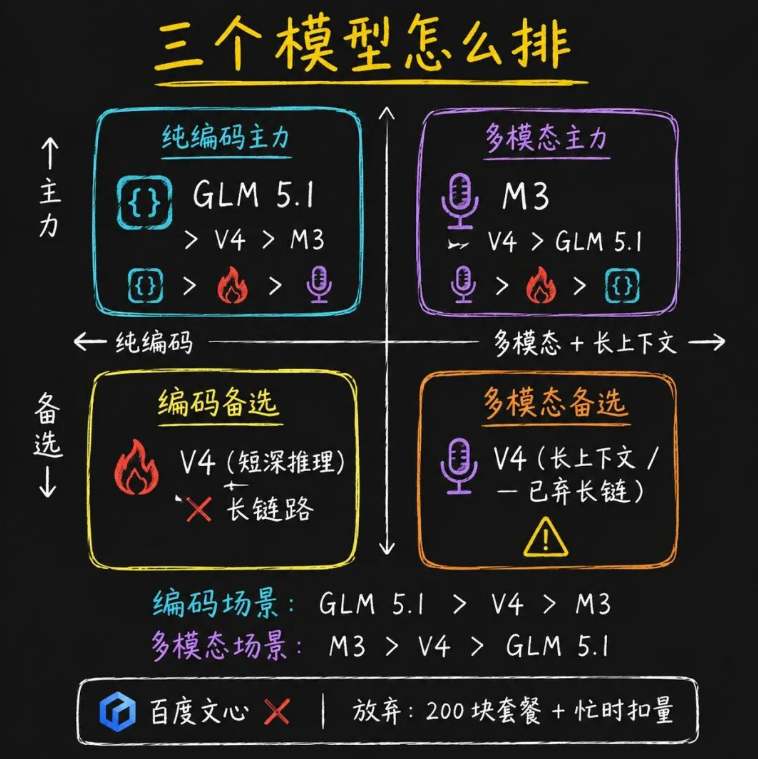
真实配比很简单:
- GLM 5.1: 主力编码。完成度最好,能记住上下文约束。每天早高峰抢到量就用。
- DeepSeek V4: 深度推理+单点复杂问题。绝不跑长链路。
- M3: 多模态+长上下文+定时任务。编码验证中,但多模态无可替代。
纯编码场景排名:GLM 5.1 > V4 > M3。
多模态或长上下文统一处理:M3 > V4 > GLM 5.1。
三个月下来,国产模型已经到了"不用凑合"的阶段,但账单管理和套餐抢购,反而成了新的日常功课。评分归评分,落到自己项目上才是真——如果 M3 编码体验一周后还是"每改必看",下一个要进场验证的是 Kimi K2.6。  AI 速览