AI 速览
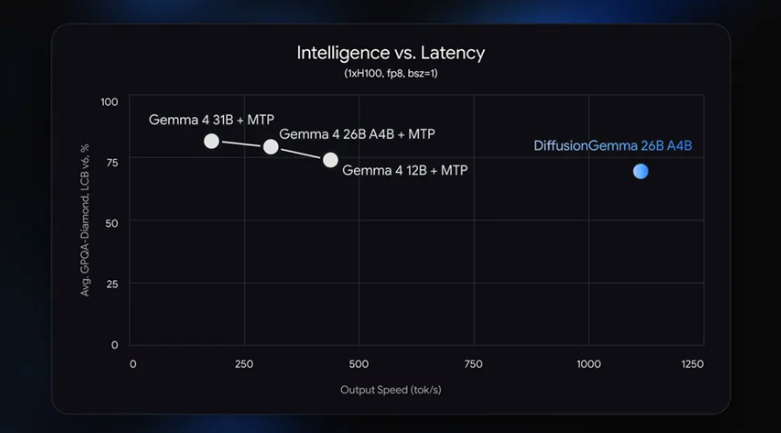
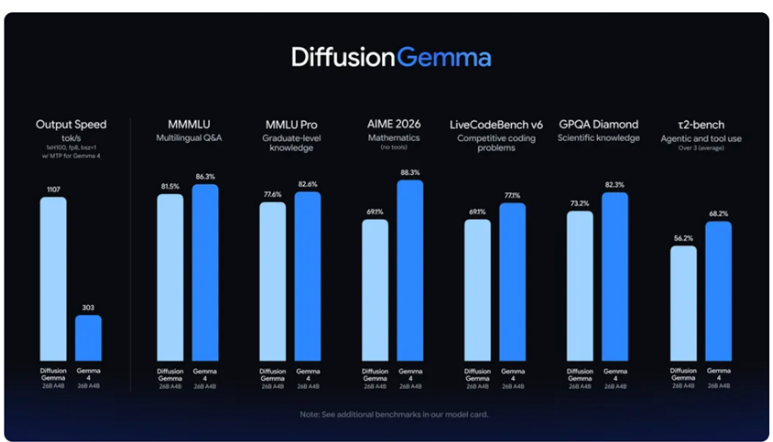
谷歌开源基于扩散机制的大模型DiffusionGemma,旨在解决本地部署大模型推理速度慢的痛点。 核心事实 - 技术原理:借鉴图像扩散思路,并行生成Token块而非自回归逐个生成,转移算力瓶颈 - 性能表现:RTX 5090上达700+ token/s,H100峰值超1000 token/s,比常规Gemma快4倍 - 硬件门槛:260亿参数MoE架构,量化后仅需18GB显存,RTX 4090/5090均可运行 - 适用场景:实时交互、代码补全、头脑风暴;不适合对文字质量要求高的生产环境 价值点 为追求极致推理速度的本地AI玩家提供了新的模型选型方案,尤其适合对延迟敏感的开发场景。
# 编程报错分析与调试指南 请根据用户提供的报错信息,执行以下步骤: 1. **解析报错信息**:仔细阅读【报错信息】,识别关键元素,如错误类型(SyntaxError、TypeError、NullPointerException等)、错误位置(文件名、行号)、堆栈跟踪等。 2. **推测可能原因**:基于错误类型和上下文,列出3-5个最可能的原因。例如: - 变量未定义或拼写错误 - 函数参数类型不匹配 - 资源未正确初始化 - 依赖库版本冲突 3. **提供调试步骤**:给出具体、可操作的调试建议,包括: - 检查相关代码行及上下文 - 添加日志或断点验证变量状态 - 验证输入数据格式与范围 - 查阅官方文档或社区讨论 4. **示例修复方案**:若可能,提供一个简化的代码修复示例。 请确保回答清晰、结构化,并针对不同编程语言(如Python、Java、JavaScript等)调整术语。 --- **输入示例**: 【报错信息】 ```python Traceback (most recent call last): File "main.py", line 5, in <module> print(x + y) NameError: name 'x' is not defined ```