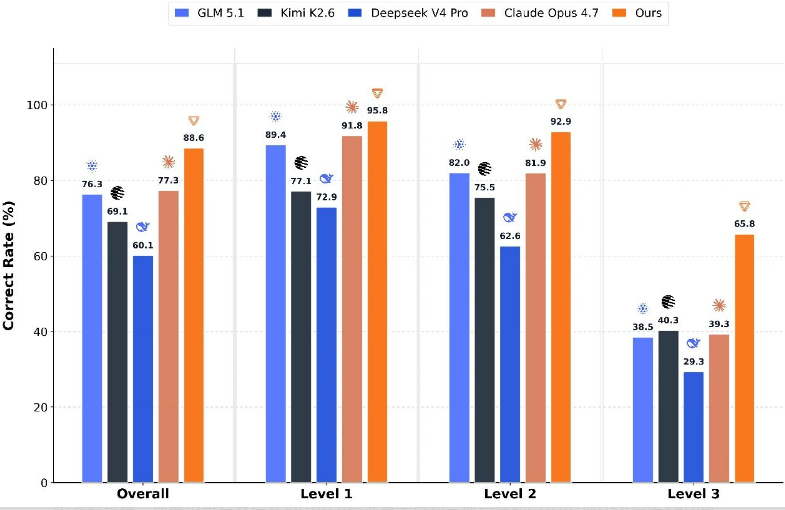
摩尔线程在6月10日开源了MusaCoder代码大模型,9B和27B两个版本,全链路跑在国产MTT S5000 GPU上。这件事的重量不在"开源"两个字——在于KernelBench评测上,MusaCoder-27B-RL的成绩压过了Claude Opus 4.7、DeepSeek-V4 Pro等一批主流闭源模型。不是"接近",是真的在上面。 KernelBench这个评测不好刷。它专门考模型写GPU底层算子的能力——从PyTorch标准算子自动生成CUDA/MUSA原生Kernel代码,涉及复杂的shape推导、内存带宽管理、并行计算逻辑。这不是堆参数量就能糊弄过去的基准。MusaCoder-27B-RL跑出了Overall Pass@8 93.2%、Avg.@8 88.60%的成绩,而Claude Opus 4.7对应的两项数据是87.2%和77.30%。到了难度最高的Level 3任务,差距更明显:Pass@8领先18个百分点,Avg.@8领先26.5个百分点。 你可以把这个结果理解为一个垂直专攻的产物。MusaCoder不是通用代码大模型,它就是为GPU Kernel生成这一件事设计的——降低开发者手写底层算子的门槛,让从PyTorch参考实现到原生Kernel的转化可以自动完成。这个定位决定了它在这个维度上的表现能超过通用模型。但即便如此,超过Claude Opus 4.7这件事本身,仍然值得认真对待。
国产GPU全链路训练,这次真的做到了
MusaCoder最核心的技术标签,是"国产GPU全链路训练"。SFT、RFT、RL、在线编译执行验证——这套完整的后训练流程,全部跑在摩尔线程自己的MTT S5000构建的夸娥智算集群上。没有用A100,没有用H100,CUDA生态也没有介入。
过去两年国产GPU的进展基本停在"能跑推理"这个层次。华为升腾、寒武纪陆续跑通了推理部署,部分训练任务也走通了,但完整的大模型全链路训练一直是个没怎么被公开跨越的门槛——训练需要大规模集群通信、高带宽内存互联、长期稳定性,这些都是国产GPU历史上的软肋。MusaCoder的发布,等于用一个拿得出手的评测结果,对着"国产GPU做不了大模型训练"这个质疑给了一个具体的回答。
摩尔线程还专门为此构建了MooreEval分布式执行验证系统,能对模型生成的代码做自动编译、执行、正确性验证和性能测试,并把结果转化为训练反馈信号。这套机制让模型不只是学"写出能跑的代码",而是学"写出正确、合法且比基线更快的Kernel"。这个细节值得留意,因为它意味着摩尔线程不是把训练基础设施当黑箱用,而是把它做成了训练流程里主动参与的一环。
9B和27B的分工
9B版本面向开发者日常场景,单张消费级GPU可以跑,部署门槛低。27B版本面向复杂工程任务,底层Kernel开发、GPU并行优化、系统级代码生成。
两个版本在KernelBench上的差距,比参数差距本身暗示的要大得多。这背后可能是27B版本覆盖了更多底层编程范式的训练数据,也可能是更长的训练周期让模型对GPU架构有了更深的"理解"。具体原因摩尔线程没有详细公开,但结果是摆在那的。
开源是一步生态棋
MusaCoder开源这个动作,逻辑不复杂。摩尔线程的GPU需要开发者生态,开发者需要工具——一个开源的、基于自家GPU训练的、专门服务GPU Kernel开发的代码助手,就是最直接的开发者招募工具。
这个路径和NVIDIA推广CUDA时的做法很像。2007年CUDA发布之后,NVIDIA花了大量资源免费给高校送GPU、送培训、送教材——目的不是那几块卡,是让一批工程师从学生时代就建立起"用CUDA写GPU代码"的习惯。十年后,这批人成了AI产业的骨干,底层跑的统统是NVIDIA的GPU。
MusaCoder就是摩尔线程版本的"CUDA教材"。开源、免费、KernelBench成绩能打——三张牌打在一起,对着的是同一批人:被英伟达生态卡着脖子、想找替代路径的中国开发者。
对你来说,MusaCoder的吸引力不需要靠情怀支撑。KernelBench的排名放在那里,GPU Kernel生成这个维度上它跑赢了Claude Opus 4.7——你需要做的就是看清楚这个数字在说什么。
摩尔线程用MusaCoder证明了两件事:国产GPU能完成大模型的全链路训练,垂直专用代码模型在特定评测维度上可以超越通用闭源旗舰。国产GPU生态建设的叙事,这次有了一个相对扎实的技术支撑点。
 AI 速览