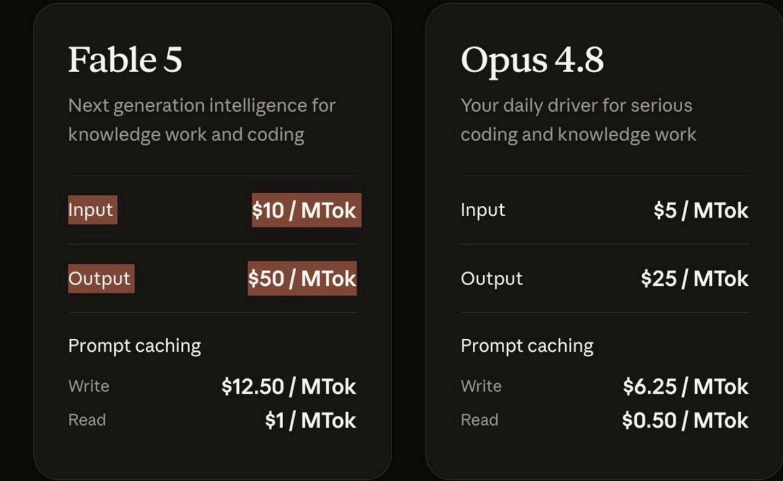
很多人看到Claude Fable 5定价的第一反应都是:这也太贵了吧。但用了两天之后,不少开发者发现,这个"贵"字可能没那么简单——在某些任务上,Fable 5反而比Opus 4.8花得更少。 Fable 5的API定价是每百万输入token 10美元、输出50美元,刚好是Opus 4.8(5美元/25美元)的两倍。但价格翻倍不等于账单翻倍,这是很多人最开始没绕过来的弯。
Claude Fable 5 调成low档,比Opus还能打
Fable 5支持多个effort(努力程度)档位,从low到high可以手动调节。开发者们发现,哪怕调到最低的low档,模型的表现依然扎实。在FrontierCode(Diamond)基准测试中,Fable 5仅在medium档位就已经领先所有前沿模型——这意味着不烧满推理token,照样能跑出顶级成绩。
做电子表格自动化的客户实测发现,Fable 5在所有effort档位都跑赢了Opus 4.8,整体完成速度快了25%到30%。速度更快、回合更少,意味着烧掉的token也更少。
贵的是单价,省的是账单
这里有个关键逻辑:Fable 5在很多任务上能用更少的轮次、更少的token完成工作。一个按两倍单价计费但实际用量明显更少的任务,最终到账单上的数字,可能比Opus 4.8还低。
有研究者测试了一个前沿物理研究任务,Fable 5只用了三分之一的推理token,就在36小时内跑到了其他模型需要四天才能接近的位置。
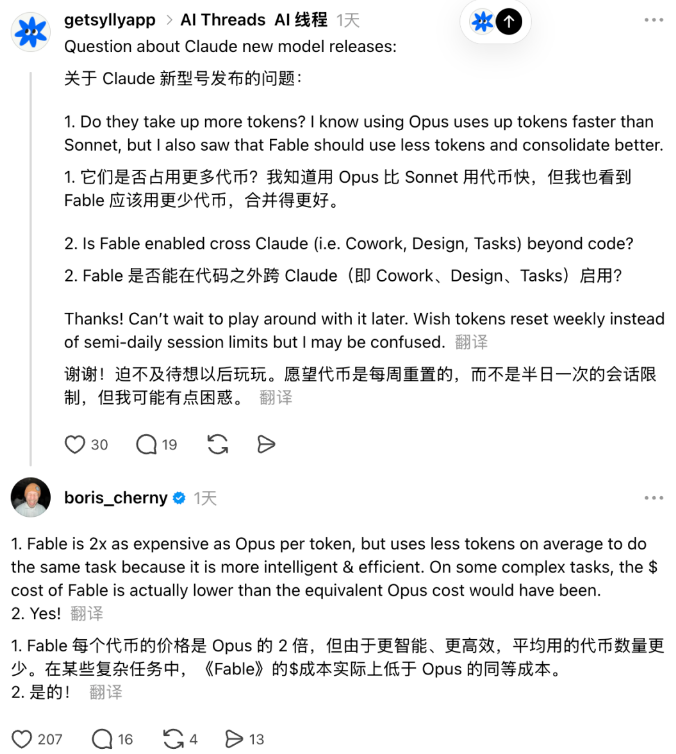
Claude Code的核心开发者也做过类似的解释:Fable每token的价格是Opus的两倍,但聪明的模型犯错更少,不需要反复纠错、重跑,那些隐性的"浪费token"被砍掉了,所以复杂任务的实际花费反而更低。 当然,这不是绝对的。如果你的任务会触发安全分类器——比如涉及网络安全、生物化学等敏感领域——请求会自动降级到Opus 4.8处理,这时你实际上在用Opus的能力,却按Fable的价格付费。简单任务也不需要动用Fable,Opus或者Sonnet完全够用。
榜单方面,基本横扫
抛开成本不谈,Fable 5这两天在各个评测榜单上的表现确实有点猛。
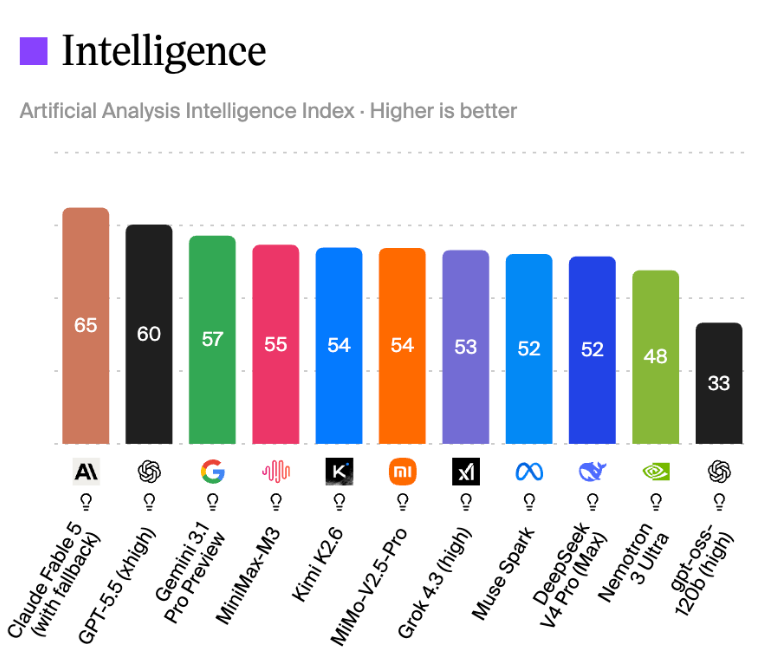
在Artificial Analysis最新的智能指数中,Fable 5以65分排名第一,明显领先同价位的其他模型。
编程能力方面,Fable 5在SWE-bench Verified上拿到95.0%,SWE-bench Pro上达到80.0%,比Opus 4.8分别高出约6到11个百分点。
在法律推理方向,Fable 5以13.3%的成绩远超GPT-5.5的2.1%和Gemini的0.0%;空间推理得分相比Opus 4.8几乎翻了三倍(38.6% vs 14.5%)。 Stripe的实际案例也很能说明问题:在一个5000万行代码的Ruby代码库里,Fable 5单日完成了一次全库迁移,这项工作Stripe内部估计需要一整个团队干两个多月。
使用前两件事要注意
第一,Fable 5带着安全分类器上线,涉及网络安全、生物学、化学和模型蒸馏等敏感请求,会自动转给Opus 4.8处理,触发率不到5%的会话。这部分Benchmark成绩,公开版本未必能完全复现。
第二,关于免费窗口:从6月9日到6月22日,Pro、Max、Team和企业版订阅用户可以直接使用Fable 5,不产生额外费用。6月23日起,继续使用需要消耗用量积分,按API价格计费。Anthropic表示,等算力容量跟上之后,会重新将其恢复为订阅权益。
另外,在claude.ai订阅计划中,Fable 5按2倍用量计算。用之前注意看清楚自己的用量余额。 所以,如果你手上有复杂的编程任务、长上下文的Agent工作流,或者一直在为Opus跑挂重跑烧token头疼——现在倒是个试试Fable 5 low档的好时机,免费窗口就剩十来天了。
 AI 速览