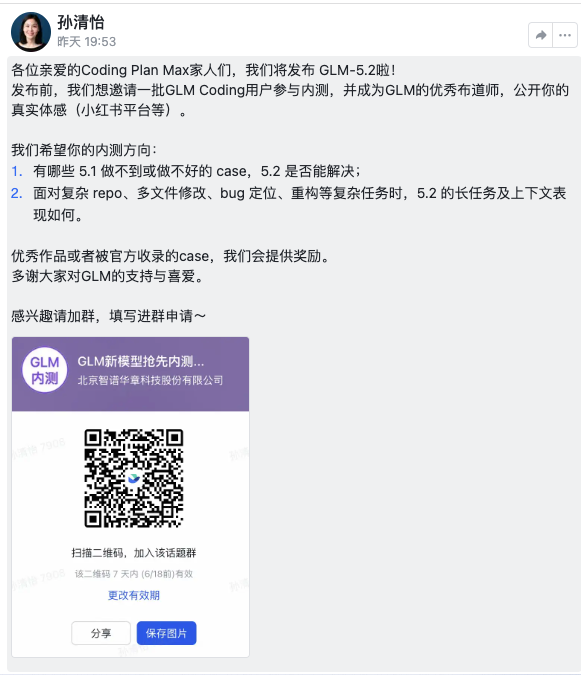
6月12日消息,智谱AI在Coding Plan Max用户群中发布内测招募公告,确认GLM-5.2即将发布。官方明确了两个内测方向:一是GLM-5.1做不好或做不到的case,验证5.2能否解决;二是复杂repo、多文件修改、bug定位、重构等长任务场景下的上下文表现。按照GLM-4.7、5.0、5.1均遵循的7天内测-发布节奏,GLM-5.2正式版预计在一周内上线。
这是GLM-5系列自2月12日首发以来的第三次重大迭代。从GLM-5到5.1再到5.2,智谱在AI Coding赛道上维持了国产模型中最快的发布节奏。
内测方向直指5.1已知短板
从官方公告的措辞看,GLM-5.2的优化方向高度聚焦。第一个内测方向——"5.1做不到或做不好的case"——指向的是模型能力的绝对边界。第二个方向——复杂repo、多文件协同、bug定位、重构等长任务的上下文表现——则对应5.1最被社区诟病的问题。
GLM-5.1在4月8日发布后,开发者社区的实测反馈呈现出明显的分裂特征。在常规编码和单文件任务上,5.1与Claude Opus 4.6的差距已经不大。但代码累积到一定规模后,模型会出现"失智"现象——在小问题上反复做破坏性改动,超长上下文时幻觉率明显上升。知乎实测显示,桌面App项目在前9轮表现与Opus不相上下,但第9轮后5.1突然崩溃,最终成绩跌至Sonnet 4.5以下。还有开发者指出,5.1在不额外提示的情况下倾向于把代码塞进单个文件,进一步推高后续幻觉概率。 据社区流传的信息,GLM-5.2可能将上下文窗口从5.1的约200K扩展至100万token级别,并提供两档推理强度设置。如果属实,这将直接回应长任务场景下的上下文瓶颈问题——200K在复杂repo的多轮迭代中确实不够用,而可调推理强度则让用户在速度与深度之间自行取舍。不过这些参数尚未获得官方确认。
5.1的成绩单:SWE-Bench Pro登顶但有争议
GLM-5.2的起点是一个已经相当高的基线。GLM-5.1在智谱自有测试环境下,SWE-Bench Pro得分58.4,超过了GPT-5.4的57.7和Claude Opus 4.6的57.3,是当时得分最高的模型。在CyberGym上68.7分,比GLM-5提升近20分。8小时持续自主执行能力是5.1的标志性卖点——它可以在单次任务中完成从规划、执行到调试、交付的完整闭环。
但需要注意的是,58.4这个数字是智谱自报的vendor-reported成绩,并非Scale AI标准化SEAL排行榜的结果。Scale的标准化评测中,GLM-5系列目前没有独立条目。在Scale的统一脚手架下,GPT-5.4得分59.1%,Opus 4.6为51.9%。不同评测框架和脚手架对成绩的影响巨大——Claude Fable 5在Anthropic自有环境下拿到80.3%,但同一基准在不同条件下差距可达数十个百分点。
实际开发场景的反馈也印证了这种分裂:5.1在日常编码中与Opus差距极小,但在极端长上下文、复杂多步Agent工作流和超深度推理上仍有明显差距。
竞品坐标:Coding赛道正在加速
GLM-5.2面对的竞争环境比两个月前更加拥挤。Anthropic在6月初发布了Claude Fable 5,SWE-Bench Pro自报成绩80.3%,Opus 4.8紧随其后69.2%。OpenAI的GPT-5.4持续迭代,Codex平台同步收购Ona强化持久执行。Gemini 3.1 Pro在推理基准上保持领先。开源阵营中,Qwen 3 Coder和Kimi K2.5也在快速追赶。 智谱的差异化在于两点:一是开源(MIT协议),二是性价比。GLM-5.1通过OpenRouter的API定价为输入$1.40/百万token、输出$4.40/百万token,远低于Claude和GPT的同级别价格。Coding Plan Max月费469元,对比Claude Pro+Code的订阅价格仍有明显优势。 但低价策略也带来了副作用。Coding Plan在高峰时段频繁限流,Max套餐实测体验低于预期——有开发者反馈复杂任务动辄1小时起步,实际可用额度远低于官方宣传。3月上线时一度出现限购抢购,涨价30%后供需关系仍然紧张。
商业节奏:从涨价到7天迭代
智谱在GLM-5.2上的节奏选择值得关注。从2月GLM-5发布当天同步涨价,到4月5.1发布后Coding Plan持续限购,再到现在5.2内测仅面向Max用户——这套操作的逻辑是:用快速迭代维持技术声量,用高端套餐筛选核心用户,用限购制造稀缺性。
智谱2025年云端收入同比增长约293%,正在从项目制部署向token计费模式转型。每次模型升级都会带来一波token调用量增长,而7天发布节奏让这个增长曲线保持连续。公司预计2026年收入约28亿元,2027年近70亿元——这个增速只有在token计费模式跑通的前提下才能实现。
局限与前瞻
GLM-5.2的核心挑战在于:能否在保持速度优势的同时,真正解决5.1在长上下文和复杂工程中的稳定性问题。如果百万token上下文属实,工程实现的难度不小——GLM-5系列基于DSA稀疏注意力机制,200K到1M的跨越需要在效率和质量之间重新找平衡。两档推理强度的设计也存在用户认知成本:什么场景该用哪档,目前没有明确的指引。
更深层的问题是,7天迭代节奏能否持续。模型性能提升的边际收益会递减,而每次发布都需要算力投入、测试验证和社区支持的硬性成本。智谱目前用速度换市场,但最终竞争还是要回到生态和场景的积累上。
从内测公告只开放给Max用户、且明确要求"公开真实体感"来看,智谱对这次迭代的质量有信心,但也在用小范围测试控制风险。按照历史节奏,GLM-5.2正式版最快本周内上线。
 AI 速览