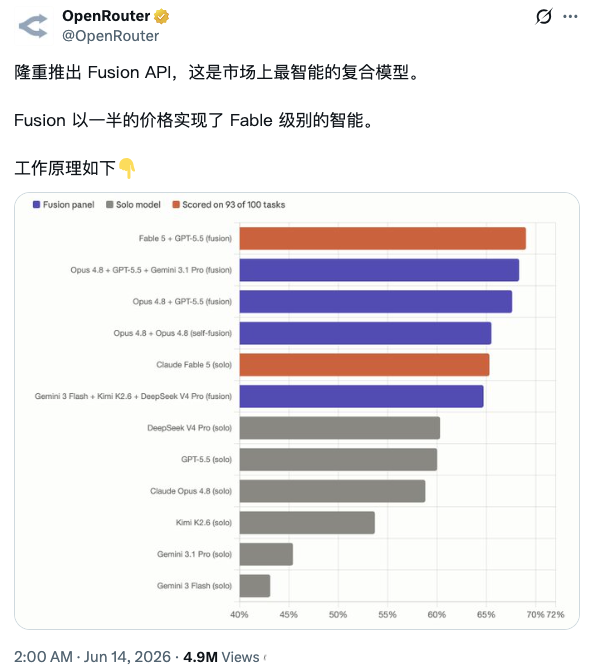
6月15日消息,OpenRouter正式发布Fusion复合模型API,核心机制是将用户提示并行分发给多个大模型组成的"评审团",由评判模型分析共识、矛盾和盲区,再由合成模型输出最终答案。在Perplexity AI的DRACO基准测试中,Fusion最佳配置达到69.0%,超过Fable 5单模型的65.3%;低成本配置也达到64.7%,成本仅为前者的一半。 一次API调用背后的多模型协同
Fusion的工作流程分为三步。当用户发送一个请求后,OpenRouter将提示词并行分发给一组模型(称为"panel"),每个模型独立执行任务,均可调用网页搜索和网页抓取工具。完成后,一个评判模型阅读所有面板成员的输出,生成结构化分析报告——包括共识点、矛盾点、覆盖缺口、独特洞察和盲区。最后由调用模型基于这份分析撰写最终答案。
整个流程在服务端运行,对开发者来说只是一次普通的API调用。用户可以选择预设面板(Quality或Budget),也可以自定义面板成员和评判模型。API标识符为openrouter/fusion,也可以作为工具挂载,让模型自主决定何时调用多模型协同。
DRACO基准:从数据看复合效果
OpenRouter选用Perplexity AI开发的DRACO基准进行测试,该基准包含100个深度研究任务,覆盖学术、金融、法律、医学、技术等10个领域,每个任务有约39个加权评分标准,涵盖事实准确性、广度深度、表达质量和引用质量四个维度。错误回答会触发负权重惩罚,冗长但不准确的输出反而会扣分。
核心结果是:Fable 5 + GPT-5.5组合经Opus 4.8合成后达到69.0%,超过Fable 5单模型的65.3%;Opus 4.8 + GPT-5.5 + Gemini 3.1 Pro三模型组合达到68.3%;而由Gemini 3 Flash、Kimi K2.6和DeepSeek V4 Pro组成的低成本面板达到64.7%,接近Fable 5的水平,成本仅约一半。 一个值得注意的发现是:Opus 4.8与自身组成双模型面板、再由自己合成,得分从单独的58.8%跳升至65.5%——提升6.7个百分点。这说明合成步骤本身就贡献了显著增益,同一个模型两次执行会产生不同的推理路径、工具调用和信息来源选择。
竞品对比:复合模型赛道的现状
多模型协同并非全新概念。Anthropic的MCP协议支持模型间工具调用,但更多面向工具集成而非模型输出融合。Google的Gemini系列在内部使用了混合专家架构(MoE),但这是模型层面的稀疏激活,不是推理层面的多模型合成。 在应用层面,Perplexity的搜索产品已经在内部实践多源信息融合,但未将其作为开放API暴露给开发者。Microsoft的Copilot Studio允许编排多个AI组件,但侧重于工作流而非单次推理的质量优化。 Fusion的差异化在于:它将多模型协同封装为一个标准API接口,开发者无需自己搭建编排层,直接获得"多模型审议→结构化分析→合成输出"的完整管线。对于深度研究、专家评审、多角度对比等高容错成本场景,这比调用单一模型更有价值。
局限与开放问题
Fusion的基准测试结果目前仅来自OpenRouter内部实现的DRACO评测,且使用了与原始论文不同的评判模型(Gemini 3.1 Pro Preview替代原版Gemini 3 Pro),因此得分与论文原始结果不可直接对比。尚无第三方独立验证。
成本是另一个现实问题。虽然低成本面板的单次任务成本约为Fable 5的一半,但实际花费等于所有面板模型调用加上评判模型调用的总和再加OpenRouter的费用。对于简单任务,这种多模型调用的开销明显过高。OpenRouter也承认,模型可以自主决定是否调用Fusion——对于不需要多模型协同的提示词,它会直接回答。
延迟也值得关注。并行调用多个模型虽然比串行快,但等待最慢的面板成员完成仍然是瓶颈。实时交互场景下,Fusion的响应时间预计会明显高于单模型调用。
更根本的问题是,随着单一模型能力持续提升,复合模型的性能优势窗口有多大。如果下一代前沿模型本身就能达到69%以上的DRACO得分,Fusion的价值主张就需要重新定义——从"超越前沿"转向"降低达到前沿水平的成本"。
 AI 速览