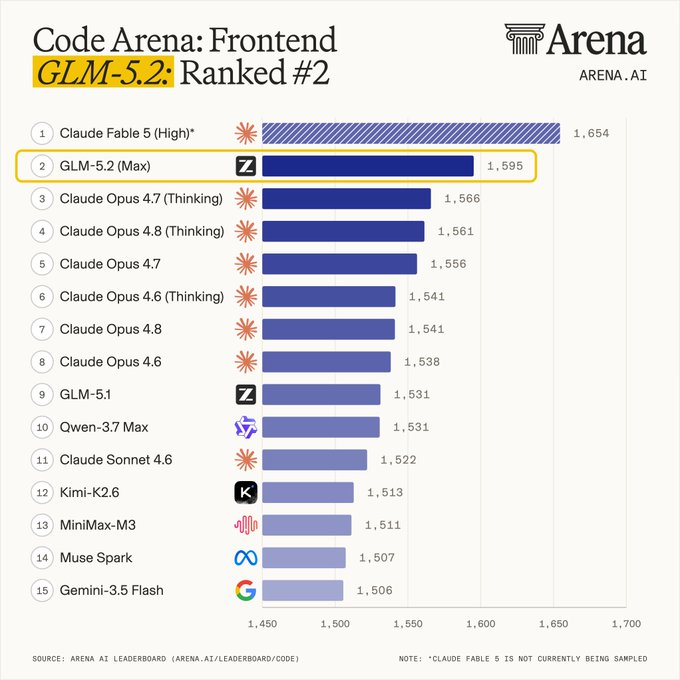
6月17日消息,智谱 AI(Z.ai)正式发布 GLM-5.2 并开源至 Hugging Face(MIT 协议)。753B 参数 MoE 架构,百万 Token 上下文,两档推理努力级别。Code Arena 编程榜排名第二仅次于 Fable 5,DesignArena 设计榜以 1360 ELO 登顶第一——一个开源模型同时杀入编程和设计两个竞技场头部,这在此前没有先例。 开源上线:MIT 协议,Hugging Face 可下载
GLM-5.2 已上线 Hugging Face(zai-org/GLM-5.2),采用 MIT 开源协议。这意味着任何企业和个人都可以自由下载、微调、商用部署,无区域限制、无使用费、无"可接受用途"类附加条款。
对供应链自主可控有需求的团队来说,MIT 协议在合规层面提供了最大确定性——不需要律师逐条审查授权条款,不需要担心上游厂商的策略变更影响下游部署。
同步上线的还有 Z.ai API(定价与 GLM-5.1 保持一致)、chat.z.ai 聊天入口,以及面向开发者的 GLM Coding Plan 全层级接入(Lite/Pro/Max/Team)。自部署方面,FP8 权重约 800 GB,8 块 H200 SXM 可支撑完整百万上下文推理;INT4 量化版约 200 GB,4 块 H200 即可运行。
双竞技场头部:Code Arena 编程第二,DesignArena 设计第一
GLM-5.2 同时进入了两个用户体感驱动竞技场的头部位置——编程和设计各一个,且都是开源模型中的最高排名。
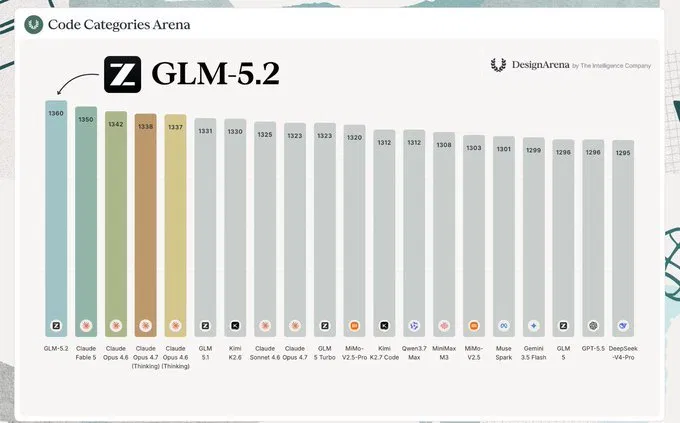
Code Arena(编程):第二名。 GLM-5.2(Max 版)在 Code Arena 前端榜单中排名第二,比 Claude Opus 4.7 思考模式高出 29 分,仅次于 Fable 5。Code Arena 通过真实用户盲评驱动排名,是开发者社区衡量编程体验的核心参考榜单。一个 MIT 开源模型压过 Claude Opus 全系和 GPT-5.5 进入前二,此前没有先例。 DesignArena(设计):第一名。 在 The Intelligence Company 运营的 DesignArena Code Categories 排名中,GLM-5.2 以 1360 ELO 登顶,超越 Claude Fable 5(1350)、Claude Opus 4.6(1342)、Claude Opus 4.7 思考模式(1338)。GPT-5.5 以 1296 排在第 20 位,差距 64 分。
DesignArena 完整 Top 10:GLM-5.2(1360)> Claude Fable 5(1350)> Claude Opus 4.6(1342)> Claude Opus 4.7 Thinking(1338)> Claude Opus 4.6(1337)> GLM-5.1(1331)> Kimi K2.6(1330)> Claude Sonnet 4.6(1325)> Claude Opus 4.7(1323)= Claude 5 Turbo(1323)。 值得注意的是榜单中中国模型密集上榜:除 GLM-5.2 和 GLM-5.1 外,Kimi K2.6(1330,第 7)、MiMo-V2.5-Pro(1320,第 11)、Kimi K2.7 Code(1312)、Qwen3.7 Max(1312)、MiniMax M3(1308)均进入前 15。
8 项基准实测:编程与 Agent 全覆盖
智谱官方公布了 GLM-5.2 在 8 项编程与 Agent 基准上的成绩,对比模型包括 Claude Opus 4.8、GPT-5.5、Gemini 3.1 Pro。所有模型均在最大推理努力级别下测试。逐项数据如下: SWE-bench Pro(真实软件工程任务): GLM-5.2 拿到 62.1,超越 GPT-5.5 的 58.6 和 GLM-5.1 的 58.4,但仍落后于 Claude Opus 4.8 的 69.2。相比上一代 GLM-5.1 提升 3.7 个点。
Terminal-Bench 2.1(终端任务): GLM-5.2 达到 81.0,大幅超越 GLM-5.1 的 63.5(提升 17.5 个点),与 GPT-5.5 的 84.0 和 Claude Opus 4.8 的 85.0 差距收窄到个位数。
NL2Repo(仓库级代码生成): GLM-5.2 为 48.9,GPT-5.5 为 50.7,Claude Opus 4.8 为 69.7。这是 GLM-5.2 与闭源头部差距最大的单项。
DeepSWE(深度软件工程): GLM-5.2 达到 46.2,相比 GLM-5.1 的 18.0 实现了 156% 的跃升。但 Claude Opus 4.8(70.0)和 GPT-5.5(58.0)仍领先明显。值得注意的是 Gemini 3.1 Pro 仅为 10.0,说明这项测试对模型能力的区分度极高。
ProgramBench(编程综合): GLM-5.2 为 63.7,GLM-5.1 为 50.9,Claude Opus 4.8 为 71.9,GPT-5.5 为 70.8。
MCP-Atlas(MCP 工具调用): GLM-5.2 达到 77.0,几乎追平 Claude Opus 4.8 的 77.8,超越 GPT-5.5 的 75.3。这是 Agent 场景最关键的基准之一,GLM-5.2 在此项上已经与闭源旗舰平起平坐。
Tool-Decathlon(工具调用十项全能): GLM-5.2 拿到 59.9,是所有参测模型中的最高分——超越 Claude Opus 4.8 的 55.6 和 GPT-5.5 的 48.8。这是 GLM-5.2 唯一取得全场第一的单项基准。
Humanity's Last Exam(综合推理): GLM-5.2 为 54.7 / 52.3(含工具/不含工具),Claude Opus 4.8 为 49.8 / 41.4,GPT-5.5 为 57.9 / 52.2。表现与 GPT-5.5 接近,明显优于 Claude。
汇总来看,GLM-5.2 在 MCP-Atlas、Tool-Decathlon、Humanity's Last Exam 三项上达到或超越了闭源旗舰水平,在 SWE-bench Pro 上超越 GPT-5.5,在 Terminal-Bench 2.1 上缩小差距至 3-4 个点。NL2Repo 和 DeepSWE 仍有明显差距,但相比 GLM-5.1 的提升幅度惊人(DeepSWE 从 18.0 到 46.2)。
两档推理努力级别:Max 拼极限,High 省 Token
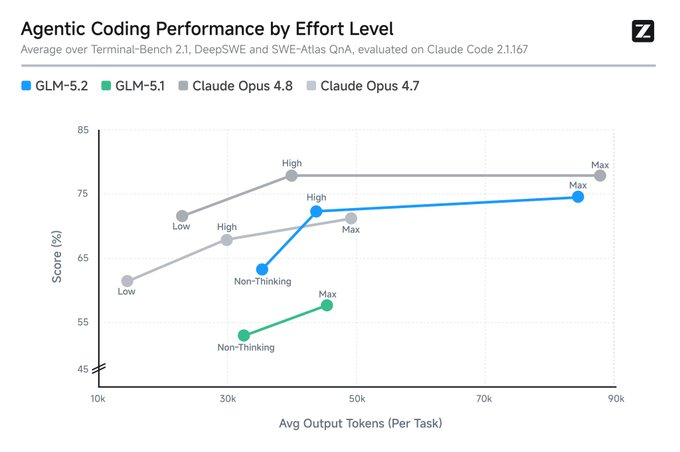
GLM-5.2 提供两种推理努力级别——GLM-5.2(Max)追求极致性能,GLM-5.2(High)在性能与 Token 效率之间取得平衡。上述基准成绩均为 Max 模式。
这个设计回应了 Agent 产品的核心矛盾:性能越好 Token 消耗越高,但不是每个任务都需要"满血"推理。High 模式让开发者在日常任务中控制成本,遇到复杂问题时切换 Max 模式全力输出。
配合 MTP(Multi-Token Prediction)层的优化,GLM-5.2 的投机解码接受长度提升最高 20%,进一步压缩推理开销。
从 GLM-5 到 5.2:三个月三个版本的产品节奏
智谱在 2026 年上半年的发版节奏极其密集:2 月发布 GLM-5(744B MoE),3 月发布 GLM-5.1(SWE-Bench Pro 58.4,当时开源最优),6 月发布 GLM-5.2。三个月三个版本,每一版都在编程和 Agent 基准上有可量化的提升。
这不是"憋大招"式的发布策略,而是"持续交付"式的产品迭代。智谱显然选择了在 Agentic 编程这一条垂直赛道上用密度换速度——不追求全品类全能力,而是在一个方向上连续跑出成绩,用版本号建立开发者心智。
我们怎么看
GLM-5.2 最值得关注的不是任何单项数字,而是两件事的叠加效应:编程和设计两个竞技场同时进入头部 + MIT 开源。
Code Arena 第二、DesignArena 第一——这两个都是用户体感驱动的竞技场,不是厂商自报的基准分数。一个 MIT 开源模型同时在编程和设计两个维度压过绝大多数闭源旗舰,意味着开源模型的"可用性"已经跨过了一个临界点——不只是"差不多能用",而是"在多个场景下比闭源更好用"。
从基准数据看,GLM-5.2 并不是全面超越闭源模型。NL2Repo 和 DeepSWE 的差距说明在仓库级代码生成和深度工程任务上,Claude Opus 4.8 仍然有明显优势。但在 Tool-Decathlon、MCP-Atlas、Humanity's Last Exam 这些 Agent 和工具调用导向的测试中,GLM-5.2 已经与闭源旗舰平起平坐甚至反超。
对企业来说,这意味着模型选型的逻辑变了。不再是"开源还是闭源"的二选一,而是"哪些任务用开源就够了,哪些任务值得为闭源付费"。GLM-5.2 的 MIT 协议 + 自部署能力 + 与闭源接近的 Agent 性能,让这个分层决策第一次有了可操作的基础。
 AI 速览