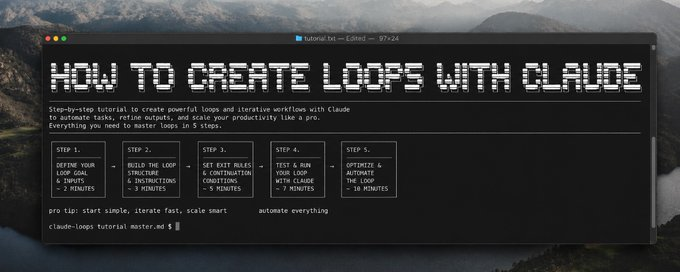
你不需要成为一个好的提示词工程师。你需要成为那个设计循环、让循环替你写提示词的人。
2026年 6月,一场关于 AI 工作方式的范式转变正在发生。Anthropic Claude Code 负责人 Boris Cherny 说:"我不再给 Claude 写提示词了,我的工作是写循环。" Google 工程师 Addy Osmani 随即发表长文,正式将这种实践命名为 Loop Engineering(循环工程)。 这篇文章会用最直白的方式解释:什么是 Loop Engineering,它和你现在的工作方式有什么不同,以及你明天就可以开始用的实操方法。
一、先搞清楚一件事:提示词 vs 循环
你现在用 AI 的方式,大概率是这样的:
打开对话 → 写一个提示词 → 读回复 → 再写下一个提示词 → 再读回复……
你在全程"手握工具",一轮接一轮地操作。AI 是一个被动的工具,你是唯一的驱动力。
Loop Engineering 说的是另一种工作姿态:
你设计一个系统 → 这个系统自己去给 AI 下指令 → 自己检查结果 → 自己决定下一步做什么 → 你只在关键节点介入审核。
区别不在于 AI 变强了,而在于你的角色变了——从"操作员"变成"系统设计者"。
用一个比喻来说:以前你是亲自上场打每一个球的球员,现在你是设计战术板的教练。球员(AI)按照你的战术自己跑位、传球、射门,你在场边观察,只在需要换人或调整战术时介入。
二、一个循环到底长什么样?
Anthropic 在其官方博客《Building Effective Agents》中给出了 Agent 的核心定义:LLM 在一个循环中自主使用工具。 模型调用工具、获取环境反馈、再决定下一步,如此往复直到任务完成。
Addy Osmani 在此基础上,把一个完整的 Loop 拆解成了六个组件。不要被这个数字吓到——你不需要一次性全部搭建,理解每个部件的作用就够了。
1. 自动化(Automations)—— 心跳
自动化是让循环成为"循环"而不是"一次性运行"的关键。它就是一个触发器:一个定时任务、一个 webhook、一个文件变更监听。没有它,你所谓的"循环"只是一个你手动执行了一次的脚本。
最简单的自动化: 每天早上 8 点,自动运行一段指令,让 AI 读取昨天的关键信息,把发现写进一个文件。就这样,这已经是一个循环了。
2. 工作树(Worktrees)—— 隔离墙
当你同时让多个 AI 干不同的活时,它们可能会互相踩脚——两个 AI 同时改同一个文件,结果就乱了。工作树给每个 AI 一个独立的工作空间,互不干扰。
通俗理解: 就像给每个员工一张独立的办公桌,而不是让所有人挤在同一台电脑前。
3. 技能(Skills)—— 操作手册
你有没有这种体验:每次和 AI 对话,都要重新解释一遍你的项目背景、写作规范、代码风格?技能文件解决的就是这个问题。它是一份写好的文档,AI 每次运行时先读它,就像新员工入职先看 SOP 手册。
关键价值: 你解释一次,所有循环都能读到,知识被复用而不是每次从零开始。
4. 连接器(Connectors)—— 触手
一个只能读写本地文件的循环是受限的。连接器让 AI 能操作你真正在用的工具——读飞书消息、查数据库、发 Slack 通知、提交 PR。连接器是循环从"给你建议"升级到"帮你执行"的桥梁。 5. 子代理(Sub-agents)—— 写作者和审查者
这是循环中最关键的结构设计:写东西的 AI 和检查东西的 AI 必须是两个。
Anthropic 在官方博客中专门定义了这种模式,叫 Evaluator-Optimizer(评估者-优化者):一个 AI 生成内容,另一个 AI 根据客观标准评审,循环迭代直到通过。
为什么?因为同一个 AI 既写又查,就像学生自己给自己的作业打分——打分太宽松了。
6. 记忆(Memory)—— 状态文件
AI 每次运行之间会忘记一切。这是循环架构的核心事实。解决方案很朴素:一个 Markdown 文件,放在所有循环都能读写的位置。AI 每次运行开始时先读它,结束时把做了什么、下一步计划写回去。
Addy Osmani 说得很直接:Agent 会忘,但文件不会。
这个文件的结构通常是四个部分:上次做了什么、当前在做什么、被什么阻塞了、下一步要尝试什么。保持简短,别让 AI 去读 2000 行的记忆——那还不如没有记忆。
三、为什么这件事现在重要了?
Anthropic 的官方工程博客在定义 Agent 时,措辞从早期的"workflow vs agent"逐步收敛到一句话:Agent 就是 LLM 在循环中自主使用工具。 他们观察到整个行业都在向这个范式收敛。
同时,Anthropic 提出了一个重要的设计原则:从最简单的方案开始,只在必要时增加复杂度。 很多任务用单次 LLM 调用加上检索和上下文示例就够了。只有当任务需要灵活性和模型驱动的决策时,才值得构建 Agent 循环。
这意味着 Loop Engineering 不是"所有工作都要用循环",而是识别哪些工作值得被循环化。判断标准很简单:这件事你是不是每天/每周都在重复做,而且每次做的步骤基本一样? 如果是,它就是循环的候选人。
四、实操:从零开始构建你的第一个循环
第一步:找到你的重复性任务
翻一下你过去一周的工作记录,找到那些你做了三次以上、步骤基本固定的任务。比如:
选最简单的那一个,作为你的第一个循环。
第二步:创建状态文件
在你的项目目录下创建一个 STATE.md,写入以下结构:
这个文件就是你的循环的全部记忆。简单到不能再简单,但它就是有效。
第三步:写一个触发器
最简单的触发器就是一个定时任务。你不需要从复杂的 webhook 开始,一个 cron job 就够了:
如果你用的是 Claude Code,它内置了 /loop(按间隔重复运行)和 /goal(持续运行直到满足条件)两个原语。
第四步:设定硬性停止条件
没有退出条件的循环会失控。你的停止条件必须是可被外部验证的客观标准,而不是"AI 说它做完了"。
好的停止条件:测试全部通过、文章字数在 1100-1500 之间且包含必需章节、所有待处理 issue 已分类完毕。
坏的停止条件:AI 回复"任务完成"。
同时设置一个最大迭代次数作为兜底,一般 10-20 次。如果达到上限仍未满足条件,停下来交给人工。
第五步:从 Level 1 开始,逐步放手
Boris Cherny 提出了一个"自主梯度"的概念:
新循环永远从 Level 1 或 2 开始。 让它跑一周,每天看它的输出,纠正错误。当循环能持续产出你无需修改就会批准的结果时,再升级。Level 4 是靠表现挣来的,不是默认的。
五、第一个循环跑起来后,怎么扩展?
让循环之间互相连接
你的第二个循环不应该是和第一个完全独立的另一件事,而应该和第一个形成管道。
一个常见的组合:
- 循环 A(发现):每天早上扫描信息源,按规则筛选分级,结果写入
TRIAGE.md
- 循环 B(执行):读取
TRIAGE.md,对最高优先级的项目生成初稿,写入 DRAFTS.md
两个循环通过共享文件连接。各自独立运行,但合在一起就是一条从"发现问题"到"开始处理"的自动管道。
让循环共享技能
一旦你为"如何筛选新闻"写了一个技能文件,所有涉及新闻筛选的循环都读取同一份技能。你不需要在每个循环里重新解释一遍规则。
这是循环比单次提示词更有杠杆的根本原因:知识被编码一次,被复用无数次。
六、容易踩的坑
Token 成本会爆炸
一次写错的提示词只是浪费一次调用。但一个写错的循环无人值守跑一整夜,是一笔实实在在的账单。
在让任何循环无人值守运行之前:手动跑 3-5 次,记录每次的 Token 消耗。用最大迭代次数乘以单次消耗,算出单次运行的最差成本。再乘以触发频率,得出每日最差成本。
检查者必须有硬信号
让第二个 AI "审查"第一个 AI 的输出,如果没有客观标准,只是多了一个乐观主义者。检查者需要的是硬性关卡:测试套件、lint 规则、字数要求、格式校验——而不是"你觉得这个怎么样"。
对于内容生产场景,你需要自己构建"内容 CI":把你的写作规范中所有可量化的规则(标题字数、段落数量、禁用词汇、必含要素)变成可自动检测的校验器。
理解力债务会悄悄累积
Addy Osmani 特别警告了一个风险:循环跑得越快,你对输出物的理解就越容易落后。他称之为 Comprehension Debt(理解力债务)。循环替你产出了大量内容或代码,但如果你不读它产出的东西,你和自己的项目之间就会出现认知断层。
设计循环的人必须同时是审查输出的人。 这不是可选项。
七、一句话总结
Loop Engineering 的核心不是什么新技术,而是一个思维转变:你的工作不再是给 AI 写指令,而是设计一个能自己给 AI 写指令的系统。
你写的提示词变少了,不是因为你做得少了,而是因为循环在替你写提示词。你的注意力转移到了真正需要人类参与的部分:审查节点、停止条件、以及下一个值得构建的循环。
正如 Addy Osmani 的结尾所说:去构建你的循环,但要像一个打算继续当工程师的人那样去构建它——而不是一个只想按下启动键的人。
 AI 速览