患者对大模型诊断结果过度信赖,反而让医患之间的沟通成本变高了。AI看病问诊到底靠不靠谱、安不安全?一边是通用大模型正逐渐成为大众获取健康信息的首选入口,另一边却是整个医疗行业反复强调,通用模型并不适合直接承担医疗判断的角色。这个问题其实应该再往下挖一层:究竟哪种类型的AI才有资格真正靠近医疗这条赛道?我们到底需要一款什么样的医疗AI?
一、朝着"能被患者托付"的方向,医疗增强大模型Baichuan-M4登场
任何想要落地到医疗场景中的AI,都必须在通用大模型的基础上,完成结构性的重新构建,再叠加医疗领域的专项增强,才有可能真正服务于医疗。
百川智能推出的Baichuan-M4,正是沿着这个方向交出的一份答卷。
一直以来,百川在这条赛道上的推进路径都相当清晰,从M1一路走到M4,始终在持续拓展通用大模型在医疗场景里的能力边界。
到了M3这个阶段,整条路线开始真正收拢成一套完整体系,形成了一条清晰可见的能力基线,由评测领先、范式原创、贴近临床以及外部验证这四个要素共同支撑起一套信任体系。
而M4,则是在这条基线之上的进一步延伸。
不妨从最新发布的技术报告里看个究竟。
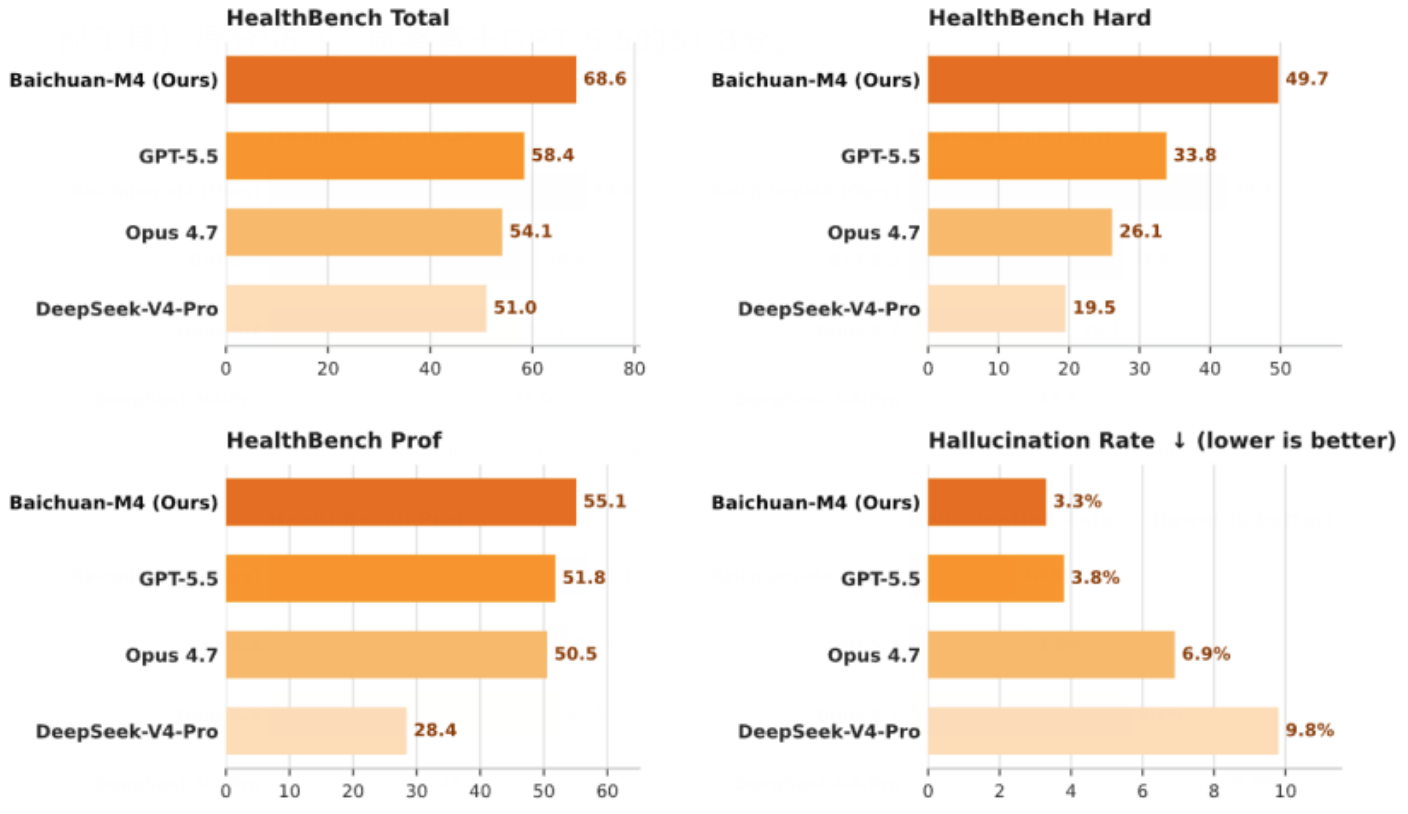
在最新的评测体系中,M4依旧保持着全球领先的位置。HealthBench综合得分提升到了68.6,Hard任务部分提升到49.7,幻觉率也进一步降到了3.3%。在更贴近真实临床场景的HealthBench Professional评测里,M4在不接外部工具的基础推理环节拿到55.1分,明显高于GPT-5.5的51.8分。
但如果只盯着分数看,这终究只能算是一次连续性的优化结果。M4真正发生质变的地方,其实在能力结构层面——它正在从"单点问答的优化",转向"对整个医疗过程能力的重构"。这一转变,大致可以拆解成四个层面的升级。
1、学会提问:从单轮问诊走向深度诊疗
真实世界里的问诊,本质上是一个不断追问、持续补全信息的过程。
基于SCAN-bench 2.0这套评测体系,M4把训练场景从过去单次标准化的问诊,扩展到了多轮访视以及更复杂的患者画像,使模型即便面对不完整的信息,也能持续推进诊疗路径往下走。
在动态问诊评测SCAN-bench上,M4初诊得分79.0、复诊得分74.7,都明显领先于其他顶尖模型;长上下文临床记忆得分达到86.9,相比上一代M3提升了21.1分,是同类模型中表现最好的。
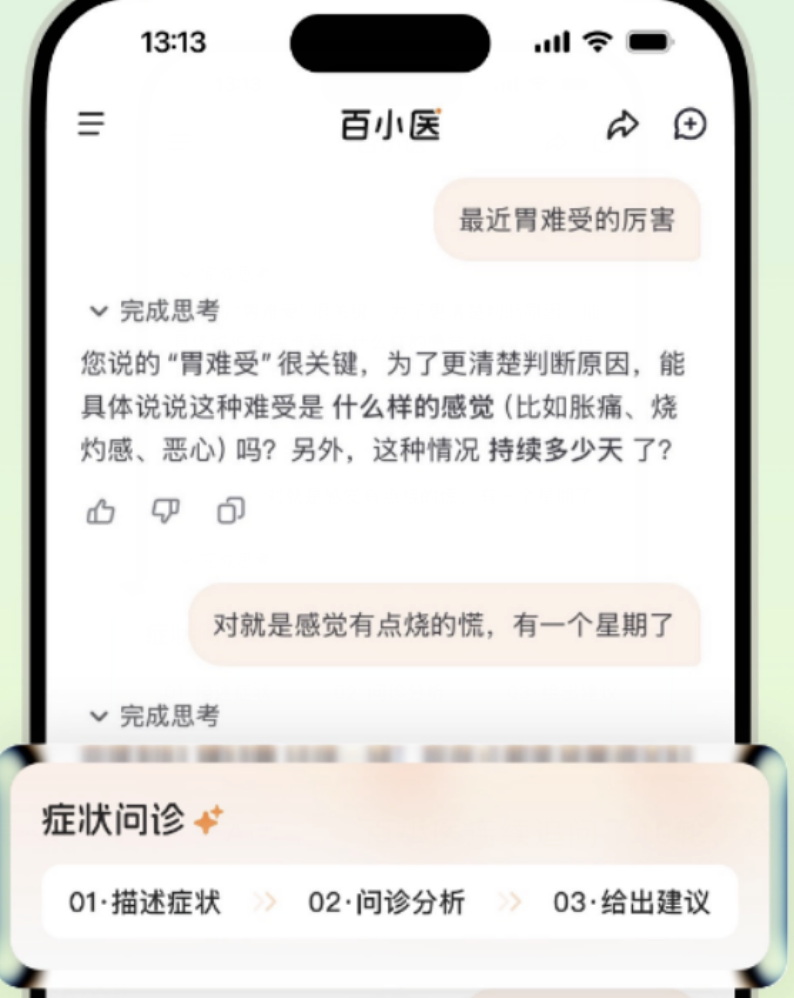
搭载了M4能力的百川C端产品百小医上,这项能力的重要性体现得格外直观。
这"连续追问10轮"几个字值得划重点。
这并不是闲聊,而是在通过持续追问补全病史信息,逐渐缩小风险判断的范围。模型会在多轮对话中持续追问饮食结构、发作频率、用药历史以及近期各项指标的变化情况,系统逐步收窄风险判断的路径,整个过程更接近真实门诊里复诊的样子。
2、学会循证:从内容生成走向证据驱动
"有没有依据",是医疗判断里最关键的一环。
在循证这一层面上,M4构建了一套原子化的临床路径体系,把复杂的医学指南拆解成1000多个可复用的临床决策单元,覆盖了200多种常见疾病的完整诊疗流程。
在此基础上,研究团队还引入了更严格的证据锚定机制,让模型的输出能够稳定对齐医学证据本身。很多通用模型也喜欢在结论后面甩出一堆文献引用,但点开一看常常对不上号——要么引用编号在那儿,内容却完全是两码事;要么文献本身没问题,但被引用的那一段跟结论根本不沾边。
证据锚定要解决的,正是让每一句结论都能精确对应到原文的具体段落,顺着就能查到出处来源。在Baichuan-EBM评测中,M4的循证引用精度达到了90.0,明显高于GPT-5.5的54.7。
3、具备Harness调度能力,提供持续不断的健康管理服务
如果说问诊解决的是单次决策的问题,循证解决的是结论正确与否的问题,那么调度和记忆要解决的,就是时间维度上的问题。
M4引入了Harness架构。有了这套相当于神经中枢的系统,什么时候该追问、什么时候该检索证据、什么时候该调出既往病史,全部由模型自主判断决定,不需要人工一步步下指令。
面对文献检索、长病史梳理这类繁重的任务,它会自动拆解成多个子任务并行处理,让模型能够专注于整体诊疗路径的判断;而每一个执行动作,都在实时的安全约束之下完成。一旦出现违规的工具调用、越权的数据访问,或者不符合临床规范的操作,系统会当场拦下来。
更值得一提的是,这套系统并非一次成型就一劳永逸,而是在真实诊疗过程中持续迭代——线上出现的疑难病例、用户的追问内容、医生的纠偏意见,经过脱敏和归因处理后会重新回流到系统里,成为模型继续改进的依据。
问诊、记忆、循证这三块能力由此被编排整合成一个完整的系统,M4也因此从一个能力最强的医疗大脑,进化成了能够独立完成连续诊疗的医疗智能体。
4、全病程记忆,始终掌握患者的完整上下文
真实的诊疗过程,很少能在一次问诊里就画上句号。
一次化验结果、一次用药后的身体反应、一个新冒出来的症状,都可能随着病情推进不断改写医生原本的判断——这也意味着,只有记住一个人完整的病史,才能给出更精准的建议。
针对这一点,M4推出了"全病程记忆"功能,把历史病历、多轮问诊记录、化验指标趋势以及用药反馈全部打通,让模型在多次对话中始终清楚患者是谁、过去患过哪些疾病、各项指标是如何变化的,而不必每一次都从零开始重新了解。在长上下文临床记忆评测中,M4取得了86.9分的成绩,是同类模型中最高的,相比上一代M3提升了21.1分。
记住一个人完整的病程,是实现精准医疗的前提,而很多关键信息往往就藏在那些看似不起眼的随口闲聊里。
"主动关心"这项能力,对医疗场景而言显得格外重要。在中国医学科学院肿瘤医院开展的75个患者群测试中,多个群在27天内一共产生了6944条对话,百小医的安全性达到99.6%,深度互动率维持在60%到73%之间。
正是通过这样高频次的互动,百小医才能积累下足够丰富的健康上下文信息,让M4在后续的问诊、提醒和风险识别过程中表现得更具连续性。
从某种程度上说,这正体现了百川想要长期推进的方向:用M4提供专业级的大脑能力,用百小医在家庭场景里建立起长期、持续的医疗关系。最终落地的应用形态,便是和真人医生共同构成"双医模式"——医生负责诊断与治疗决策,AI负责诊室之外的长期陪伴、信息整理以及风险提醒工作。
二、医疗推理能力,保障模型输出的稳定性
当然,模型自身的能力,终究是支撑这一切的根基所在。
面对复杂的医疗问题,M4进一步强化了多模态能力。在多模态方面,对复杂检验报告和化验单的结构化识别得分达到0.914,能够较好地支持医学影像与结构化报告的理解,使模型在面对复杂信息输入时依然能保持稳定的判断能力。这部分能力更多起到的是补强作用,用来保证模型在复杂医疗场景下的稳定表现。
整体来看,M4是在M3已经搭建好的医疗专用基线之上,完成了一次系统性的能力重构。它让医疗AI从单纯"回答问题",走向了"参与诊疗的全过程";从"单次交互",走向了"可以被长期托付"。
作为一家通用大模型公司,百川把旗下能力最强的模型投向了医疗这样一个高风险、高复杂度的场景。过去两年里,大模型行业其实始终存在一个争议:医疗到底只是大模型众多应用方向中的一个,还是值得单独重新构建一整套模型体系?从如今的情况来看,百川身上最核心的标签,或许首先还是"通用大模型"——只不过他们恰好选择了医疗这个最难啃的场景,把它当作检验这个"通用大模型"成色的一场大考。
 AI 速览