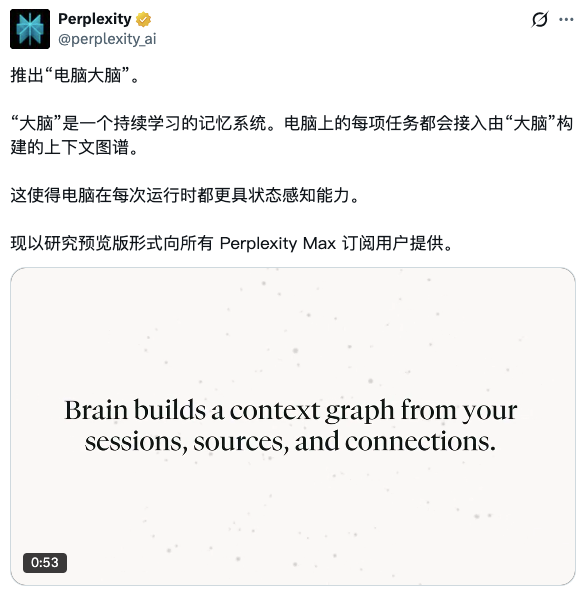
6月19日消息,Perplexity发布Brain,为其Computer代理平台增加了一套自改进记忆系统。据Perplexity官方博客介绍,Brain的核心设计区别于传统AI记忆——它记录的是"工作本身"而非用户个人偏好,目前以Research Preview形式向Max(200美元/月)和Enterprise Max订阅用户开放。 上下文图谱加夜间合成的双层架构
据Perplexity官方博客"Self-improving Memory for Agents"一文描述,Brain的运作分为两层。第一层是实时上下文图谱:每次Computer完成一个任务,Brain将过程数据写入图谱,包括调用了哪些连接器、哪些信息源有效、用户做了哪些纠正、哪些路径走进了死胡同。
第二层是夜间合成:Brain在设定的间隔(默认为夜间)对图谱进行增量更新,综合用户的历史会话、连接器返回结果、源文档变更和纠正记录,将合成后的内容写入一套个人LLM Wiki。据Decrypt报道,这套Wiki在下一次任务启动前自动加载进Computer的沙盒环境,相当于为代理预装了一份经过校验的工作记忆。
每条记忆条目都链接回其来源会话或文件,用户可以追溯任何决策的原始依据。据MarkTechPost报道,Perplexity将这种可追溯性视为与黑箱记忆系统的关键区分点。
从"无状态工具"到"积累经验的助手"
Brain改变的核心场景是重复性知识工作。在没有Brain的情况下,Computer每次启动任务都从零开始,用户需要反复提供项目背景、工具偏好和历史决策。Brain上线后,代理在处理用户已经做过的同类任务时可以直接调用历史上下文,减少交互轮次和模型调用次数。
据Perplexity内部测试数据(非独立基准),Brain在已处理过的任务类型上将答案准确率提升25%,召回率提升16%,涉及历史上下文的任务运行成本降低13%。Perplexity将当前的token消耗定性为"对未来更高效token使用的投资"——随着图谱积累,代理在后续任务中需要的探索性调用会减少。
需要注意的是,这些数字来自Perplexity自身的早期测试,尚无第三方独立验证。实际效果在不同任务类型和使用频率下可能存在显著差异。
自托管方案已有先行者,数据主权是分水岭
Brain并非Agent记忆赛道的首个产品。据Decrypt 6月18日的对比分析,开源社区已有两套走在前面的自改进Agent框架。OpenClaw在2026年4月增加了"溯源标签"(providence labels),对每条存储记忆标注其来源可信度——观测所得、用户确认、模型推断还是从记录导入。Hermes在每次任务完成后评估结果、提取可复用推理模式并写入Markdown技能文件,下次遇到类似问题时直接加载而非从头推理。
二者与Brain的根本差异在于数据主权:OpenClaw和Hermes均为自托管,数据留在用户自己的硬件上;Brain的上下文图谱、LLM Wiki和全部会话历史存储在Perplexity的基础设施上。用户可以查看和管理存储内容,但不拥有底层数据的完全控制权。对于需要完整数据主权的企业用户,这是选择自托管方案而非Brain的核心理由。
内部数据未经独立验证,夜间更新引入延迟,数据治理待明确
第一,Brain宣称的25%准确率提升、16%召回率提升和13%成本降低均为Perplexity内部早期测试数据,目前没有独立基准测试验证这些数字的可复现性和泛化能力,用户在不同任务类型、使用频率和领域复杂度下的实际体验可能存在显著偏差。第二,Brain的夜间合成机制意味着改进是按计划批量生效而非实时响应,用户在日内做出的纠正和新发现需要等到下一个合成周期才能反映在代理行为中,对于需要即时反馈的高频迭代场景,这一延迟可能造成体验断裂。第三,将完整的工作历史、决策路径和信息源偏好持久化存储在第三方基础设施上,引发的数据治理问题超出了传统用户偏好记忆的范畴——Perplexity尚未详细说明数据保留期限、跨组织隔离机制和用户退出后的数据清除流程。
 AI 速览