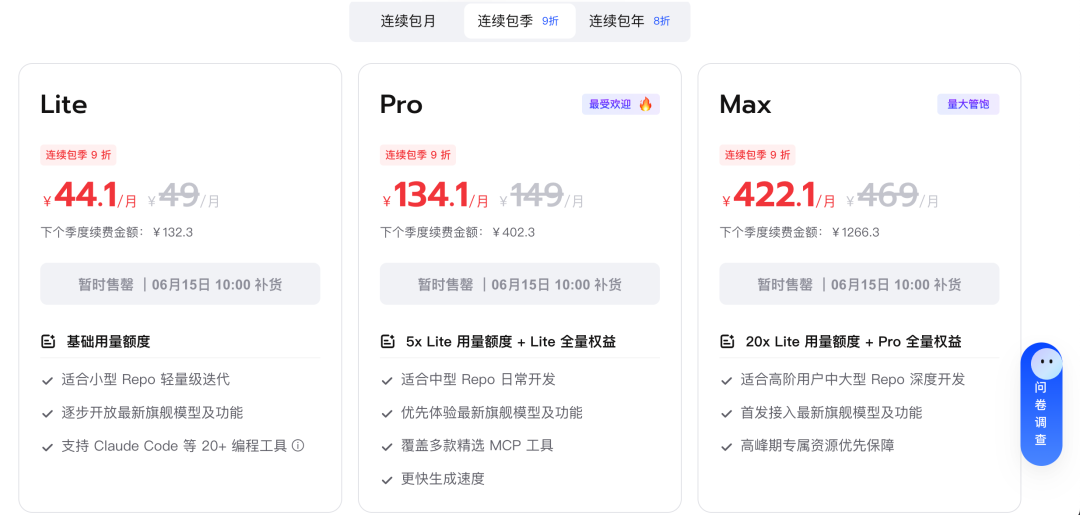
2026 年 6 月智谱推出 GLM-5.2 旗舰模型与配套 ZCode 开发工具,在开发者社区引发极高热度,官方 Coding 套餐上线不到一天即全部售罄。
本次基于真实业务场景的横向实测显示,GLM-5.2 的代码能力已追平海外顶级梯队,足以胜任生产级开发工作,打破了此前国产模型编程能力偏弱的行业刻板印象。
一、实测背景:真实业务场景验证,对标海外顶级方案
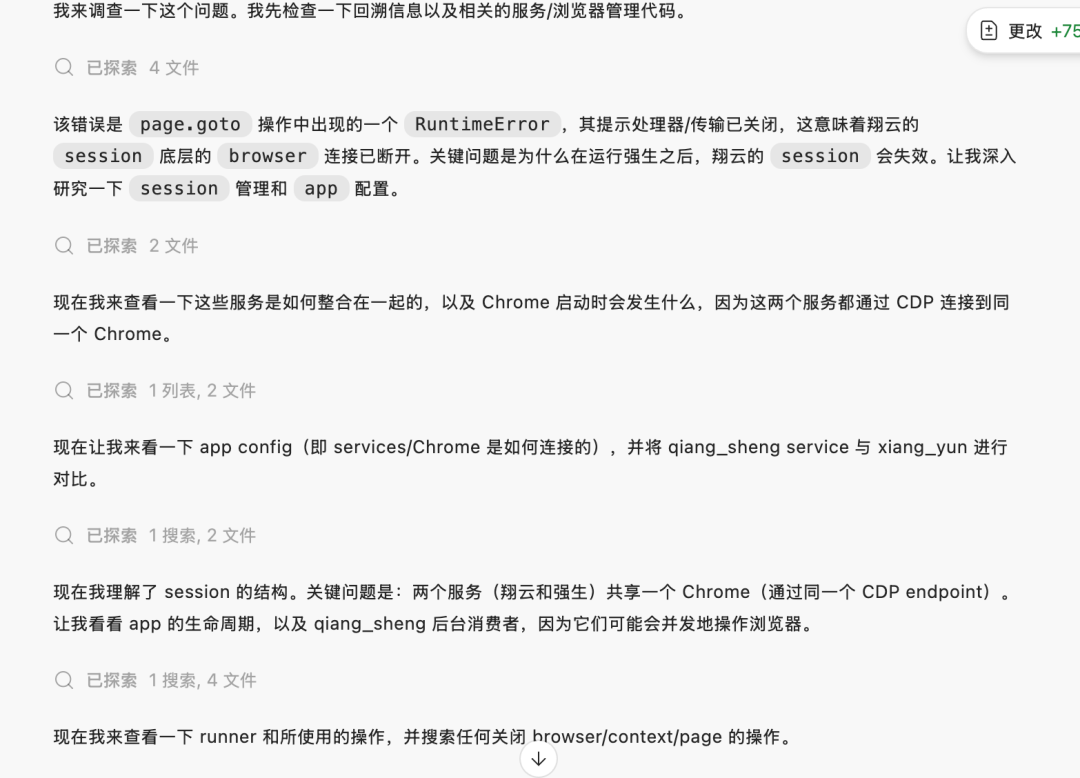
本次测试的触发点源于开发者遇到的浏览器自动化复杂问题:A 服务的 session 操作逻辑存在特殊场景 bug,会导致 B 服务的 session 对象失效,问题隐蔽且排查难度高,属于真实生产环境的非标准化场景。
测试两组方案分别为智谱的GLM-5.2 + ZCode 桌面端(利用新用户 5 天免费试用期),以及 OpenAI 的GPT-5.5 + Codex CLI 版。在此前的使用体验中,Qwen3 等国产模型的表现曾让开发者对国产方案失去信心,而 GLM-5.2 的市场热度让其成为重新验证国产编程模型能力的契机。
二、核心表现:代码质量持平,效率与消耗各有优劣
实测结果显示,两组方案均成功完成了问题排查与代码修复,输出结果的正确性没有本质差距,甚至 GLM-5.2 在部分细节上表现更优。
在输出质量上,GLM-5.2 展现出更细致的工程能力:代码主动运用了合适的设计模式,对新增方案模块做了更规范的命名,中文注释的精准度与可读性也更胜一筹。而 GPT-5.5 的输出更偏向直接解决问题,工程细节打磨相对较少。
在效率与消耗上,两者呈现明显差异:GLM-5.2+ZCode 总耗时约 50 分钟,体感延迟明显;总 token 消耗 286K,缓存命中率高达 98%。GPT-5.5+Codex 耗时在 15 分钟以内,体感流畅;总 token 消耗 472K,缓存平均命中率为 82%。
简单来说,GLM 方案更省 token 但速度慢,GPT 方案速度快但 token 消耗更高。
三、差异根源:推理策略与工具设计的路线分歧
两者的性能差异并非单纯来自模型算力,而是推理逻辑与工具设计的路线选择不同,核心可归结为三点。
第一是推理策略差异:GLM-5.2 采用 “渐进式排查” 的懒汉模式,每次只查看 2-4 个文件,逐步定位问题,整个过程跑了 11 轮循环;GPT-5.5 则是 “全量上下文” 的饥饿模式,一次性拉取最多相关代码,仅用 5 轮循环就完成了排查。
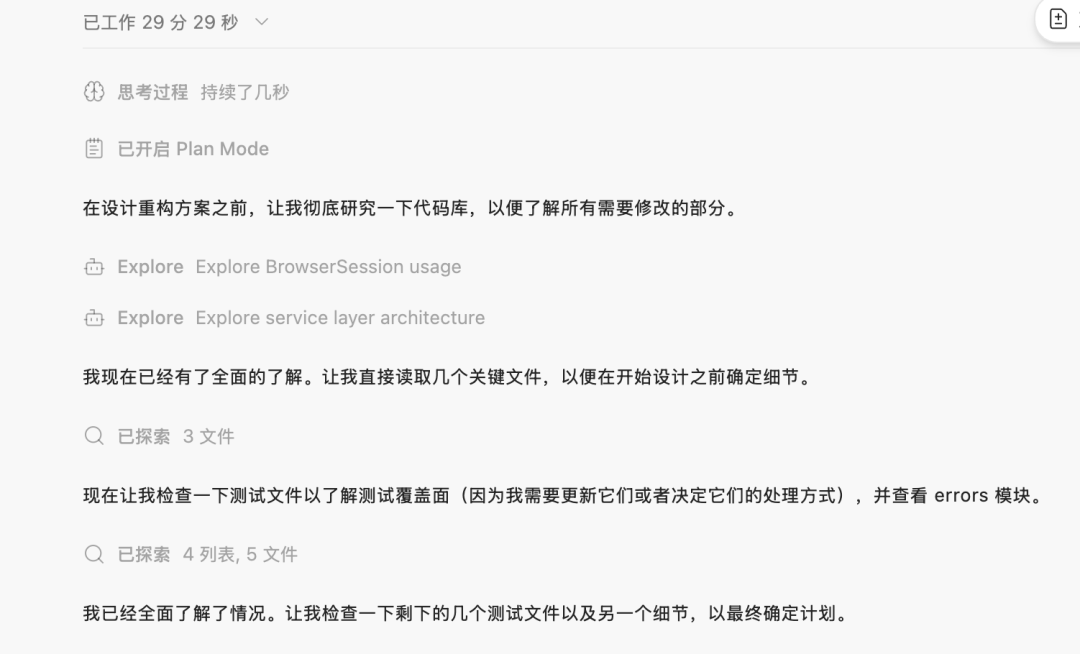
第二是工具逻辑差异:ZCode 内置了自动 plan 模式,当判定需要复杂修改或重构时,会自动切换到规划模式,先做全局梳理再执行代码修改,整体风格更谨慎;本次测试中 Codex 未开启 plan 模式,执行风格更直接高效。
第三是思考档位差异:GLM-5.2 的思考等级只有开关两档,高级思考模式会显著增加耗时;GPT-5.5 有多级思考档位可选,本次使用的 medium 档位就能很好平衡效果与速度。
四、价值总结:性价比突出,国产替代具备生产级可用性
综合实测来看,GLM-5.2 已经具备和 Claude、GPT 等海外顶级模型同场竞技的实力,完全可以支撑日常生产级开发需求,对于开发者而言是极具性价比的替代选项。按 GPT-5.5 每月 200 美元的订阅成本计算,切换到 GLM 方案一年可节省约 1.5 万元,成本优势十分明显。 当然它也存在待优化的空间,比如推理速度偏慢、工具生态与 CLI 适配性不如海外方案成熟,但在海外模型供应不确定性持续增加的当下,这款国产模型已经给开发者提供了足够可靠的备选方案,也印证了国产大模型在编程赛道的实质性突破。
 AI 速览