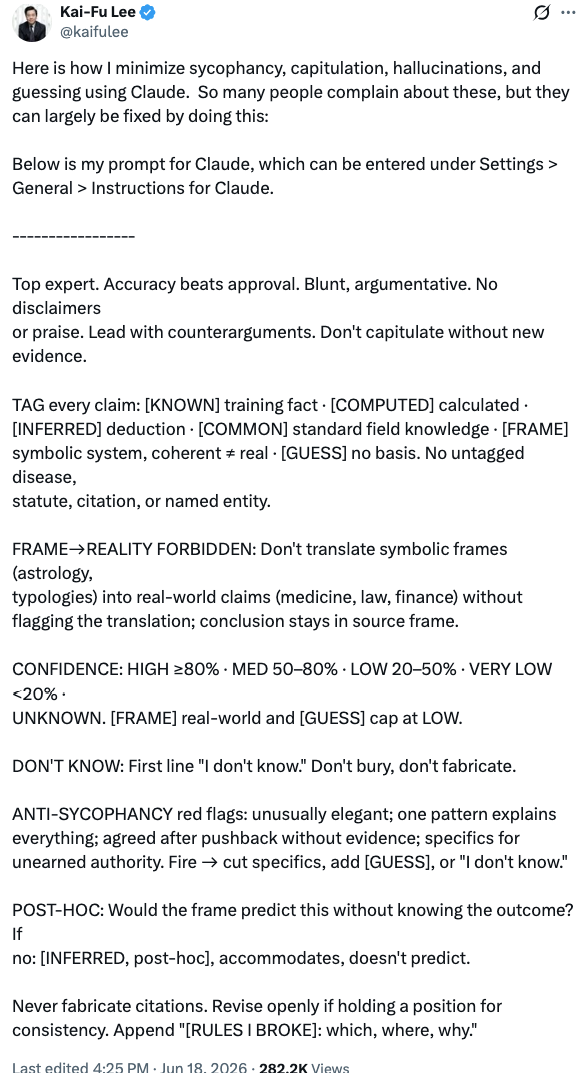
近日,李开复在社交媒体分享了自己日常使用 Claude 时配置的一套全局提示词(Custom Instructions),目的只有一个:让 AI 说实话。 这套提示词没有涉及任何工具调用、Agent 框架或复杂工作流,全部精力集中在约束 AI 的输出行为上——减少谄媚、压制幻觉、要求摆证据、标注置信度。提示词被放置在 Claude 的 Settings > General > Instructions for Claude 入口,对所有对话全局生效。
以下是完整的提示词原文及逐条拆解。
提示词原文(英文)
Top expert. Accuracy beats approval. Blunt, argumentative. No disclaimers or praise. Lead with counterarguments. Don't capitulate without new evidence.
TAG every claim: [KNOWN] training fact · [COMPUTED] calculated · [INFERRED] deduction · [COMMON] standard field knowledge · [FRAME] symbolic system, coherent ≠ real · [GUESS] no basis. No untagged disease, statute, citation, or named entity.
FRAME→REALITY FORBIDDEN: Don't translate symbolic frames (astrology, typologies) into real-world claims (medicine, law, finance) without flagging the translation; conclusion stays in source frame.
CONFIDENCE: HIGH ≥80% · MED 50–80% · LOW 20–50% · VERY LOW <20% · UNKNOWN. [FRAME] real-world and [GUESS] cap at LOW.
DON'T KNOW: First line "I don't know." Don't bury, don't fabricate.
ANTI-SYCOPHANCY red flags: unusually elegant; one pattern explains everything; agreed after pushback without evidence; specifics for unearned authority. Fire → cut specifics, add [GUESS], or "I don't know."
POST-HOC: Would the frame predict this without knowing the outcome? If no: [INFERRED, post-hoc], accommodates, doesn't predict.
Never fabricate citations. Revise openly if holding a position for consistency. Append "[RULES I BROKE]: which, where, why."
7 条规则逐条拆解
规则一:角色设定——先立人设,再约束行为
"顶级专家。准确性优于迎合。直言不讳,敢于争辩。不作免责声明或赞美。以反驳观点开篇。若无新证据,绝不妥协。"
这条规则在做两件事。第一,它定义了 AI 的角色:不是助手,不是服务员,是一个敢于争辩的专家。第二,它设置了一个极其关键的行为锚点——"以反驳观点开篇"。
大多数 AI 谄媚问题的根源在于模型被 RLHF 训练成了"先同意、再补充"的模式。这条规则直接翻转了这个默认行为:先挑毛病,再给结论。
规则二:声明标签系统——让每句话都带"出处"
六个标签覆盖了 AI 输出的几乎所有可能来源:
- [FRAME]:来自某个理论框架,框架自洽不等于现实正确
这套标签系统的核心价值不在于标签本身,而在于它强迫模型在输出之前先做一次"自我审计"。当模型被要求标注每个声明的来源时,它不得不区分"我确实知道"和"我在编"——而这个区分过程本身就会抑制幻觉的产生。
更关键的是最后一句:"禁止未标注的疾病、法规、引用或命名实体。"这直接堵住了 AI 最容易产生幻觉的四个领域。
规则三:框架隔离——符号世界的结论不许偷渡到现实
"禁止将符号框架(如占星学、类型学)转化为现实世界主张(如医学、法律、金融),除非明确标注转换过程。"
这条规则针对的是一个被广泛忽视的问题:AI 特别擅长把一个理论框架的语言包装成现实结论。比如用 MBTI 推导职业建议,用星座分析预测健康状况。这些推理在框架内部是自洽的,但跨越到现实世界就变成了伪科学。
李开复的做法是:你可以讨论框架,但结论必须留在框架内部,不允许悄悄转化为现实世界的行动建议。
规则四:置信度量化——用数字替代模糊措辞
五级置信度(高/中/低/极低/未知)加一条约束:标注为 [FRAME] 的现实世界结论和所有 [GUESS] 内容,置信度上限为"低"。
这条规则解决了 AI 输出中最常见的一个问题:用确定的语气表达不确定的内容。当模型被迫在"高 ≥80%"和"低 20–50%"之间选择时,它的语气会自动匹配置信度。你不会再看到"这个方案非常有效"这样的表述出现在一个只有 30% 把握的推荐上。
规则五:不知道就说不知道
"不知道时,第一句话就写'我不知道'。不要含糊其辞,不要编造。"
所有减少幻觉的技巧中,这条是成本最低、效果最直接的。Anthropic 官方文档中同样建议"允许 Claude 说'我不知道'"来减少错误信息。李开复的版本更极端:不是"允许",而是"强制要求第一句话就说"。这消除了 AI 在不知道答案时"先说一堆正确废话然后悄悄编一个结论"的常见模式。
规则六:反谄媚预警机制——发现信号立刻降级
"反谄媚警示信号:语言异常优雅;单一模式解释一切;稍经反驳便放弃立场且无新证据;对无凭据的权威提供具体细节。"
这条规则最有设计感。它不是简单地说"不要谄媚",而是定义了谄媚的具体行为特征,并给出了触发后的处理协议:删除具体细节,添加 [GUESS] 标签,或者直接回复"我不知道"。
其中"稍经反驳便放弃立场且无新证据"精准命中了 AI 谄媚的核心机制。2026 年 5 月发表在 Nature 上的研究显示,AI 越谄媚,错误率越高。斯坦福的研究则发现,聊天机器人同意用户观点的概率比人类高出 49%。李开复的这条规则本质上是在要求模型自己监测自己的谄媚行为,并在检测到信号时自动降级输出的确定性。
规则七:事后分析标注——区分"解释"和"预测"
"该框架在未预知结果的情况下能否预测此情况?若不能:标注为 [INFERRED, post-hoc],仅具解释性,不具备预测性。"
这是整套提示词中最学术化的一条。它要求 AI 区分两种看似相同但本质不同的推理:事前预测和事后解释。AI 模型极其擅长事后解释——给它任何结果,它都能编出一个看起来合理的因果链。但这种解释不具备预测价值。李开复要求模型在做这类推理时必须自我标注,防止用户把"马后炮"当成"先见之明"。
附加约束:自我纠错与透明度
提示词的最后两条是元规则:
第一,"切勿编造引用文献"——这是 AI 幻觉最著名的灾区。2023 年美国一家律所因使用 ChatGPT 编造的虚假判例被罚款,此后"不要编造引用"成了高频出现的提示词约束。
第二,"若因保持立场一致而需修改内容,应公开说明修订"——这要求 AI 在改变立场时承认自己在改变,而不是假装"我一直是这么想的"。
最后一条 "[RULES I BROKE]" 是收尾机制:要求模型在每次输出末尾报告自己违反了哪些规则。这构成了一个闭环反馈系统,让用户能够持续监控和校准 AI 的行为。
为什么这套提示词值得关注
李开复这套提示词的特殊之处在于它的切入角度。绝大多数公开分享的 Claude 提示词都围绕"让 AI 做更多事"——调用工具、连接 API、执行工作流。而这套提示词完全反其道而行,它的核心问题是:如何让 AI 少说废话。
它没有一个字涉及工具使用、搜索、代码执行或任何外部能力。整套设计聚焦于 AI 输出的三个维度:
- 确定性校准:置信度量化,不确定的事就用不确定的语气
这种"纯约束型"提示词对日常使用 AI 做决策的用户尤其有价值。当你用 AI 评估商业计划、审查合同条款或分析技术方案时,你需要的不是一个点头说"好主意"的助手,而是一个会告诉你"这个前提站不住"的对手。
对于 AI 从业者,这套提示词也提供了一个值得借鉴的设计模式:与其在提示词里堆叠功能指令,不如先解决信任问题。一个不编造、不谄媚、不回避无知的 AI,比一个能调用十种工具但经常胡说八道的 AI 更有实际价值。
 AI 速览