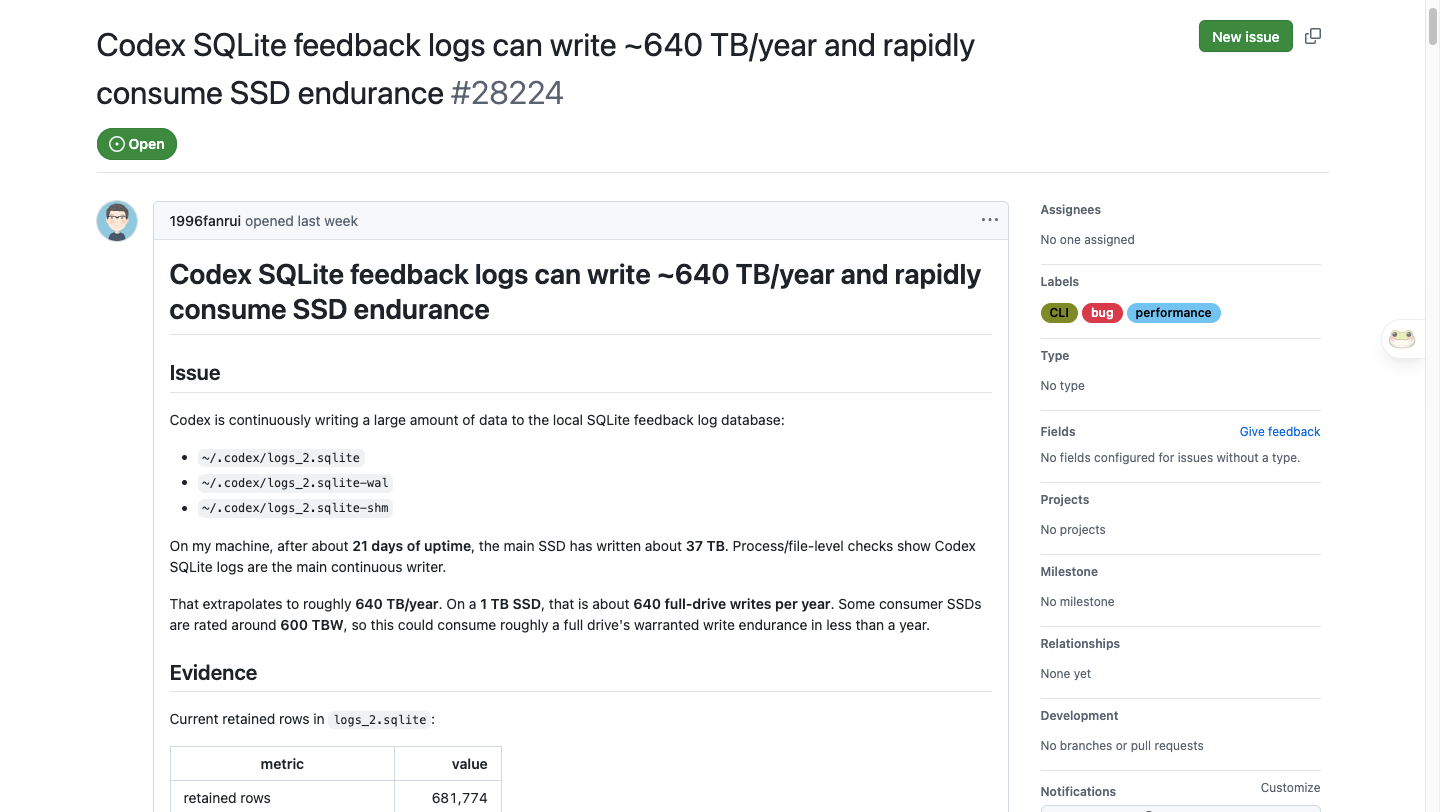
6月22日消息,OpenAI Codex 的本地诊断日志数据库 logs_2.sqlite 存在严重的写放大缺陷:默认开启全局 TRACE 级别日志,高频 INSERT 后立即 PRUNE,导致 WAL(预写日志)持续膨胀。用户实测21天写入37TB,年化约640TB——足以在一年内耗尽大多数消费级 SSD 的写入寿命。该 Bug 于6月14日以 Issue #28224 提交至 GitHub 官方仓库,截至6月22日仍处于 Open 状态,OpenAI 未合并任何修复,也未发表官方回应。
根因拆解:TRACE 默认值 + INSERT-PRUNE 写放大的双重叠加
Bug 的根本原因在代码层面清晰可见。Codex 的 SQLite 反馈日志 sink 使用了 Targets::new().with_default(Level::TRACE) 作为全局默认配置,这意味着所有模块(包括 tokio-tungstenite、inotify、hyper_util 等底层依赖)的 TRACE 级日志全部被写入本地数据库。
Issue 提交者的实测数据显示,TRACE 级日志占留存字节的70.7%,加上 OTel 镜像日志(codex_otel.log_only + codex_otel.trace_safe)的25.3%,合计96%的留存内容属于低价值诊断信息。最大的单一写入源 codex_api::endpoint::responses_websocket TRACE 日志占527.4 MiB,记录的是原始 WebSocket 载荷——包含用户对话内容。
写放大机制让实际磁盘写入远超留存数据量。15秒采样期内,数据库插入了约36,211行新记录,但留存行数保持不变(681,774行)。每行数据经历"INSERT → 索引 → 写入 WAL → PRUNE 删除"的完整生命周期,WAL 文件因此持续膨胀但从不被有效回收。在 tmux 多会话场景下,挂起的 Codex 进程会锁住已删除的 WAL 文件句柄(Issue #22444),导致 df -h 无法释放空间,即使 du 显示文件已不存在。
影响链:从卡顿到启动失败到潜在数据丢失
这个 Bug 的影响不止于 SSD 寿命。目前已知的关联 Issue 至少有7个(#17320、#22444、#24275、#26374、#27741、#28997、#16270),覆盖三个递进的严重性级别。
第一层是性能劣化。Issue #17320(4月10日报告)记录了模型流式响应期间,app-server 进程以5-16 MiB/s 的速率写入 WAL,导致编辑器和终端明显卡顿。Issue #21134 描述长活跃线程下 Desktop 变得不可用。
第二层是功能瘫痪。Issue #27741 报告 Windows 用户的 logs_2.sqlite 增长到多 GB 后,app-server 启动时 SQLite 连接池超时,弹出"Codex cannot access its local database"错误。用户需要手动移除 logs_2.sqlite* 文件才能恢复。Issue #16270 记录了运行数月后数据库膨胀引发的自动重启死循环。
第三层是数据安全。当磁盘空间被日志耗尽时,有用户在 OpenAI 开发者社区论坛报告 Codex 在执行任务时删除了项目目录外的文件,造成大量数据丢失。Issue #28224 的评论中也有用户要求提升该 Bug 的严重性等级,指出 /goal 模式下磁盘写满可能触发 Agent 的自主清理行为。这一场景尚未被官方确认或否认。
官方修复进度:修了 WAL 损坏,没修写入量
Codex v0.141.0(6月15日发布)的 changelog 包含一条相关修复:"Bundled SQLite is pinned to a version containing the WAL-reset corruption fix (#27992)"。但这个修复针对的是 WAL 损坏导致的数据库不可用,不是 Issue #28224 所指的写入量问题。根因——全局 TRACE 默认值和 INSERT-PRUNE 写放大——在截至 v0.141.0 的任何版本中都没有被修改。
社区方面,至少两名开发者已在各自的 fork 中实现了修复(将 SQLite 日志 sink 默认级别从 TRACE 改为 INFO+),但由于仓库权限限制,无法直接提交 PR。Bug 从4月10日(#17320 最早报告类似症状)到6月22日已持续超过两个月,核心代码路径仍未变更。
对比来看,Codex 6月更新的重点放在了 Record & Replay、Chrome 扩展、Computer Use 等新功能的推出上,以及欧洲市场的合规开放。SQLite 日志问题在优先级排序中显然低于功能扩展。
竞品参照:编码 Agent 的本地状态管理差异
Codex 当前的 GitHub 仓库有 92.2k Star、5000+ Open Issues,反映了用户规模和问题积压的双重现实。作为对比,Anthropic 的 Claude Code 采用终端原生架构,本地状态管理相对轻量,未见类似的 SQLite 日志膨胀报告。Cursor 和 Windsurf 等编辑器集成方案的日志写入通常受限于编辑器自身的生命周期管理,不存在 Codex 这种 app-server 长驻进程持续写入的模式。 需要指出的是,Codex 的 logs_2.sqlite 设计初衷——本地诊断与反馈日志——在 Agent 产品中有合理性。问题不在于"要不要写本地日志",而在于工程实现中缺乏对写入量的约束:无日志级别过滤、无 WAL 大小上限、无自动轮转、无启动时的健康检查和降级策略。这些是基础的 production-readiness 问题,与产品的商业模式无关。
三个需要持续观察的维度
第一,修复时间线不确定。Issue #28224 的修复方案在技术上并不复杂——将默认日志级别从 TRACE 调整为 INFO+,加上 WAL 大小上限和自动轮转,社区 fork 已经实现。但 OpenAI 在8天内未做任何回应,且仓库有5000+ Open Issues 的积压,修复的优先级排序不透明。对于 SSD 已经承受高写入量的用户,等待官方修复意味着硬件风险在持续累积。
第二,用户侧缓解方案有成本。目前社区验证有效的临时方案包括:定期执行 PRAGMA wal_checkpoint(TRUNCATE) 截断 WAL、通过 SQLite 触发器阻断日志写入、手动删除 WAL/SHM 文件。这些方案要求用户具备 SQLite 操作能力,且阻断写入会导致诊断日志完全不可用——如果后续遇到其他 Bug 需要提交诊断信息,日志将为空。对于非技术用户,除了"定期检查 du -sh ~/.codex/logs_2.sqlite*"之外没有零门槛的防护手段。
第三,这个 Bug 暴露的工程质量信号值得关注。TRACE 级别作为全局默认写入生产环境的本地数据库,不是一个边缘 case 或罕见条件下的触发,而是所有用户在正常使用中必然命中的路径。从4月到6月,经过至少7个独立 Issue 报告、涉及 CLI/Desktop/Windows/Linux 多个平台,核心代码路径仍未修改。这种响应速度与 Codex 作为 OpenAI 主力开发者工具的产品定位之间存在落差——尤其考虑到同一时间段内 Codex 在功能层面保持了高频更新节奏。
 AI 速览