近日,百度正式开源全模态 OCR 模型 Unlimited OCR,以 3B 总参数、仅 500M 激活参数的轻量体量,拿下 OmniDocBench 基准测试全球第一,更首次实现 40 页文档连续推理不失忆,打破了传统 OCR 逐页处理的行业痛点。
这款技术突破的背后,暗藏着国产 OCR 顶尖人才的流动线索,也为整个文档智能领域带来范式级升级。
一、性能登顶:小参数实现跨量级碾压,长文档能力行业首创
在权威基准 OmniDocBench v1.5 上,Unlimited OCR 拿下 93.23% 的综合得分,v1.6 版本更是达到 93.92%,刷新端到端 OCR 的全球 SOTA 纪录。
对比之下,235B 参数的 Qwen3-VL 仅得 89.15 分,Gemini-2.5 Pro 为 88.03 分,Unlimited OCR 以不足对手零头的参数量,实现了精度层面的全面反超。长文档处理能力是其最核心的突破。 传统 OCR 只能逐页切割处理,翻页即 “失忆”,无法关联跨页上下文;而 Unlimited OCR 首次实现一次推理连续解析 40 页以上文档,全程无信息丢失、无速度衰减。
测试数据显示,20 页文档转录的编辑距离仅 0.057,40 页以上仍控制在 0.11 以下,内容重复率极低。效率层面,输出 6144token 时 TPS 达 7847,比 DeepSeek OCR 高出 35%,且内存占用不随文本长度增长。 二、技术破局:R-SWA 注意力机制,复刻人类 “软遗忘” 认知逻辑
传统 OCR 模型普遍采用标准多头注意力机制,随着输出长度增加,KV 缓存会持续膨胀,导致内存占用飙升、推理速度下降,这是行业只能逐页处理的核心技术瓶颈。
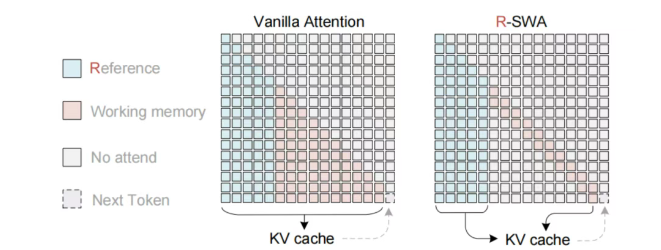
百度 Unlimited OCR 的核心突破,是提出参考滑动窗口注意力(R-SWA),模拟人类抄书时的 “软遗忘” 认知模式:全程可见完整原文,但只保留最近输出的短时记忆。
具体而言,生成每个 token 时,模型都会完整参考全部图像视觉 token 与提示词,保证原文信息不丢失;但输出侧仅回看最近 128 个 token,将 KV 缓存固定为恒定容量的队列,新 token 生成时自动淘汰最旧内容。配合 DeepEncoder 实现 16 倍视觉 token 压缩,图像信息全程不随解码过程退化,最终在 32K 上下文窗口内实现了数十页文档的连续解析,被业内称为长程解析任务的 “免费午餐”—— 仅优化注意力机制,就同时实现了精度、速度与内存的三重收益。
三、团队溯源:核心负责人疑为 DeepSeek OCR 领军人物魏浩然
这款技术风格鲜明的 OCR 模型,背后团队也引发了行业广泛关注。
技术报告中核心作者仅技术总监以 “YY” 缩写署名,结合 GitHub 致谢将 DeepSeek-OCR 系列列为前两位参考项目,以及人才流动时间线,业内普遍推测该技术负责人为原 DeepSeek OCR 核心领军人物魏浩然。魏浩然是国内端到端 OCR 的标杆人物,早年在阶跃星辰主导开发了开源标杆 GOT-OCR2.0,加入 DeepSeek 后一手搭建了完整 OCR 技术体系,DeepEncoder、MoE 解码器等核心架构均出自其团队。
今年 4 月魏浩然被曝从 DeepSeek 离职,此次以技术总监身份亮相百度,恰好印证了行业人才流动的传闻。对百度而言,成熟的 PaddleOCR 产业底座叠加前沿的长程解析技术能力,补齐了从规模化落地到范式引领的完整能力闭环,也成为百度 AIDU 集团级人才计划落地的重要成果。
四、行业价值:从单页识别到整书理解,技术可拓展至全场景
Unlimited OCR 的突破不止于 OCR 赛道本身。
R-SWA 作为通用长程解析机制,未来可拓展至语音识别、机器翻译等更多长序列任务,具备广泛的技术迁移价值。按照技术规划,百度下一步将把模型上下文窗口拓展至 128K,并构建 prefill pool 实现自动翻页能力。届时 OCR 将不再局限于单页文字识别,而是能够完整理解整本书籍、整套文档的逻辑与内容,成为知识数字化、企业文档智能处理的核心基础设施。
从 PaddleOCR 的产业普及,到 Unlimited OCR 的范式突破,百度正在以开源 + 技术引领的路线,持续推动国产 OCR 技术站在全球前沿,也为 AI 多模态理解提供了轻量化、高效率的全新技术思路。
 AI 速览