6月24日消息,AI 初创公司 Engram 正式从隐身模式推出,并宣布完成 9800 万美元 融资。Engram 的核心理念与当前主流大模型截然不同——它不是把算力花在公开互联网数据上,而是从强大的预训练模型出发,将训练算力集中到用户的私有上下文上,让模型真正"学会"用户的工作。
投资方包括 General Catalyst、Kleiner Perkins、Sequoia、Amplify Partners、Neo、SV Angel 等顶级机构。顾问阵容包括 OpenAI 联合创始人 Andrej Karpathy 和 UC 伯克利教授 Pieter Abbeel。 定位:"AI 的记忆层"
Engram 将自己定位为 AI 的记忆层,专注构建能从用户个人或企业上下文中持续学习、记忆并深入理解用户工作的模型。其核心哲学与依赖公开互联网数据训练的大模型形成对比:从强预训练模型出发,将计算资源投入用户私有上下文,实现每日乃至每小时的持续训练,从而达成真正的"持续学习"和高 token 效率。
公司联合创始人兼 CEO 丹·比德曼(Dan Biderman)此前任职于 HazyResearch 等机构,联合创始人 Jessy Lin 为伯克利 AI 博士。团队成员来自斯坦福、伯克利、康奈尔等顶尖机构,在持续学习、记忆架构、上下文压缩、LoRA 等领域拥有多年研究积累。
产品方向:面向共享知识工作区的 Agent API
Engram 的第一个产品是面向大型共享知识工作区的 Agent API。其模型会花费相当于数百年的时间来内化用户的上下文:将信息碎片拼凑在一起,绘制从未被注意的连接,找出未被发现的错误。
对于许多任务,Engram 的模型不需要重新收集上下文,因此能节省 10 倍到 100 倍 的 token 效率。公司表示,其北极星目标是建立一个单一的训练算法,能将任意数量的数据吸收进一个不断改进的模型中——目前每日对所有公司数据运行训练流程,正在向每小时、最终每分钟重新训练的方向推进。
早期合作伙伴
Engram 已与多家头部企业建立合作:
- Notion:共同构建能理解大型 Notion 工作区的自定义 Agent
- Harvey:法律 AI 领域,开发能内化整个公司知识、在众多客户事务中搜索和找到先例的模型
- Microsoft:在 Microsoft 365 中试点 Engram 模型,为企业客户提供定制化 Agent
团队与背景
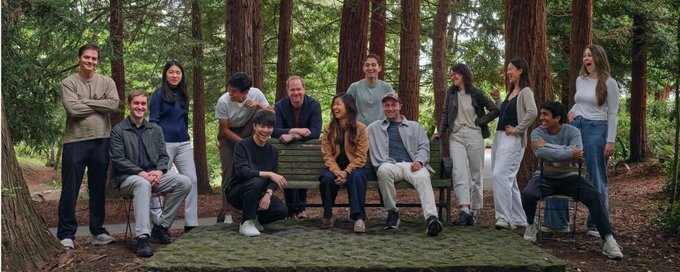
Engram 成立于 2025 年,总部位于加州帕洛阿尔托。核心团队包括:
- 丹·比德曼(CEO):曾任职于 HazyResearch
- Jessy Lin(联合创始人):伯克利 AI 博士
- Sabri Eyuboglu、Jack Morris、Howard Chen 等核心研究人员
团队从多个角度研究了上下文压缩、检索、LoRA、合成数据、长上下文和记忆架构问题,研究方向涵盖人类和机器中的记忆与遗忘机制。公司认为已找到一个新的、具体的扩展轴——将算力用于研究和内化数据,为构建理解用户和用户工作的模型提供了一条可行路径。
 AI 速览