《三体》里有一个令人印象深刻的"农场主假说":农场主每天上午11点准时给火鸡投食,一只"火鸡科学家"观察了整整一年,归纳出"11点必有食物降临"的铁律。直到感恩节那天,农场主带来的不再是饲料,而是屠刀。
这个寓言最初源自罗素关于归纳问题的经典思想实验,它揭示了一个根本性的认知盲区:从历史数据中总结出的相关规律,并不等同于对世界运作机制的真正理解。火鸡的问题不在于观察样本不够多,而在于它从未思考"为什么被喂养",也从未察觉自己身处的系统中真实的因果关系。
今天的AI,在某种意义上正面临着相似的困境。
规模化学习的边界在哪里?
过去几年,大模型的崛起让我们见识到规模化学习可以把模式识别推到何等高度。无论是语料、图像、视频还是机器人运动轨迹,模型都能从中提炼出复杂规律,并在大量任务上展现出令人惊叹的泛化能力。
然而,当AI开始真正进入物理世界,情况就发生了本质变化。环境不再是静态数据集,行动也不再是生成文字或像素——每一次抓取、每一次转向,都会实实在在地改变世界本身。
因此,真正的核心问题不再只是"模型能不能预测下一步会发生什么",而是"模型能不能理解自己的行动将如何重写这个世界"。
Aether AI正是从这一问题切入,将自身的技术路线定义为因果世界模型(Causal World Models)。与只预测下一状态的传统世界模型不同,Aether AI更关注模型能否识别真正影响结果的关键变量、理解变量之间的因果结构,并在行动之前模拟不同干预可能带来的连锁后果。
其首个落地方向是Physical AI——不造机器人本体,而是构建感知与控制之间的智能推理层,让机器人在观察环境后,不只是判断"下一步最可能发生什么",而是能够推演"如果我这样做,世界会如何随之改变"。
预测得再准,也不等于理解了因果
过去三年,AI在"预测下一步"这件事上取得了令人瞩目的突破。大语言模型预测下一个token,视频生成模型预测下一段画面,具身模型预测下一个动作——这些本质上都是从海量数据中学习统计规律,并在当前状态下输出最可能发生的情况。
在潜空间中做预测是其中一个重要进步。以Yann LeCun提出的JEPA为代表,这类方法放弃逐像素重建,转而在抽象表征空间中预测缺失或未来的状态,让模型更专注于学习语义层面的结构性信息。
但预测做得再精准,始终有一条无法逾越的边界:它回答的是"接下来大概率会发生什么",而不是"为什么会发生这件事"。
这两个问题的差距,在数字世界里或许无关紧要——预测下一个词错了,重新生成就行。但在物理世界中,这种差距是结构性的。自动驾驶车辆遇到训练数据极少覆盖的路况,机械手面对形状和材质完全陌生的容器,机器人在长程任务中某一步偏离预期……在这些关键时刻,单纯依赖历史相关性的系统会显得相当脆弱。
仅靠预测的AI,至少会在四类场景中暴露短板:
哪些变量真正决定了结果?统计模型可能知道打雷和下雨常常同时出现,却未必能理解背后共同的成因是雷暴天气系统。
主动改变某个变量后,结果如何变化?普通预测模型只能在训练分布覆盖的范围内推断;面对从未出现过的干预情况,需要更强的结构性假设或因果模型支撑。
任务失败时,应该追溯哪个环节?缺乏因果链条时,系统往往只能察觉到状态偏离了预期,却难以判断根源究竟是感知误差、抓取接触问题、支撑关系异常,还是上游规划出了错。
环境改变时,哪些机制仍然成立?表面的相关关系很容易随环境变化而失效;而相对稳定的因果机制,才更有可能支撑跨环境的泛化能力。
Aether AI认为,仅在潜空间中预测状态变化,依然不够。面向真实世界的决策,模型还需要进一步识别具有稳定性的因果机制,并显式处理干预、反事实推断和环境变化等问题。
世界该如何被表示?行动又如何重写世界?
为了让这些想法落地,不妨从一个最基础的机器人任务说起:推杯子。
机器人看到桌上有一只杯子,目标是把它推到指定位置。对传统预测模型而言,它能从大量视频和运动轨迹中学到一种统计规律:机械臂向右移动,杯子大概率也会跟着往右移。但现实远比这复杂——杯子材质、杯底形状、桌面摩擦、接触角度、施力大小、杯内是否有液体、周围是否有遮挡物,所有这些因素都会影响最终结果。
机器人真正需要学习的,不是"下一帧杯子大概率在哪里",而是"哪些因素真正决定了杯子会怎样移动"。
Aether AI并没有在现有模型外部附加一个解释性的后处理模块,而是将因果能力拆解为三类基础问题:世界应该被表示为哪些变量;这些变量之间如何相互作用;当智能体采取某个行动时,整个变量系统将如何演化。
这三类问题,对应Aether AI技术路线中的三项核心能力:因果特征表示学习、因果结构发现和因果动力学建模。
因果特征表示学习:世界该被怎样表示
在推杯子的场景中,普通视觉模型会把画面压缩成一个高维嵌入向量,其中既包含杯子位置、桌面边界、机械臂姿态,也夹杂着杯子颜色、桌布纹理、光照变化等大量与任务无关的信息。
Aether AI更关注的问题是:模型能否在隐空间中分离出真正影响任务结果的变量?杯子当前位置、目标位置、接触点、桌面摩擦系数、杯子与机械臂的相对位置——这些才是规划动作时真正需要重点建模的因素;而杯子颜色、背景纹理,通常只是任务无关的噪声。
团队近期的TC-WM研究正是沿这一方向推进。它没有直接把视觉基础模型输出的高维嵌入作为最终状态空间,而是将其进一步压缩为紧凑的、任务充分的潜在动态空间——不单纯追求更强的视觉表征,而是寻找"足以表达任务,又不携带冗余信息"的任务中心动态表示。
论文:Back to Parsimonious Latents:Learning Task-Centric World Models from Visual Foundations
因果结构发现:变量之间谁影响谁
杯子最终移动了,原因可能是机械臂真正触碰到了它,也可能来自桌面倾斜、旁边物体的碰撞,或者杯子本身处于不稳定的支撑状态。如果模型只学习相关性,就可能把"机械臂靠近杯子"和"杯子移动"简单绑定,而没有理解真正产生作用的是接触、力传递和摩擦。
因果结构发现要解决的,正是从变量中识别真实的因果链条:哪些变量只是背景噪声,哪些会真正改变结果;哪些相关关系只在当前场景成立,哪些机制在环境变化后依然稳定。
这一步的理论根基来自结构因果模型——一个因果系统不只是变量的集合,而是变量之间生成机制的网络。关键不在于记录"动作A后经常出现状态B",而在于理解动作A改变了哪些潜在变量、这些变量又如何进一步推动了结果的变化。
因果动力学建模:行动之后世界如何演化
机器人每一次行动,本质上都是一次对世界的主动干预。推杯子不是被动观察,而是要改变世界。模型真正需要推演的是:从左侧轻推,杯子会怎样移动;从偏心位置用力推,杯子是否会旋转;桌面摩擦增大后,原来的动作还有效吗?
这也是Aether AI所说的因果世界模型与传统世界模型的核心差异:传统世界模型主要预测下一个状态;因果世界模型则进一步模拟不同干预方式会带来哪些不同的后果。
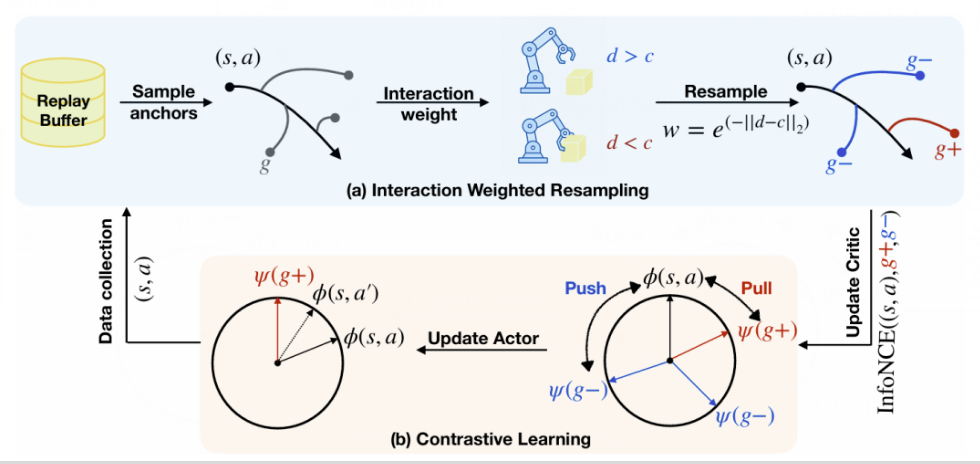
团队关于交互式物体操作的研究进一步说明了这一点。物体操作不是一条平滑连续的轨迹预测,接触、抓取、推动、释放等动作会让系统在不同动力学模式之间切换。如果模型忽略这些切换边界,就容易在真正需要施力和接触的阶段失效。
研究中提出的Interaction-weighted Resampling方法,通过对接触前、接触中、接触后等关键阶段进行针对性重采样,让模型更专注于动力学模式发生切换的位置。实验结果显示,在一组交互密集型仿真任务中,该方法相比现有表示学习方法平均提升性能19.8%;在部分交互稀疏或长程操作任务中,提升幅度超过50%。在真实机器人空气曲棍球实验中,使用该方法训练的策略将任务成功率从25%提升至60%。
这组数据说明一个重要结论:物理世界中的性能提升,不一定来自更多数据,而可能来自更有效地识别"哪些交互真正改变了结果"。
论文:Learning Object Manipulation from Scratch via Contrastive Interaction
团队的另一项Ada-Diffuser研究则关注决策过程中的隐藏影响因素,认为环境转移、奖励结构和行为策略都可能受这些隐藏因素左右。因此,决策模型不仅要判断"什么轨迹看起来合理",还要建模"哪些隐藏条件让这条轨迹成立"。
论文:Ada-Diffuser:Latent-Aware Adaptive Diffusion for Decision-Making
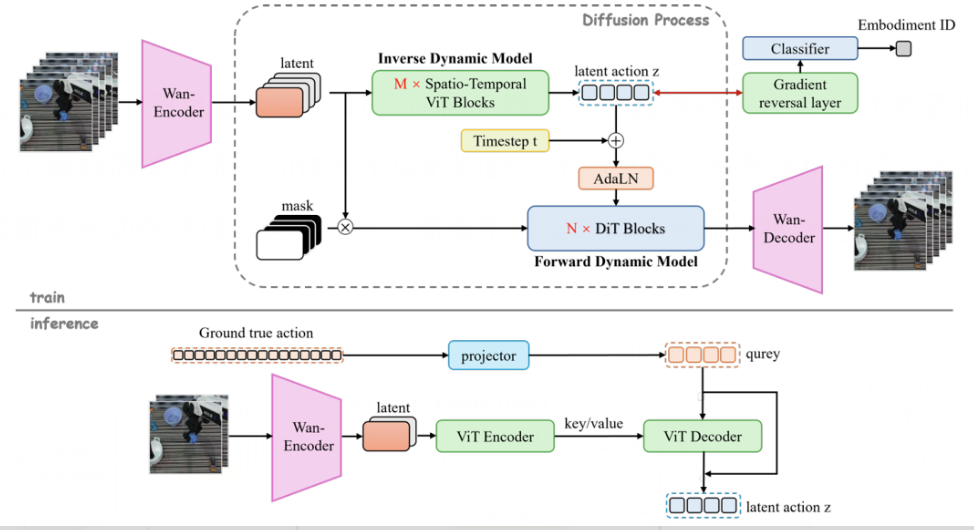
SCAR则将action本身视为一种独立的表征因素,学习的不是特定机器人硬件的原始控制指令,而是动作所造成的"可控变化"本身。这样,当模型迁移到不同机器人平台时,迁移的不只是具体控制命令,还有更抽象的动作效果表示——这也与团队关于统一动作表示层的判断一脉相承:不同机器人虽然结构各异,但如果能在抽象层面表达动作对世界造成的变化,就有望实现跨平台的迁移与泛化。
论文:SCAR:Self-Supervised Continuous Action Representation Learning
四层架构:让因果能力真正落入系统
在三类核心能力之上,Aether AI构建了一套四层架构,回答"这些能力如何整合进一个可运行的系统"。
如果说传统机器人学习架构主要是在"感知—规划—控制"的工程链路上做优化,Aether AI的四层架构想要重写的则是模型理解世界的底层方式:从学习相关性,转向识别因果变量;从记忆任务轨迹,转向拆解可复用机制;从预测下一状态,转向模拟干预后果;从失败后重试,转向定位根因并针对性恢复。
第一层:Causation Transformer
传统Transformer擅长学习统计依赖,回答的是"在已有数据中,什么通常和什么同时出现";Causation Transformer要进一步识别因果影响,判断"如果改变这里,结果是否会随之改变"。
第二层:模块化神经架构
传统模块化架构通常按工程流程拆分(感知、规划、控制);Aether AI的模块化则按机制拆分,把接触、支撑、重力、摩擦、动作影响等因果机制变成可复用、可组合、可迁移的独立模块。当环境、物体或机器人本体发生变化时,模型不必从零学习一条完整的新轨迹,而可以直接复用仍然成立的机制模块。
第三层:因果世界模型(核心层)
传统世界模型通常学习状态转移:给定当前状态和动作,预测下一状态。因果世界模型则进一步追问:动作改变了哪些因果变量,这些变量如何传导到最终结果,以及换一种干预方式又会发生什么。对机器人来说,这意味着模型不只是预测下一帧画面,而是在行动之前就能模拟世界将如何被改变。
团队关于任务充分世界模型的研究也印证了这一点:仅靠被动观察数据,很难判断哪些因素真正与任务相关;通过主动干预和环境课程,智能体可以收集更有信息价值的轨迹,逐步暴露与任务相关的潜在因素。
论文:Learning Task-Sufficient World Models via Intervention-Curriculum Co-Design
第四层:因果驱动智能体系统
传统Agent更依赖上下文记忆和任务序列,失败后往往只记录"哪一步没有完成",然后换一种动作重试。因果驱动智能体则把因果世界模型用于规划、归因、记忆和恢复全链路,能够判断失败究竟源自感知误差、动作偏差、环境变化,还是上游规划的决策错误。
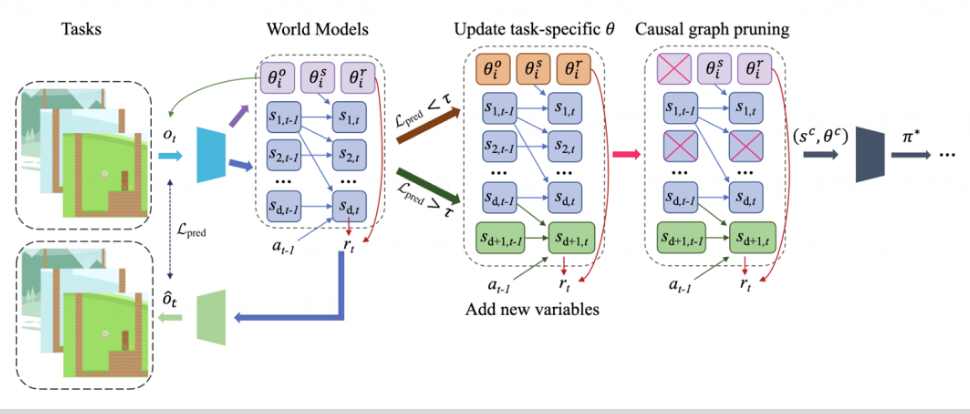
团队在因果表示强化学习方向的研究同样说明了这一点——让智能体学习潜在因果变量及其结构关系,从而判断环境变化到底是普通的分布偏移,还是状态、动作或任务空间本身发生了根本性变化。对于真实部署场景来说,这一能力至关重要:机器人不只是要在训练分布内表现良好,还要知道"变化发生在哪里",并用少量新数据完成快速适配。
论文:Towards Generalizable Reinforcement Learning via Causality-Guided Self-Adaptive Representations
Aether AI与JEPA:走向同一方向,但目标不同
Aether AI与JEPA的关系,可以放在这个框架下理解。两者都认为AI不应停留在像素级重建,而应在更抽象的表征空间中建模世界。区别在于,JEPA主要解决的是从像素重建到表征预测的问题;Aether AI则想继续向前推进,把表征预测进一步延伸至因果干预。
团队也明确指出,Aether AI并不会完全去掉pixel decoder,而是保留有意义的解码路径;更重要的是,Aether AI尝试在隐空间中显式分离因果变量,并学习变量之间的因果结构——这是两条路线在技术取向上最核心的差异所在。
Aether AI的目标,从来不是让AI更会"预测",而是让AI真正学会"如何干预"。这或许是从统计智能走向机制智能,最关键的一步。
 AI 速览