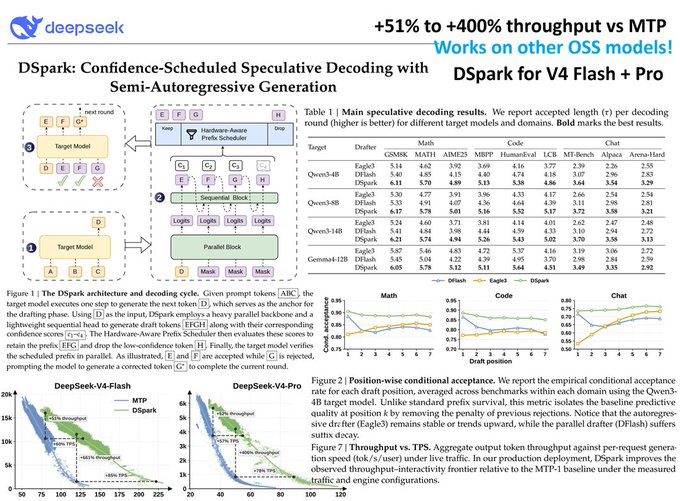
6月29日消息,DeepSeek联合北京大学发布推理加速框架DSpark,已部署至DeepSeek-V4 Flash和Pro的线上真实流量中,用户端生成速度最高提升85%。同步开源全栈训练与评估代码库DeepSpec,采用MIT协议,内置DSpark、DFlash和Eagle3三种草稿模型算法,覆盖数据准备、多GPU训练和跨9个benchmark的评估全流程。这不是新模型,而是一项纯工程优化——在不改变模型权重、不增加硬件的条件下,通过改进推理管线实现大幅提速。 DSpark核心机制:半自回归+置信度调度
投机解码的基本思路是引入一个轻量级"草稿模型"预生成多个候选token,再由目标模型批量验证并接受或拒绝,将逐token的串行生成转换为并行批量验证。传统方案存在两个瓶颈:纯并行草稿在后续位置的接受率快速衰减,以及高负载时盲目验证低置信度token浪费GPU算力。
DSpark用两项创新解决这两个问题。第一项是半自回归生成架构:用重型并行骨干快速生成块级候选token,再叠加一个轻量级顺序Markov头注入局部token依赖信息。Markov头采用rank-256低秩分解保持计算轻量,当前一位置采样出某个token后,它会提升后续位置中高概率跟随token的条件概率,减缓后缀衰减。论文中还描述了一个可选的RNN头用于跟踪完整块前缀历史,但实测仅带来边际提升,因此Markov头作为默认配置发布。
与传统投机解码从零训练独立草稿模型不同,DSpark将投机头直接嫁接到目标模型上。对于已内置MTP(多token预测)头的模型如DeepSeek-V3和部分Qwen变体,DSpark本质上是"免费加速"——投机头复用了MTP已经计算的输出,两者互补而非替代关系。
第二项是置信度调度验证:DSpark引入置信度头评估每个草稿token被目标模型接受的概率,结合硬件感知的前缀调度器,根据系统实时负载动态调整每次请求的验证长度。负载轻时验证更多token,负载重时只验证高置信度前缀,避免浪费批处理算力。
实测数据:速度、吞吐与分场景表现
DSpark的线上部署配置为DSpark-5,使用5-token草稿块搭配Markov头。在V4-Flash上用户生成速度提升60%-85%,在V4-Pro上提升57%-78%,对比基线为此前的MTP-1方案,且整体系统吞吐量保持不变。相比Eagle3和DFlash,DSpark的平均接受长度提升16.3%至30.9%。
在不同并发水平下,吞吐量提升幅度从51%到400%不等,高并发场景下收益最为显著。按任务类型看,代码生成场景的接受率天然较高,调度器可验证更长前缀,编程代理输出流速提升最大。开放式对话场景中,置信度阈值扫描将接受率从45.7%提升至95.7%。数学推理介于两者之间,接受率从76.9%提升至92.5%。高并发服务是核心场景:中等负载下调度器每次请求验证约4-6个token,并发上升时自动收缩验证预算以保护吞吐。
论文由DeepSeek创始人梁文锋与北大研究者联合署名。
DeepSpec开源工具链与跨模型迁移
DeepSpec不只是推理工具,而是完整的训练基础设施。它包含三阶段流水线:数据准备、多GPU草稿模型训练和评估,覆盖GSM8K、MATH500、HumanEval、LiveCodeBench等9个benchmark。代码库内置DSpark、DFlash和Eagle3三种算法,目标模型家族覆盖Qwen3和Gemma。
这意味着开发者可以针对自己的部署场景训练定制草稿模型,而非依赖DeepSeek发布的预训练权重。社区已验证(Unsloth的Daniel Han确认)DSpark在Qwen3和Gemma目标模型上均可正常训练,说明其方法论不限于DeepSeek自有模型体系。
默认训练配置需要单节点8 GPU,使用方式为指定config路径选择算法和目标模型(如config/dspark/dspark_qwen3_4b.py),GPU数量不足时可通过CUDA_VISIBLE_DEVICES缩减。对于仅做推理部署的用户,草稿模块直接附加到现有V4权重上,Hugging Face模型卡中包含最小化推理示例,无需重训目标模型。
行业竞争与开源意义
OpenAI和Anthropic在各自的生产服务栈中部署了投机解码或类似加速架构,但均未开源其完整推理工具链。DeepSpec的MIT许可发布将可复现、可审计的工程实现交到了更广泛的研究社区手中——特别是那些基于Qwen3和Gemma构建、本身不在DeepSeek模型生态内的团队。
中国AI实验室不仅在模型排名上竞争,还在持续发布底层系统工程成果——推理、部署、内存管理和服务效率。DSpark延续了DeepSeek在工程优化上的一贯路线:V3时期的MLA注意力优化、V4的MoE效率推进,到现在的推理管线提速。每一步都不改变模型能力本身,但实质性降低了使用成本。
局限与风险
首先明确DSpark不是模型能力升级:Hugging Face上的模型卡明确标注DSpark版本使用与原V4完全相同的checkpoint,仅附加了草稿解码模块,不会让V4变得更"聪明"。
其次,高倍数吞吐提升依赖特定条件:400%的极端数字出现在严格SLA约束的高并发场景下,日常使用中51%-52%的聚合吞吐提升和60%-85%的用户端提速是更具代表性的数据。
第三,自建训练的存储门槛不低:DeepSpec训练流程的目标缓存需要约38TB存储空间,默认需要单节点8 GPU——这一要求仅针对训练草稿模型,推理部署本身无此限制,但仍将部分中小团队挡在门外。此外论文发布仅三天,开源实现仍在落地初期,建议观察GitHub issues一周并在自有流量上benchmark后再考虑生产环境变更。
 AI 速览