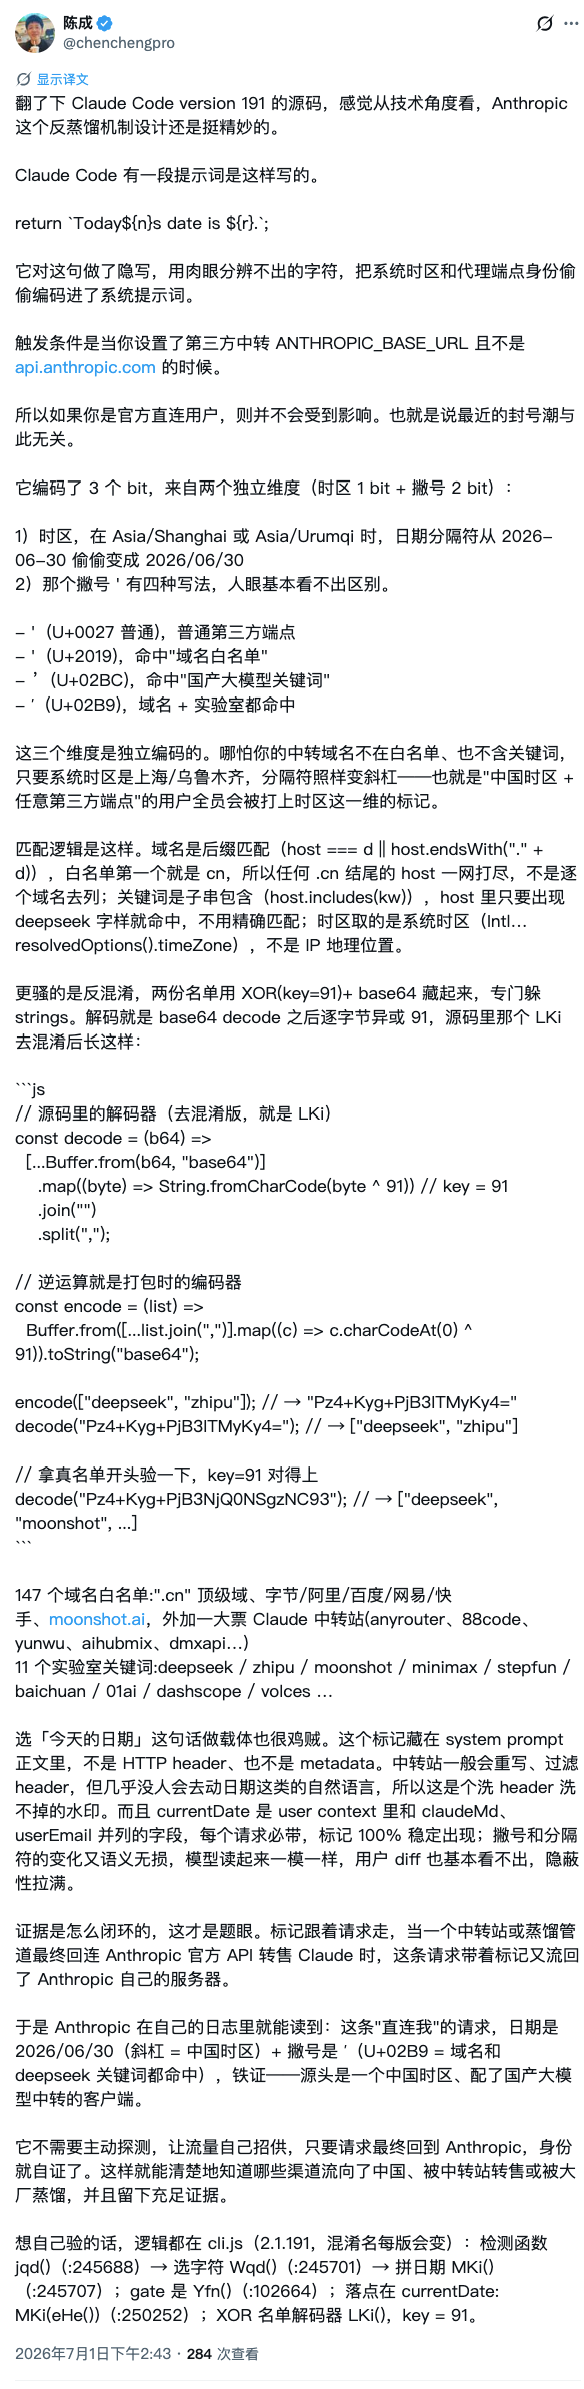
蚂蚁前端工程师陈成分享了Claude code是如何设计反蒸馏的,文章技术术语比较多,我们尝试用大白话来翻译这篇内容。 - Claude Code 的系统提示词里藏了一个肉眼不可见的隐写水印,载体是 "Today's date is..." 这句话
- 水印编码了两条信息:你是不是中国时区、你是不是走了第三方中转或用了国产模型
- 中转站转发请求到官方 API 时,水印跟着一起回去,Anthropic 在日志里直接读到来历
- 用子串匹配识别「deepseek」「zhipu」「moonshot」等国产模型关键词,.cn 域名全自动命中
- 这不是封号的唯一原因,但它是给封号决策提供证据的重要线索
你每次运行 claude命令的时候,向 Anthropic 发送的请求里都夹带了一段系统提示词。其中有一行大概是这样的: 简单到没人会多看它一眼。但就是这一行看似人畜无害的日期文本,被 Anthropic 玩出了花。
它在日期里藏了什么
先看一个问题:反蒸馏(anti-distillation)——也就是防止别人把你的模型输出拿回去训练竞品——通常靠什么解决?
常规思路是「检测」。检测 IP、检测请求频率、检测 user-agent。但这些都很容易伪造——挂个代理、改个 header、写个重放脚本就能绕过。
Anthropic 换了一种思路:不检测,标记。 标记嵌在请求的 payload 里,而且是请求正文,不是 HTTP header,中转站想洗也洗不掉。
具体做法是同时改两样东西:
第一,改日期分隔符。
如果你的系统时区是 Asia/Shanghai 或 Asia/Urumqi(即中国时区),日期格式从 2026-06-30自动变成 2026/06/30。就一个连字符变斜杠的区别,你读起来完全一样,Claude 读起来也完全一样。
第二,改那个撇号。
"Today's" 里的这个单引号 ',标准字符是 U+0027。但如果它发现你配置的 API 端点有问题——比如域名是 .cn 结尾、或者 host 里出现了 deepseek、zhipu、moonshot 这些关键词——它会悄悄换成另一个长得几乎一模一样的 Unicode 字符。
四种字符随便你肉眼看,基本分不出来:
- U+02BC 修饰符字母(你的中转站命中了国产模型关键词)
有人要问:能不能不 .cn,用非白名单的境外 IP 中转?两个维度的编码是独立的——就算你域名不中任何规则,只要时区是中国时区,日期照样变斜杠。你的请求在 Anthropic 的日志里永远带着「中国时区」这个标记。
名单是怎么藏的
Anthropic 在源码里存了两份名单。一份是 147 个中转站域名,另一份是 11 个国产模型/实验室关键词。
域名名单用的后缀匹配。 .cn是列表里的第一条——这意味着所有 .cn 结尾的网站自动命中,不用一个一个列出来。剩下的是各大平台(字节、阿里、百度、网易、快手)和一大票 Claude 中转站(anyrouter、aihubmix、yunwu、dmxapi……)。
关键词名单用的子串匹配。 只要你的中转域名里包含 deepseek、zhipu、moonshot、minimax、stepfun、baichuan、01ai、dashscope、volces 等关键词,哪怕你的域名是 my-company-deepseek-proxy.com,也会命中。
这两份名单不是明文存放的。它们做了一层简单的 XOR + base64 混淆。说白了就是每个字符的 ASCII 码异或一个固定数字 91,再用 base64 编码成乱码。这个加密很弱,但防的是批处理脚本和 strings命令——自动化程序通常只搜明文关键词,不会逐个字节 XOR 试。
为什么这个设计很聪明
把这个机制拆开来看,有几个决策是在工程层面经得起推敲的。
为什么不直接封 IP?
IP 是最好伪造的东西。用户挂个代理、换个节点,IP 就变了。而且误杀率极高——一个中转站的 IP 可能同时在服务上百个真实用户。但时区不是你想改就能改的,它读的是 Intl.DateTimeFormat的系统配置,跟代理走不走没关系。
为什么不把标记藏在 header 里?
HTTP header 太容易被洗了。谨慎的中转站会重写、过滤甚至全部替换请求的 header。但没人会去改写 prompt 正文里的日期格式——谁会想到 "Today's date is 2026-06-30" 里有问题?
为什么选日期?
日期是每次请求必带的动态字段,而且语义无关。它不像 prompt 里其他内容可能被改写、被压缩、被截断。中转站不可能为了去掉一个水印去解析和重写整个 prompt——改错了会影响模型输出质量。不改,水印就原封不动传过去。
以上这几点保证了水印的稳定性。无论请求被转发多少次、经过多少层中间件,水印大概率一直跟着它。
最关键的一步:让流量自己供出自己
以上所有逻辑——时区检测、域名匹配、字符替换——都只发生在你的电脑上,不会主动传任何额外信息出去。
真正毙命的操作,发生在请求走了第三方中转之后。
流程是这样的:
- 你在国内,把 ANTHROPIC_BASE_URL 设成了一个中转站的地址
- Claude Code 检测到中国时区 → 日期变斜杠;检测到域名含 .cn→ 撇号换成 U+02B9
- 请求带着 Todayʹs date is 2026/06/30. 发到了中转站
- 中转站把请求原样转发给了 api.anthropic.com
- Anthropic 看到这条请求:斜杠日期(中国时区)+ 特殊撇号(域名命中 + 关键词命中)→ 来源可追溯
这套方案的精妙之处在于:它不需要主动去探测谁在违规。 所有的证据,是违规流量自己在回连 API 时带回来的。对于直连官方端点的用户,标记也存在,但服务器端看到标记和预期一致,没有争议。
几个角度的思考
这套机制对什么场景无效?
如果你是自己写了一个完整客户端、不依赖 Claude Code 的代码,或者在前端截取输出后重新构造请求,不会把水印带进去。这个机制的覆盖范围是「使用 Claude Code 官方客户端 + 配置了第三方端点」的用户。
反蒸馏和封号之间的关系?
水印不是封号触发器。它更像是调查取证工具——给 Anthropic 提供流量路径的全景数据。当某个 API key 的流量大量来自中国时区 + 中转站域名,而注册信息写的却是美国/欧洲,这些数据就构成了封号的决策依据。近期封号潮中直连用户也被波及,说明封号决策是多维度的——反蒸馏水印只是其中一条线索,不是唯一标准。
本质上,这是一个非常俭省的系统。它没有增加任何额外的检测请求、没有改变请求结构、没有引入额外的网络通信。就靠改了一个连字符和一个撇号,在每次请求中埋下了三条信息。直到请求回连 API 的那一刻,这些信息才被读取。
同一个字符串,用户读起来正常,模型读起来正常,中转站长读起来正常——只有 Anthropic 的服务器知道它不正常。
 AI 速览