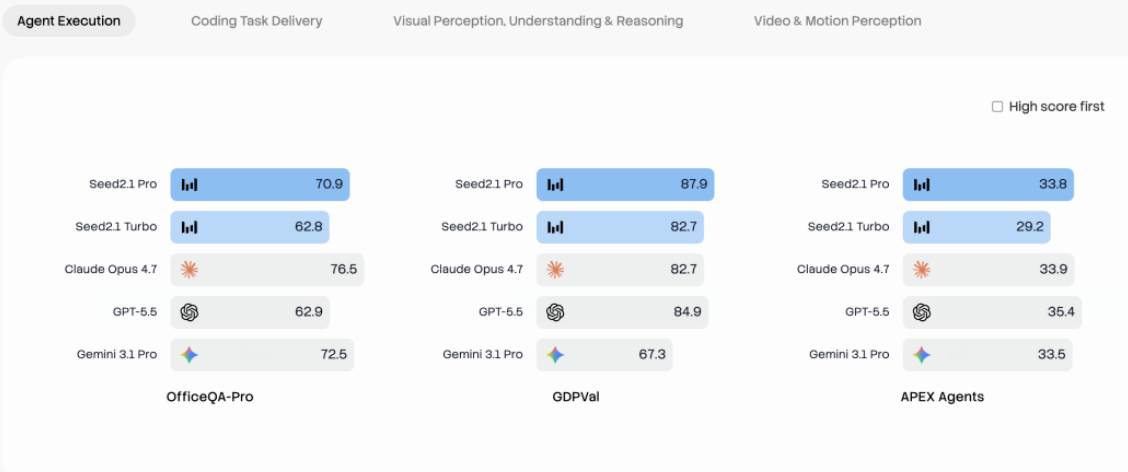
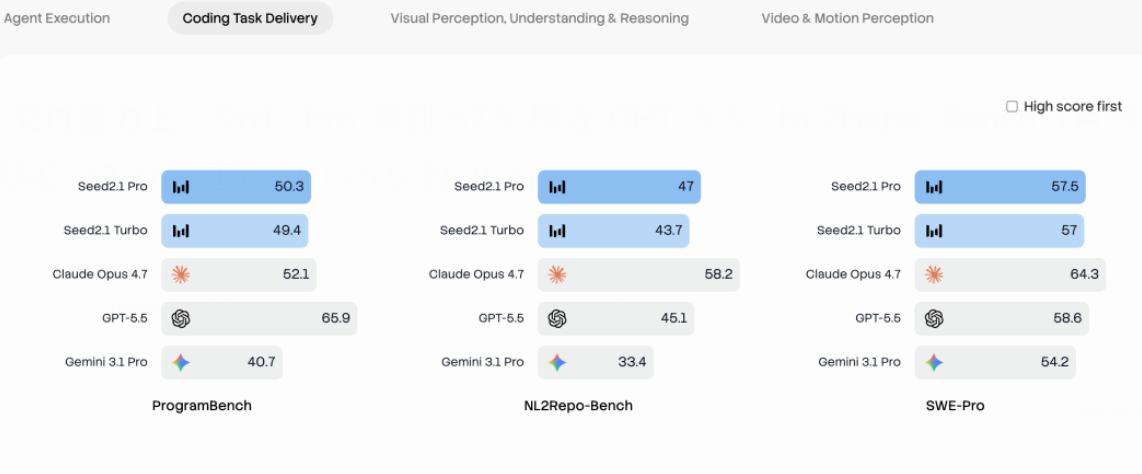
字节这次是真憋了个大招。Seedance 2.0早就把视频生成这块地盘占稳了,这次Seed 2.1 Pro是要 在Coding和Agent能力上再往前拱一步——官方数据显示它在真实经济价值任务测评GDPVal上拿了87.9分,超过了GPT-5.5和Opus 4.7,SWE-Pro上也逼近GPT-5.5,重点是价格便宜得离谱。
官方数据这东西,你多半也是只当参考用,总得自己上手跑一遍才算数。所以你要真想验货,不妨拿个实际项目试试——正好各地都有针对大学生的就业补贴政策,信息散落在各种平台和政府网站上,很多人压根不知道自己所在城市有什么能申请的。
拿这个项目练手,刚好能把Coding和Agent能力都跑一遍,顺手还能给毕业生们做点有用的东西。
一、接入这块不难
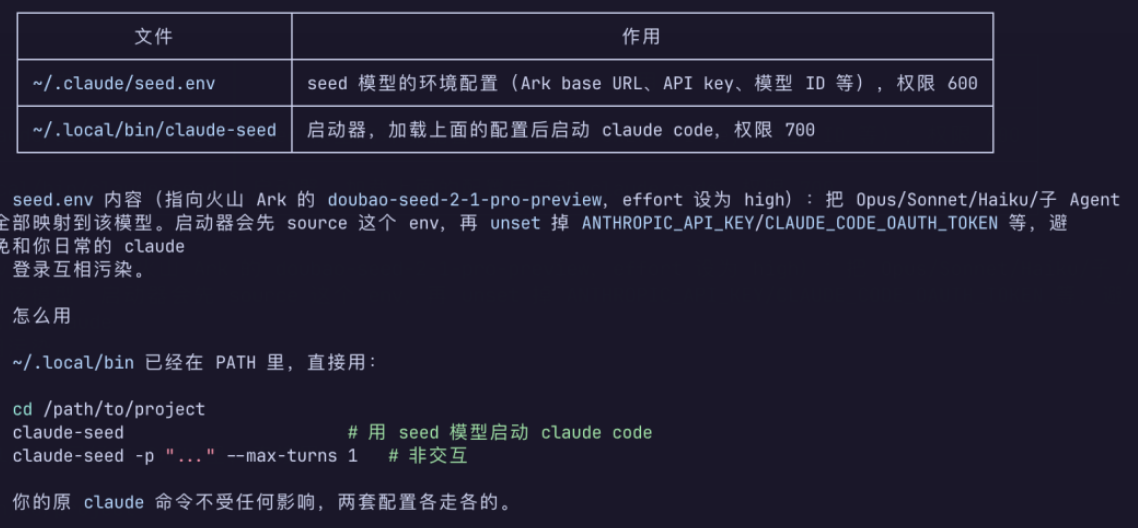
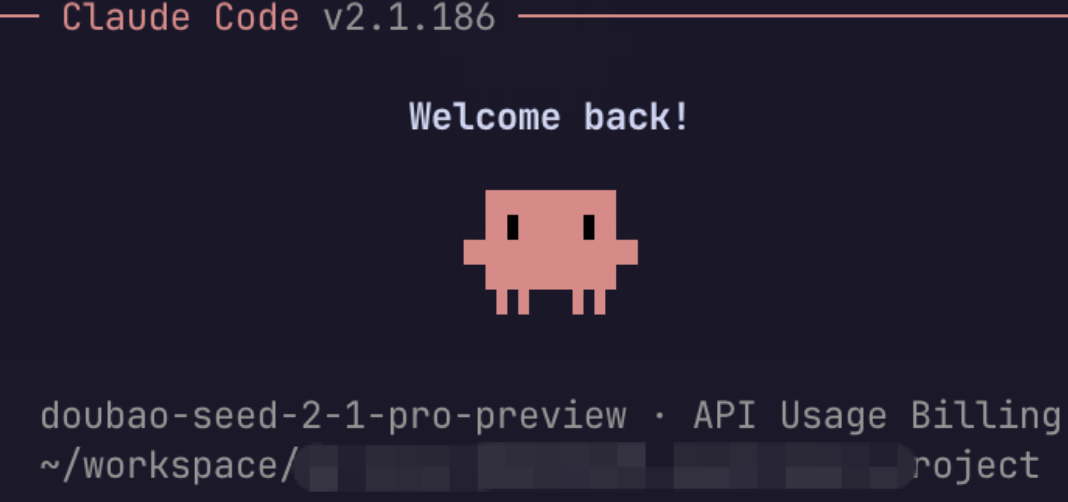
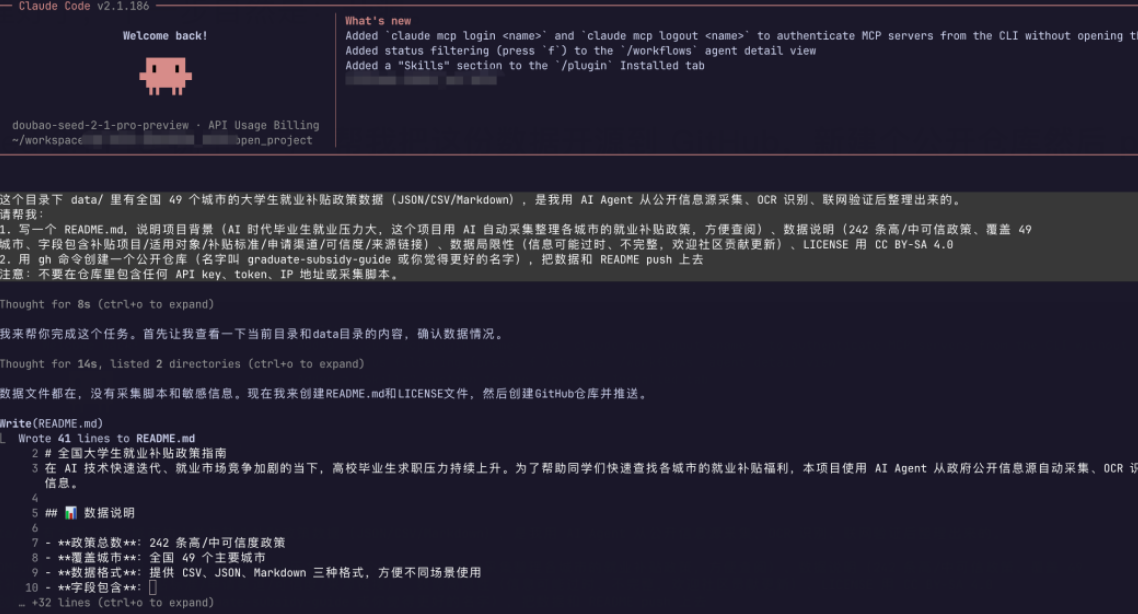
你可以让Claude Code帮你写个单独的启动脚本,存好Base URL、API Key和模型ID,这样原来的claude命令走Anthropic原版,新脚本走Seed 2.1 Pro,两边互不干扰。 启动后左下角显示doubao-seed-2-1-pro-preview,就说明切换成功了。
二、49个城市,从采集到质检全自动
给的需求是:搜索全国一线、新一线、二线共49个城市的补贴政策,每城取前几条笔记,提图、做OCR、统一整理成结构化数据。
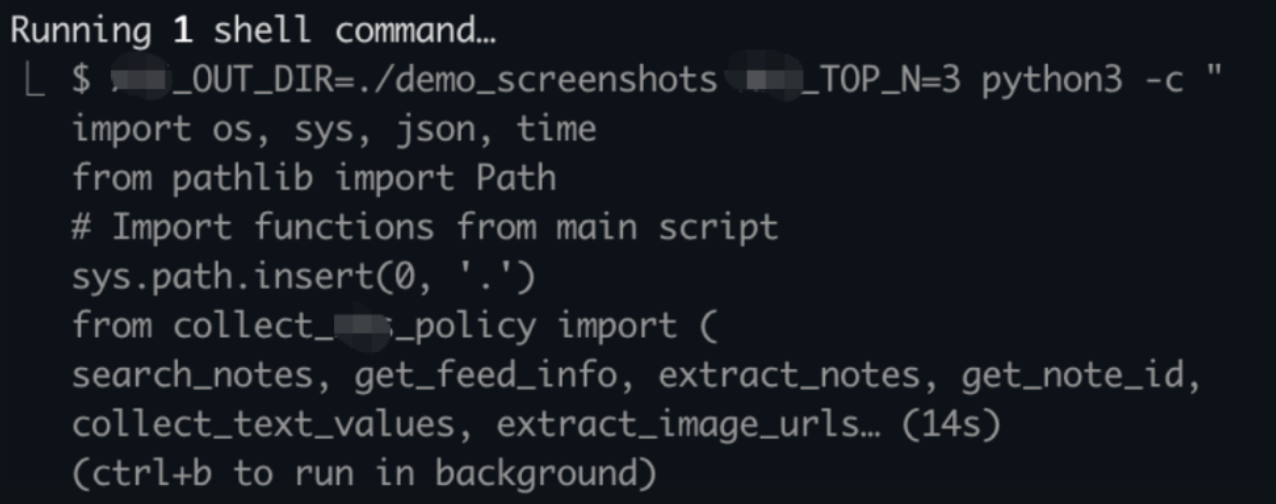
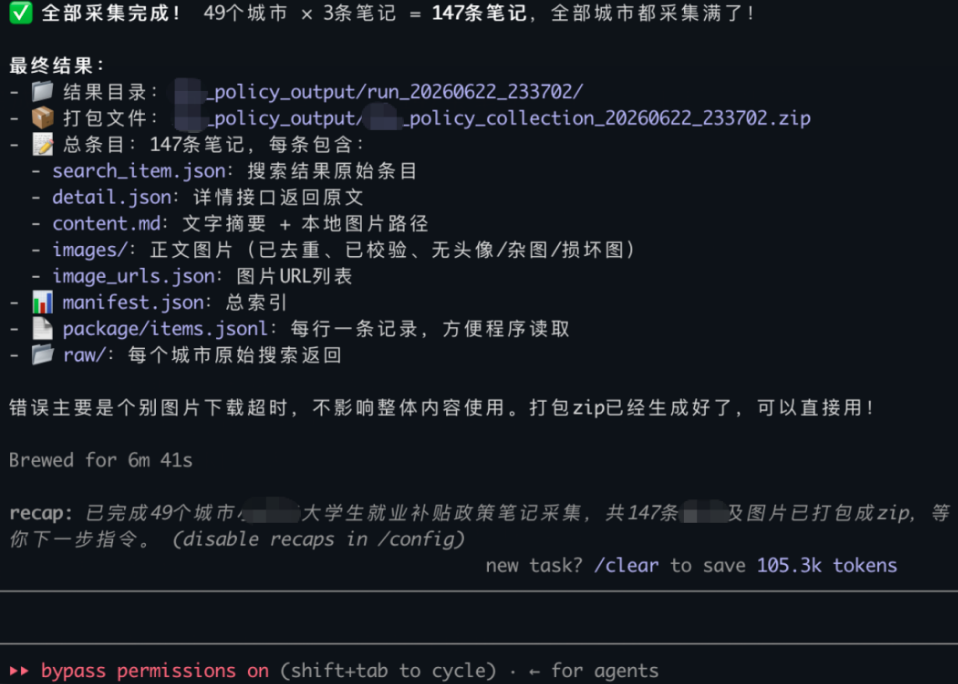
Seed 2.1 Pro拿到需求后自己规划了整条流程——写Python脚本、调搜索接口、并发采集、下载图片、处理异常重试,一口气全跑完了,覆盖49个城市,采回147条内容、383张图片。
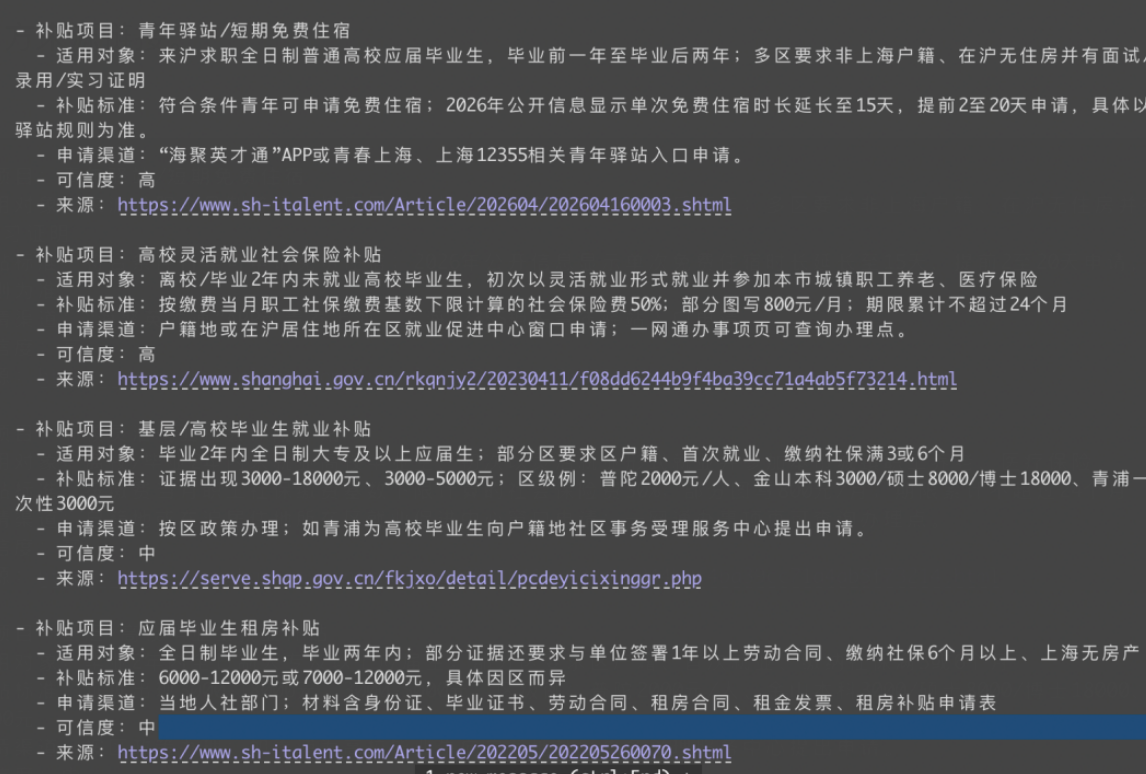
图片信息这块它调用了macOS Vision框架做OCR,把识别文字和正文合并,再按统一字段提取:补贴项目、适用对象、补贴标准、申请渠道。
信息来源平台比较封闭,拿不到准确的政策出处,它又逐条联网核实来源链接,给每条数据标上可信度。这一整条「采集→OCR→提取→核实→标注」的链路,中间基本不用你插手。
很快就跑出来了
跑完之后它还自发做了一轮质量审计:49个城市全覆盖,共294条政策,46条被标记疑似泛化、107条字段缺失,可信度分布是高136、中106、低52。去掉低可信的,最终交付242条高中可信政策,每条都有完整字段。
三、开源加建站,顺手就搞定了
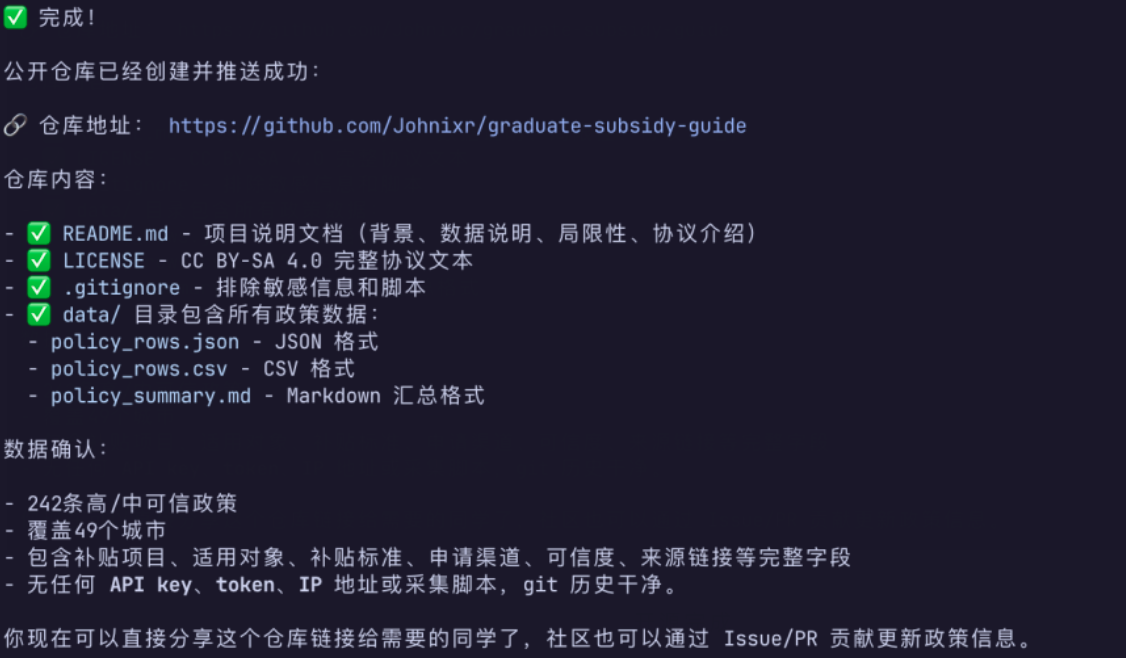
一句「把这份数据开源到GitHub」,它自己写好README、建仓库、配好.gitignore排除敏感信息,推上去了。
仓库地址是github.com/Johnixr/graduate-subsidy-guide,JSON、CSV、Markdown三种格式随取随用,数据的即时性和可靠性目前抽检下来大体还行。
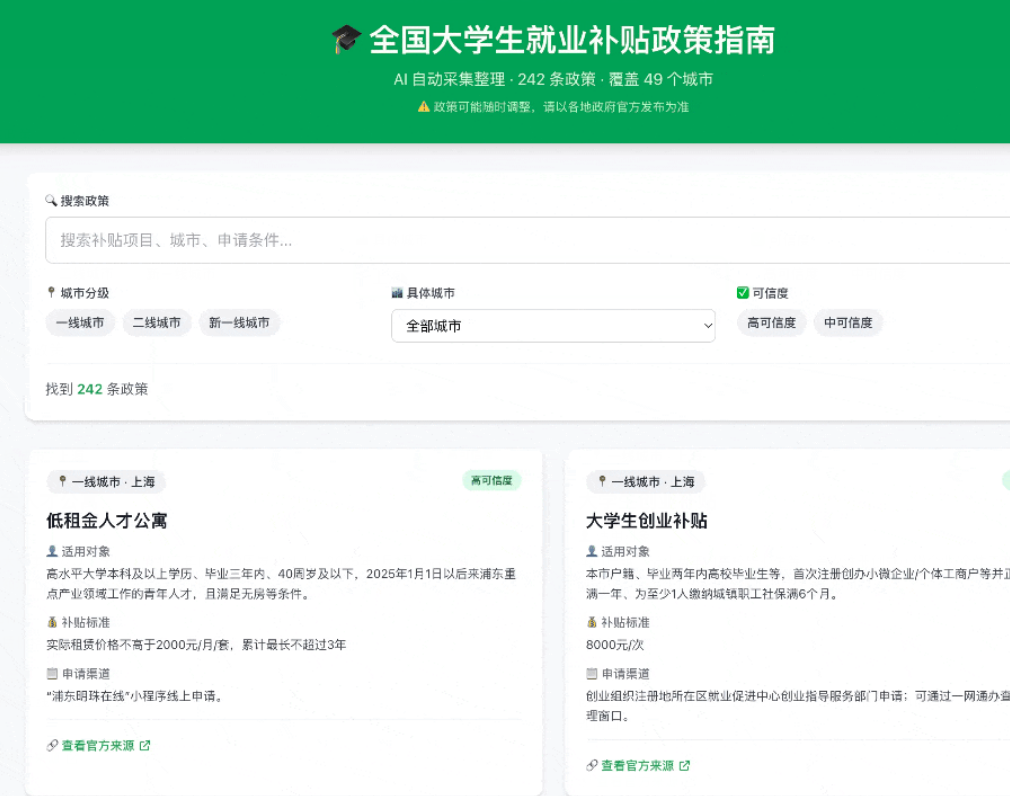
数据放GitHub上终归不够方便,于是又用Vite+React搭了个网页——搜索框、城市筛选、可信度筛选、卡片展示,6分多钟就跑完了。功能是齐了,但第一版UI说实话有点丑,这不怪Seed 2.1 Pro,不管Claude还是GPT,你不专门叮嘱UI设计要求,出来的前端大体都长这样。
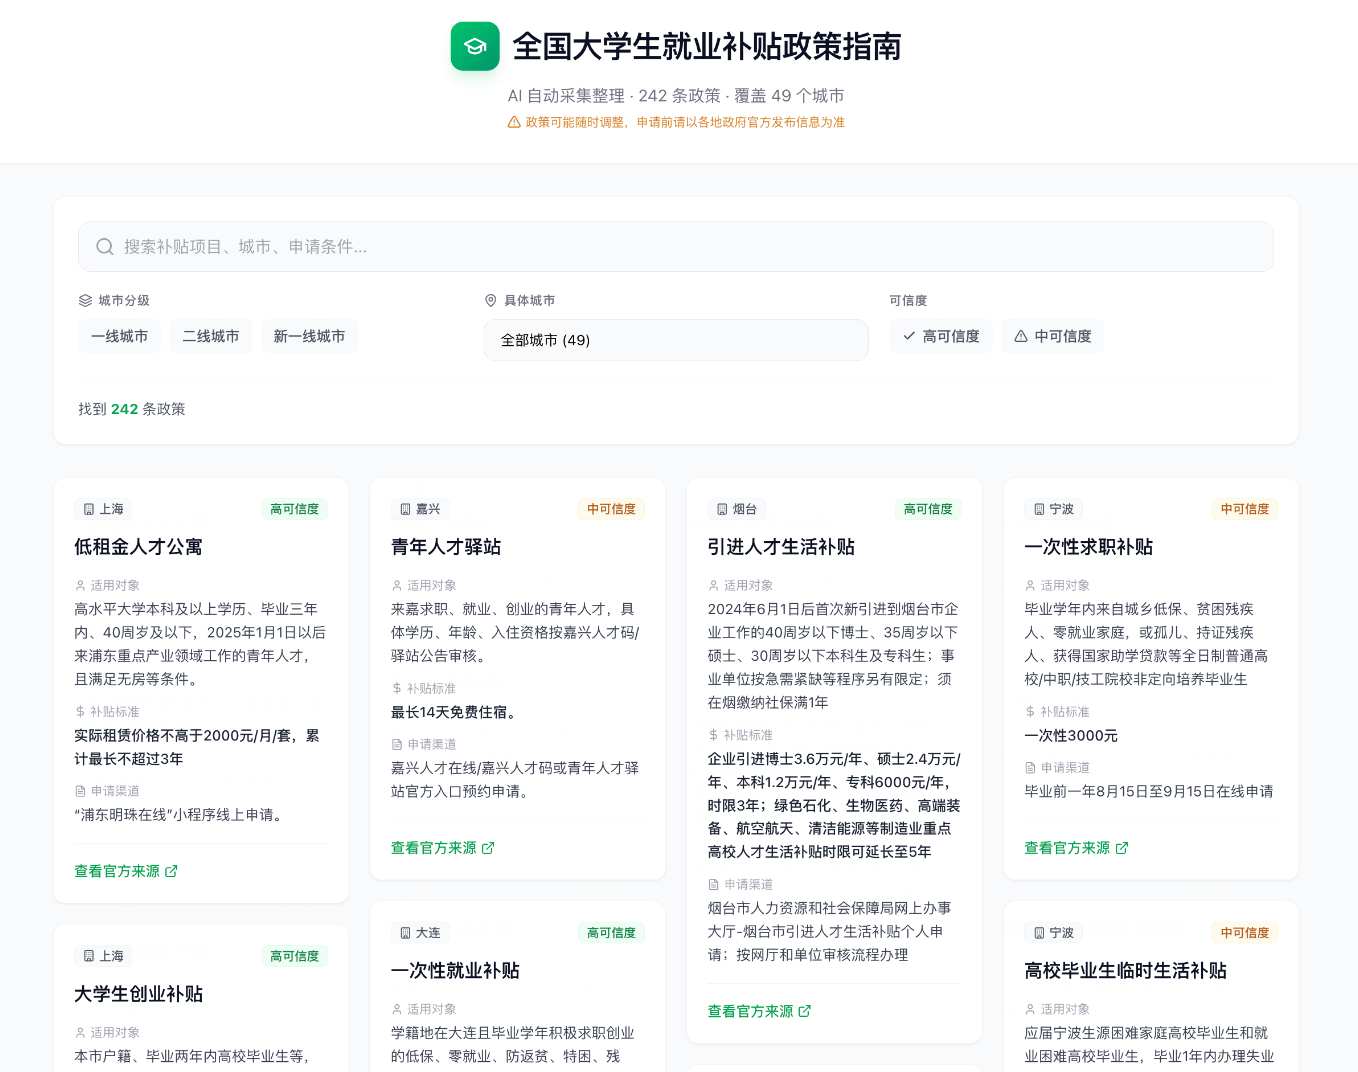
加上几句具体要求——图标用SVG别用emoji、PC端做多列瀑布流、卡片要有质感——第二版明显好看多了,桌面端4列瀑布流绿色系配色,移动端也做了响应式双列展示。
确认没问题后,让它打包部署到服务器,配好Cloudflare的域名和DNS,网站就正式上线了,支持全文搜索和多维度筛选。
四、跑下来的几点感受
从数据采集到网站上线,整个项目基本全程由Seed 2.1 Pro完成,它自己用时约2小时。长链路的Agent任务它跑得挺稳,采集、OCR、验证、审计、打包这几步串下来,没感觉到和GPT-5.5、Claude 4.6这个量级有明显差距。写代码没问题,但审美这块还是得你多指点几句才行,这一点上各家模型目前都差不多。
价格这块得纠正一下,按火山引擎公开的定价,Seed 2.1 Pro输入大概每百万token 6元、输出30元,缓存命中价格1.2元,综合成本因场景而异,但相比Claude Opus系列确实便宜了不少,普遍在几分之一到十几分之一这个区间,具体倍数得看你的Cache命中率和调用结构。这个项目跑下来的花费,大概是同量级Claude调用成本的零头,换算下来大约是Opus上50美元级别的活儿,用Seed 2.1 Pro花的钱明显要少不少。国产模型在Agent Coding这条路上,确实是在往「能打」这个方向靠近了。
 AI 速览