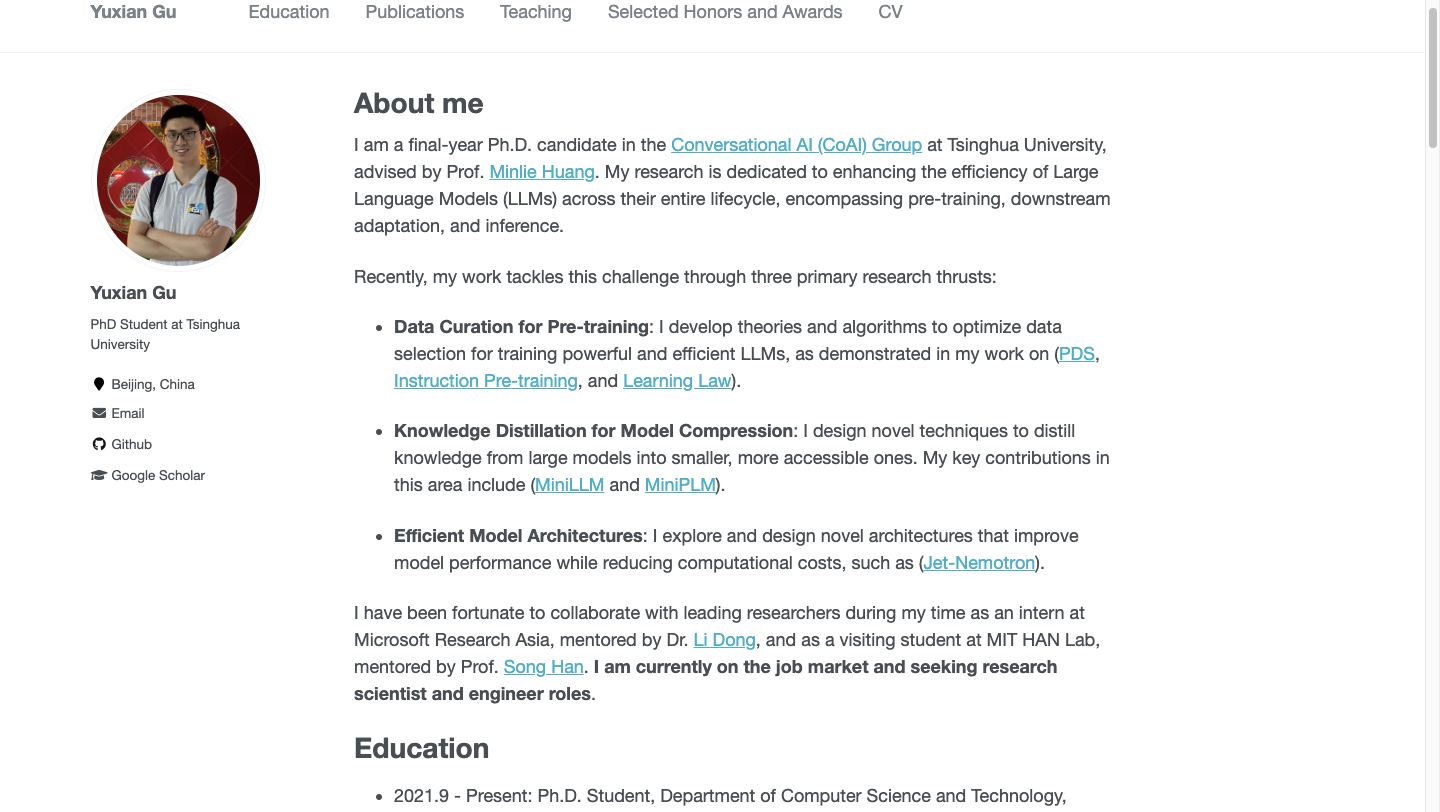
7月6日消息,据报道清华大学 2021 级博士生、2025 年研究生特等奖学金获得者顾煜贤已正式加入 DeepSeek。他的名字此前已出现在 DeepSeek V4 的论文作者列表中,这意味着他在正式入职前或入职初期已参与了 V4 的研发。顾煜贤的研究方向覆盖大模型高效训练、知识蒸馏和高效架构设计,与 DeepSeek 一贯的"在硬件约束下通过算法创新突破效率瓶颈"的技术路线高度契合。此次加入正值 DeepSeek 大规模扩招、V4 正式版即将于 7 月中旬上线之际。 特等奖学金、苹果学者、近 5000 次引用
顾煜贤本科和博士均在清华大学计算机系完成,博士阶段师从黄民烈教授,隶属交互式人工智能课题组(CoAI)。除 2025 年清华研究生特等奖学金外,他还获得了 2025 年苹果博士奖学金和蚂蚁 In-Tech 奖学金。Google Scholar 显示其论文引用量已接近 5000 次,超过 1000 次引用的论文有两篇,分别是《Pre-trained Models: Past, Present and Future》和《MiniLLM: Knowledge Distillation of Large Language Models》。
他在 ACL、EMNLP、ICLR 等会议上发表了近 20 篇论文。其中,关于预训练数据选择的论文 PDS(Data Selection via Optimal Control)入选 ICLR 2025 Oral(录取率 1.8%),该工作在微软亚洲研究院实习期间完成。更早的 ACL 2022 论文 PPT(Pre-Trained Prompt Tuning)在当届全部 700 余篇录用论文中引用量排名前十。
研究方向与 DeepSeek 的效率优先路线直接对应
顾煜贤的研究聚焦于大语言模型全生命周期的效率提升,涵盖三个方向。预训练数据筛选方面,PDS 框架将数据选择建模为最优控制问题,通过理论推导而非经验试错来确定训练数据的最优组合。模型压缩方面,MiniLLM 用反向 KL 散度替代传统正向 KL 散度目标进行知识蒸馏,使小模型在指令跟随任务中的表现显著优于基线方法。高效架构方面,Jet-Nemotron 探索了在降低计算成本的同时提升模型性能的新架构设计。
他曾公开表示:"硬件资源受限时,算法创新就成为突破计算瓶颈的关键。"这一理念与 DeepSeek 的核心技术路线一致——从 V2 的 MoE 架构到 V3 的 557 万美元训练成本,再到 V4 的持续效率优化,DeepSeek 始终将"在有限硬件条件下最大化模型能力"作为核心策略。顾煜贤在预训练数据优化和模型压缩方面的积累,对 DeepSeek 持续降低训练和推理成本有直接价值。
值得关注的不是个案,而是 DeepSeek 对顶尖学术人才的吸引力
顾煜贤加入 DeepSeek 的背景是这家公司正在进行大规模招聘,岗位涉及算法、研发、产品、运维、数据工程和职能等多个部门。作为一家未公开过融资信息的公司,DeepSeek 能够持续吸引清华特奖级别的顶尖博士毕业生,反映的是其技术声誉在学术界的认可度。在中国 AI 人才市场上,顶尖博士毕业生的流向通常集中在头部互联网公司 AI 实验室、外资研究机构在华团队和少数明星创业公司之间。DeepSeek 凭借 V2 和 V3 积累的技术口碑,正在成为这一竞争中的高优先级选项。
但单个人才的加入对公司研发能力的直接影响不应被夸大。大模型的研发是高度系统化的工程,个体贡献嵌入在团队协作和基础设施之中。顾煜贤出现在 V4 论文作者列表中,说明他已经在这一体系内产出了贡献,但 V4 是一个大型团队的集体成果。
V4 正式版上线后可观察人才策略的实际产出
DeepSeek V4 正式版预计 7 月中旬上线,这次发布伴随着公司历史上最大规模的一轮招聘。顾煜贤的加入是这轮人才扩张中可见度最高的信号之一。V4 正式版的实际表现——尤其是在训练效率和推理成本控制方面是否延续了 V3 的成本优势——将是检验 DeepSeek 当前人才和技术积累最直接的窗口。
 AI 速览